专用模型推理三层配置:端点、部署、配置项与按容量路由的完整拆解
一句话结论
把端点当身份、部署当可抛弃的工作单元、配置当不可变的配方,让路由跟随容量而不是固定百分比——这套模型把 AI 推理服务的 A/B 测试、影子实验、零停机变更全部统一成一个动作:加一个部署、分配一个流量权重。
三层资源模型
- **配置(config)**是运行配方:指定引擎、GPU 类型和数量、并行度与优化档(吞吐/延迟/均衡)。配置不可变,每个有
cr_...形式的 ID。部署永远指向经过测试的那个确切配置。 - **部署(deployment)**把一个模型(特定版本)绑定到一个配置,附上自动扩缩策略并运行副本。部署被设计成可抛弃的,创建和销毁应视为常规操作。
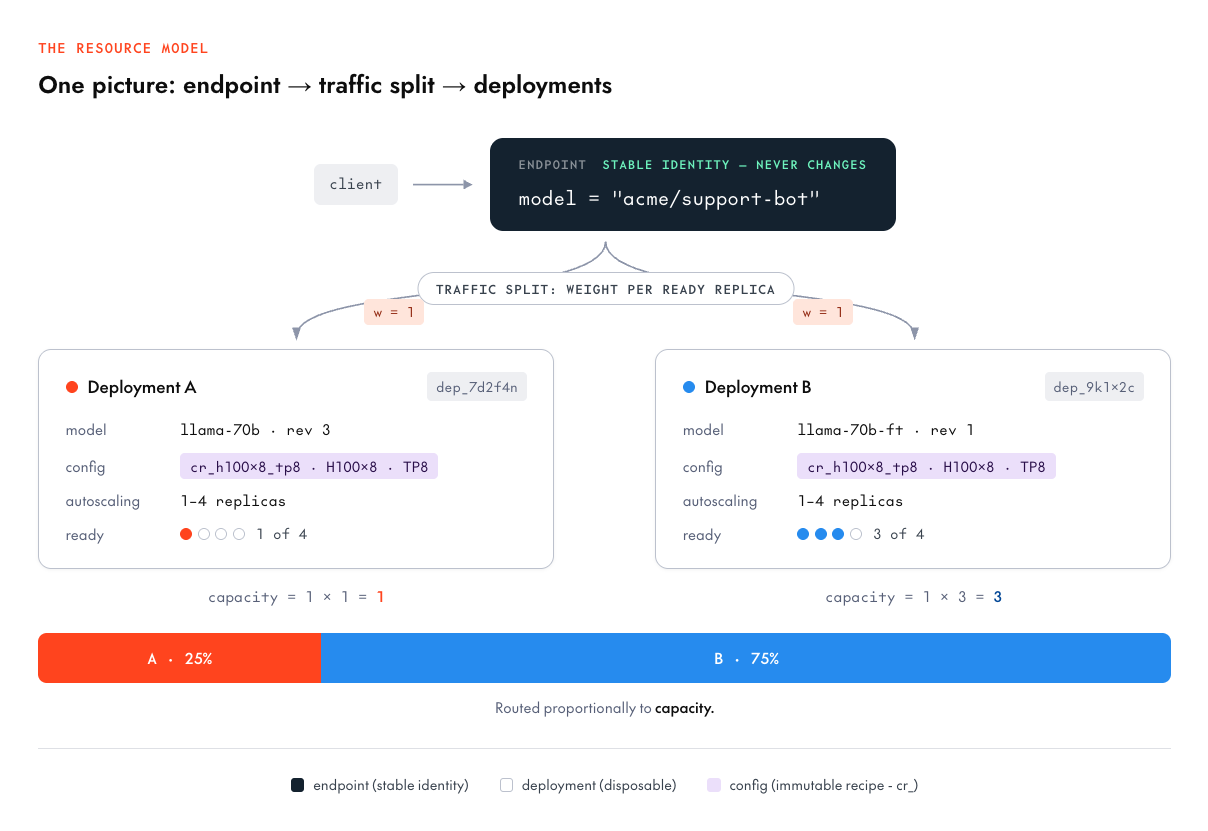
- **端点(endpoint)**是固定身份:一个限定名,应用把它当普通推理 API 的
model参数传入。端点持有流量切分,决定请求在其名下各部署间的路由。
一个快速记忆法:看 ID 前缀就知道对象是什么,日志和脚本因此自解释——proj_(项目)、ml_(模型)、cr_(配置版本)、endpoint_、dep_(部署)、rol_(发布)。

平台里每个高级操作都只是”加一个部署、分配路由权重”:A/B 测试是带队列分配的部署;影子实验是权重为零但接收镜像流量的部署;停止一个部署就是把副本上下界设为 0/0。
按权重流量切分:容量感知路由
流量切分是 {deployment_id, weight} 条目列表,权重按就绪副本计。路由器把每个部署的有效容量算作 weight × ready_replicas,按容量比例分发请求。
走一遍图里的例子:两个部署权重都是 1,但部署 A 有 1 个就绪副本(容量 1),部署 B 有 3 个(容量 3),流量按 25%/75% 分。等权重意味着”每副本负载相等”,不是流量份额相等。
这样设计让路由和扩缩容变成同一件事:
- 自动扩缩免费协同。 部署 A 从 1 副本扩到 3 时容量变三倍,自动吸收更多流量。用朴素百分比的话,钉在”25%“的部署缩容时会饱和、扩容时会闲置。
- 你控制的是每副本负载。 权重 1 对 2 的意思是”B 的每个副本该干 A 每个副本两倍的活”。
- 不就绪的副本不计入。 冷启动中或退化为 0 就绪副本的部署贡献零容量,流量流向真正能服务的部署。
权重是正数、无总和约束:0.7/0.3 与 700/300 描述同一套路由。如果确实要固定流量份额(不受副本数影响),用 A/B 实验队列——整数百分比、总和 100。
设置切分是一次带字段掩码的 PATCH:
tg beta endpoints update $DEPLOYMENT_A --traffic-weight 1
tg beta endpoints update $DEPLOYMENT_B --traffic-weight 1

# 不缩容就把部署摘出轮转
tg beta endpoints update $DEPLOYMENT_B --traffic-weight 0
一个高频踩坑:全新部署在进入端点流量切分前不会获得任何流量。建好端点和部署、状态 READY、发请求却收到 routing_error,多半是切分没设置、路由器还不知道这个部署该接流量。CLI 的 together beta endpoints deploy 会替你设切分,所以快速上手”开箱即用”,裸 API/SDK 路径需要手动设置。
配置怎么选:选择器与不可变性
不用从零写配置。支持模型目录里每个模型都带部署档案——平台持续基准测试和改进的”模型+配置”认证组合:
tg beta models public zai-org/GLM-5.2 --json | jq '.data[0].deploymentProfiles[]'

# 拿到模型 ID 后,直接列出可部署配置
tg beta models configs ml_CcEtnFUbitJYNja6TTR6U
档案 JSON 里含 gpuType(如 NVIDIA-B200)、gpuCount、quantization(如 FP4)、parallelism(如 TP4)等字段,把模型和配置资源名复制进部署创建即可:
tg beta endpoints deploy zai-org/GLM-5.2 \
  --endpoint my-glm-endpoint \
  --config cr_Cd35DNpQuHM3RihtCkN59 \
  --traffic-weight 1
在配置之间挑时,选择器告诉你每个配方优化什么:
| 选择器 | 取值 | 编码的权衡 |
|---|---|---|
| accelerator_type | H100、H200、B200 等 | 成本 vs 显存带宽 vs 可得性 |
| accelerator_count | 1、2、4、8 | 装下模型 + KV 缓存余量 |
| optimization | latency / throughput / balanced | 服务的基础权衡 |
| topology | 聚合/分离等 | 模型如何拆分到多卡 |
优化轴是最值得花时间选的:延迟档优化首 token 时间——小批次、急切调度,代价是每 GPU 总 token 吞吐下降;吞吐档堆大批次——最大化每 GPU 小时聚合 token,单个请求等入批稍久。交互式聊天选延迟,离线流水线和批量摘要可用吞吐;两种流量都有就用均衡。
配置不可变是因为 cr_ 版本永不变——部署行为不会因为有人”顺手改了个共享配置的旗标”而漂移。变更即新版本,旧版本仍是有效的、测过的回滚目标。投机解码也从这里触发,因为草稿模型是配置的属性。
四个边界情况
1. 部署在切分里但 0 就绪副本。 容量 = 权重 × 0 = 0,不接流量,其它部署吸收它的份额。副本恢复后流量自动按比例回流。
2. 能删除仍在切分里的部署吗? 先摘出切分再删。拆除顺序是排空流量 → 停止 → 删除,API 会把你推向这个顺序。
3. 切分权重 vs A/B 队列百分比 vs 灰度步进百分比。 三种工具三种用途,按固定顺序组合:路由先按权重切分解析(按容量采样候选部署);若候选是某 A/B 实验的对照组,A/B 再采样(把对照组份额细分给各臂);若候选是活跃发布的源,发布再采样(按当前步进百分比在源和目标间切分);最后在胜出部署内选集群。
4. 客户端调用时用什么名字? 端点的限定名,直接当标准推理 API 的 model 字符串传。这个名在你做发布、换硬件、跑 A/B 期间保持不变。
两个实测:路由跟随容量与配置曲线
路由实验。 对一个带两个单 H100 部署的活跃端点实测:各权重 1、各 1 就绪副本起步,打 599 个带标记的请求并归因到服务它的部署;然后把 A 从 1 副本扩到 2,再打 599 个。容量感知路由让 AI 推理服务的流量分配完全跟随副本数变化:
| 阶段 | 副本 (A : B) | 期望份额 | 实测份额 | n |
|---|---|---|---|---|
| 1 | 1 : 1 | 50 / 50 | 47.6 / 52.4 | 599 |
| 2 | 2 : 1 | 66.7 / 33.3 | 69.4 / 30.6 | 599 |
路由跟随容量、容量跟随副本。部署 A 内部的两个 pod 各承载约 30–40% 总流量(39.6% 与 29.9%),路由器在 pod 之间也做均衡。
配置对比实验。 对演示端点的两个认证档案各 1 副本,60 秒闭环、并发 4/8/16、200 token 生成、token 数取自 API 的 usage 字段:
| 档案 | c=4 | c=8 | c=16 | TTFT p95 @ c16 |
|---|---|---|---|---|
| A · Qwen3.5-9B (BF16, TP1) | 362 tok/s | 789 tok/s | 1,464 tok/s | 368 ms |
| B · Qwen3-VL-8B (BF16, TP1) | 495 tok/s | 243 tok/s | 240 tok/s | 323 ms |
这张表是”必须实测”的全部理由:B 低并发赢、然后急剧劣化。 A 批处理良好,从 c4 到 c16 吞吐翻 4 倍、TTFT p95 只涨约 17%;B 在并发 4 比 A 快,之后饱和——过 c≈4 有效请求率停止增长、聚合吞吐减半、每分钟开始有请求彻底卡住。如果只在并发 4 做过压测就为高并发负载选了 B,问题只会在生产暴露。两个档案都不”错”,只是服务前沿上的不同点。起始配置给你测起点,一小时的扫描告诉你哪个适配你的流量。
五条命令跑通全模型
# 1. 身份:我是谁 / 哪个项目
tg whoami

# 2. 挑你模型的认证档案
tg beta models public --product dedicated

# 3. 一条命令:端点 + 部署 + 流量切分 + 等就绪
tg beta endpoints deploy $MODEL --endpoint my-endpoint --traffic-weight 1

# 4. 调用——限定名就是 model 字符串
resp = client.chat.completions.create(
  model="my-project/my-endpoint",
  messages=[{"role": "user", "content": "Hello!"}],
)

# 5. 看你建了什么
together beta endpoints get $ENDPOINT_ID
从这里开始,这个系列的其他一切(A/B、影子、灰度、扩缩容)都只差一个部署。
原文信息
- 作者:Together AI
- 发布时间:2026-07-29 原文地址:https://www.together.ai/blog/configuring-dedicated-model-inference
原文信息
- 作者Together AI
- 发布时间2026-07-29
- 原文链接www.together.ai/blog/configuring-dedicated-model-inference
原文链接:https://www.jxxy.net/ai/articles/together-dedicated-inference-config-guide/