在生产环境 Scikit-LLM 流水线中监控嵌入漂移 - MachineLearningMastery.com
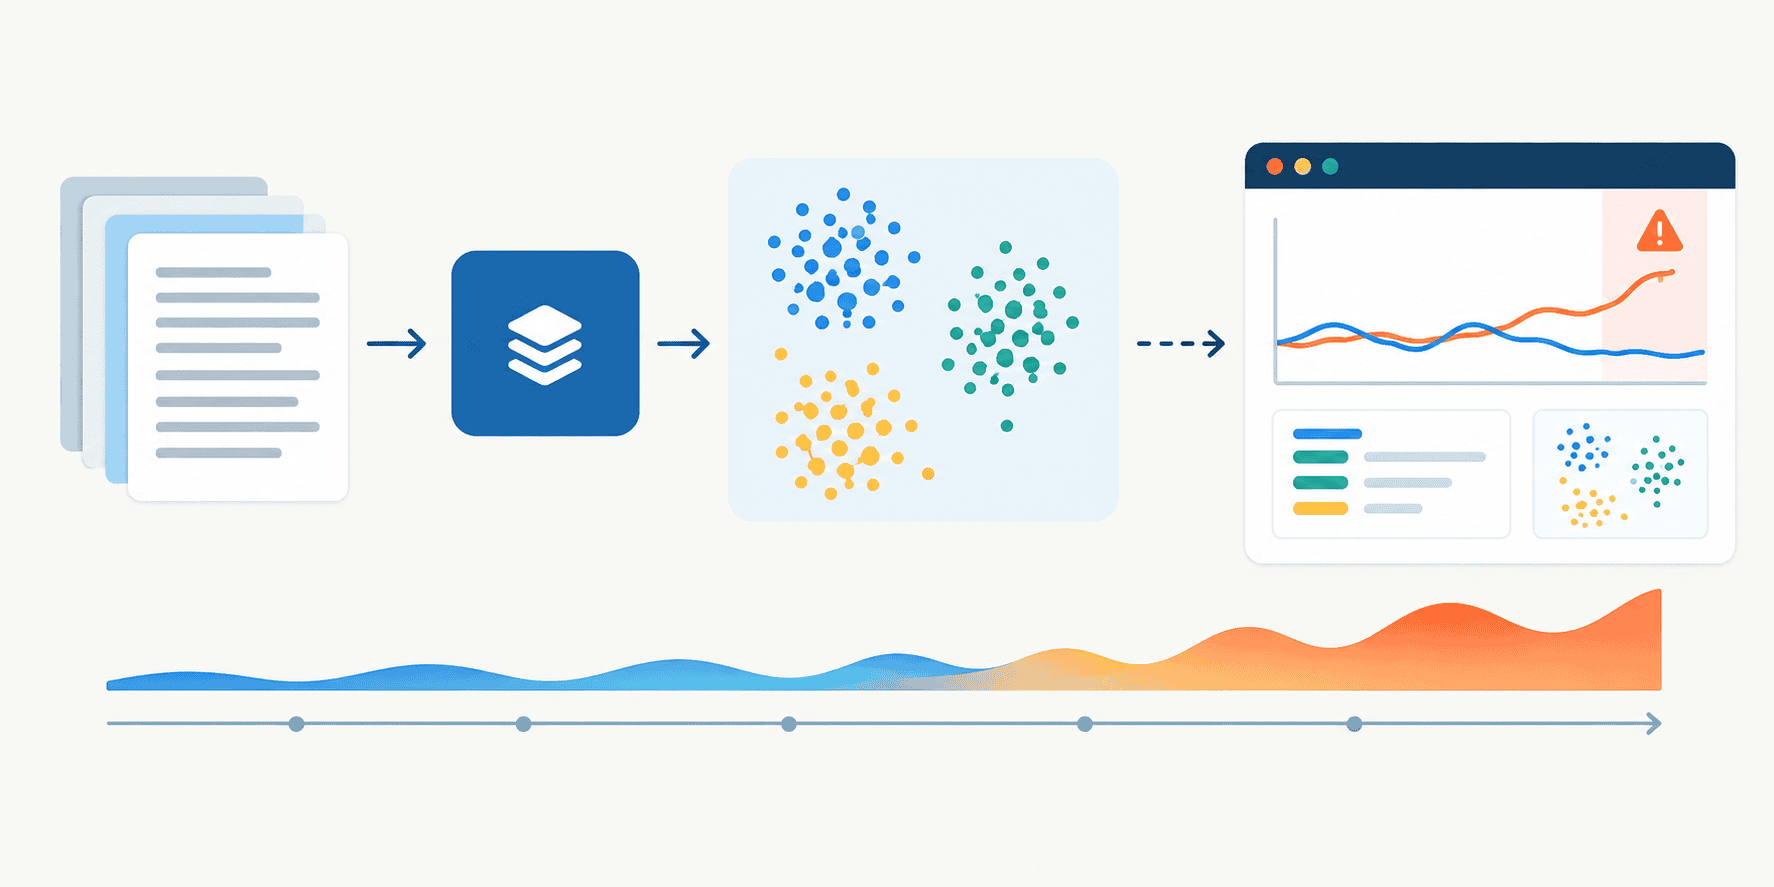
📌 One-Sentence Summary 本文探讨了在 LLM 生产环境中检测嵌入漂移的实用方法,包括基于模型的分类、质心距离和降维技术。 📝 Summary 当大型语言模型部署到生产环境后,用户行为会不断演变,从而导致嵌入漂移。传统的表格数据指标往往无法适用于高维嵌入。文章概述了三种关键策略:训练一个二分类器来区分基线数据与生产数据、计算质心之间的余弦距离,以及使用降维技术(如 UMAP 或 PCA)后进行统计检验。文章提供了使用 scikit-learn 和 Scikit-LLM 库的代码实现来演示这些技术。 💡 Main Points 嵌入漂移对于判断已部署模型何时需要更新至关重要。 用户行为随时间变化,意味着输入数据的数值表示(嵌入)会偏离原始训练分布。 基于模型的检测使用二分类器来识别偏移。 可以训练一个随机森林分类器来区分基线嵌入与新的生产嵌入;较高的 ROC-AUC 分数表明已发生显著漂移。 质心距离提供了一种计算成本更低但精细度较弱的替代方案。 计算基线向量与生产向量质心之间的余弦距离速度较快,但可能掩盖复杂的多模态分布偏移。 降维使得标准统计检验成为可能。 通过 PCA 或 UMAP 将高维嵌入压缩到较低维度,从而可以使用 Kolmogorov-Smirnov 等经典检验方法。 💬 Key Quotes 当大型语言模型(LLM)投入生产时,故事远未结束。 用户行为在现实世界中不可避免地演变,模型所消费的数据也是如此,这些数据通常被编码为称为嵌入的数值表示。 为表格数据设计的传统漂移指标在应用于高维嵌入时往往会失效。 📊 Article Meta AI Screening: 87 Source: Machine Learning Mastery Author: Iván Palomares Carrascosa Category: 软件编程 Language: 英文 Read Time: 10 min Word Count: 2401 Tags: 编程与工程 , 机器学习 , AI 工程 , 数据科学 , 模型训练与推理 Read Full Article
暂无评论,快来抢沙发~