用 Gemma 3 270M 训机器人 VLA:四阶段配方把 GR00T 砍半还多赢 15 分
一句话结论
在 NVIDIA Isaac-GR00T 架构上,把原版约 20 亿参数的视觉语言骨干换成 Gemma 3 270M,配合一套四阶段训练配方,整个 VLA(视觉-语言-动作)系统从 30 亿参数压到约 15 亿,SimplerEnv 六任务平均成功率反而从基线 31.7% 提升到 47.0%。结论很直接:在任务域收窄的前提下,训练配方与数据混合的权重不亚于骨干规模——这对算力有限、想自己微调机器人策略的团队是可复制的路线。
模型架构:小骨干 + 强动作头
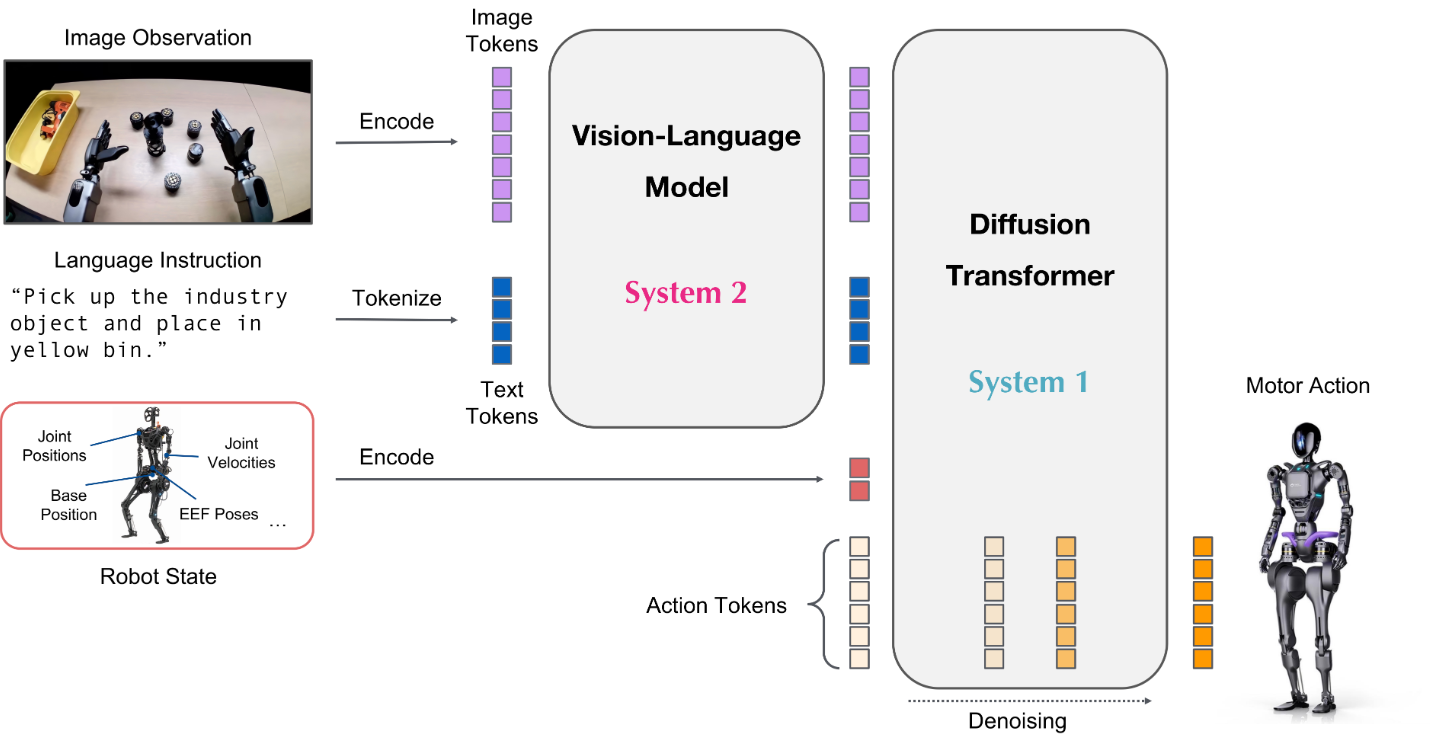
整体沿用 GR00T 标准的视觉-语言-动作布局。视觉侧是 SigLIP2 编码器,语言侧是 Gemma 3 270M,中间靠两层 MLP 连接器对齐;动作侧保留 GR00T 的 DiT 动作头(约 10 亿参数)与动作投影器,另加一个可学习的投影层弥合 Gemma 隐向量与 GR00T 动作头 2048 维输入之间的尺寸差。
骨干替换的收益是数量级的:原版 GR00T VLA 约 30 亿参数,换装后全系统约 15 亿,正好砍半。
动作头仍用 GR00T 预训练权重初始化,等于把「看和懂」的部分缩小,「动手」的部分保留原厂件。
第一阶段:连接器预训练
纯对齐阶段。SigLIP2 与 Gemma 3 270M 全部冻结,只训连接器——把视觉 token 投影进 Gemma 期望的嵌入空间。跳过这一步,语言模型看到的视觉表征就是错位的,下一阶段训练会明显不稳。
训练数据用完整的 LLaVA-CC3M-Pretrain-595K(约 59.5 万图文对,来自 Conceptual Captions)。两个大骨干都冻着,全部学习压力集中在连接器上,优化问题极度受限,反而容易得到干净的视觉到语言映射。作者全程用 W&B 记录了训练日志。
第二阶段:视觉语言指令微调
从第一阶段 checkpoint 出发,SigLIP2 继续冻结,Gemma 3 270M 与连接器解冻全训。视觉 token 此时已经落在大致正确的嵌入空间,语言模型可以把容量花在图像条件下的指令跟随上,而不是浪费在基础跨模态对齐。
数据取 Eagle-1.8M 前 30%(约 54 万条),覆盖多模态问答、OCR 重度任务、视觉推理、图表理解。这步对机器人至关重要:策略必须听懂指令指的是哪个物体、哪些空间关系要紧、画面暗示了什么动作。
第三阶段:十数据集均衡机器人混训
系统在这一步真正变成 VLA。第二阶段的 VLM checkpoint 初始化语言视觉部分,动作栈从 nvidia/GR00T-N1.6-fractal 加载,全模型联合训练(SigLIP2 除外,全程冻结)。
关键是数据混合:10 个机器人数据集横跨真实与仿真。真实侧有 Fractal、Bridge、DROID 子集;仿真侧有 RoboCasa 和一组 NVIDIA Panda 操作任务(开合抽屉、柜台微波炉间的抓放)。
Fractal 权重加到约占一半,其余九个均分剩下的一半——理由很务实:SimplerEnv 最直接对应 Google Robot 场景(Fractal 代表),不给足权重会伤基准分;只训 Fractal 又会让模型过窄,浪费广域机器人数据的迁移收益。
作者还记录了训练中的评估视频,可逐 episode 回看抓取、关抽屉等中间表现。
第四阶段:Fractal 定向后训练
从第三阶段 checkpoint 出发,只在 Fractal 上再微调 2000 步,把模型收拢到评测分布。保守策略是不解冻整个语言模型,只更新 Gemma 最后四层 transformer——给模型足够的灵活性磨任务特定的接地与动作选择,又降低抹掉第三阶段多本体知识的风险。
并行在第二块 GPU 上跑评估 watcher,每 1000 步给 SimplerEnv checkpoint 打分,确认后训练真的在提基准分而不是只降训练损失。产出 checkpoint 以 youngbrett48/gr00t-post-train-fractal-270m 追踪。
SimplerEnv 评测:六任务全面对比
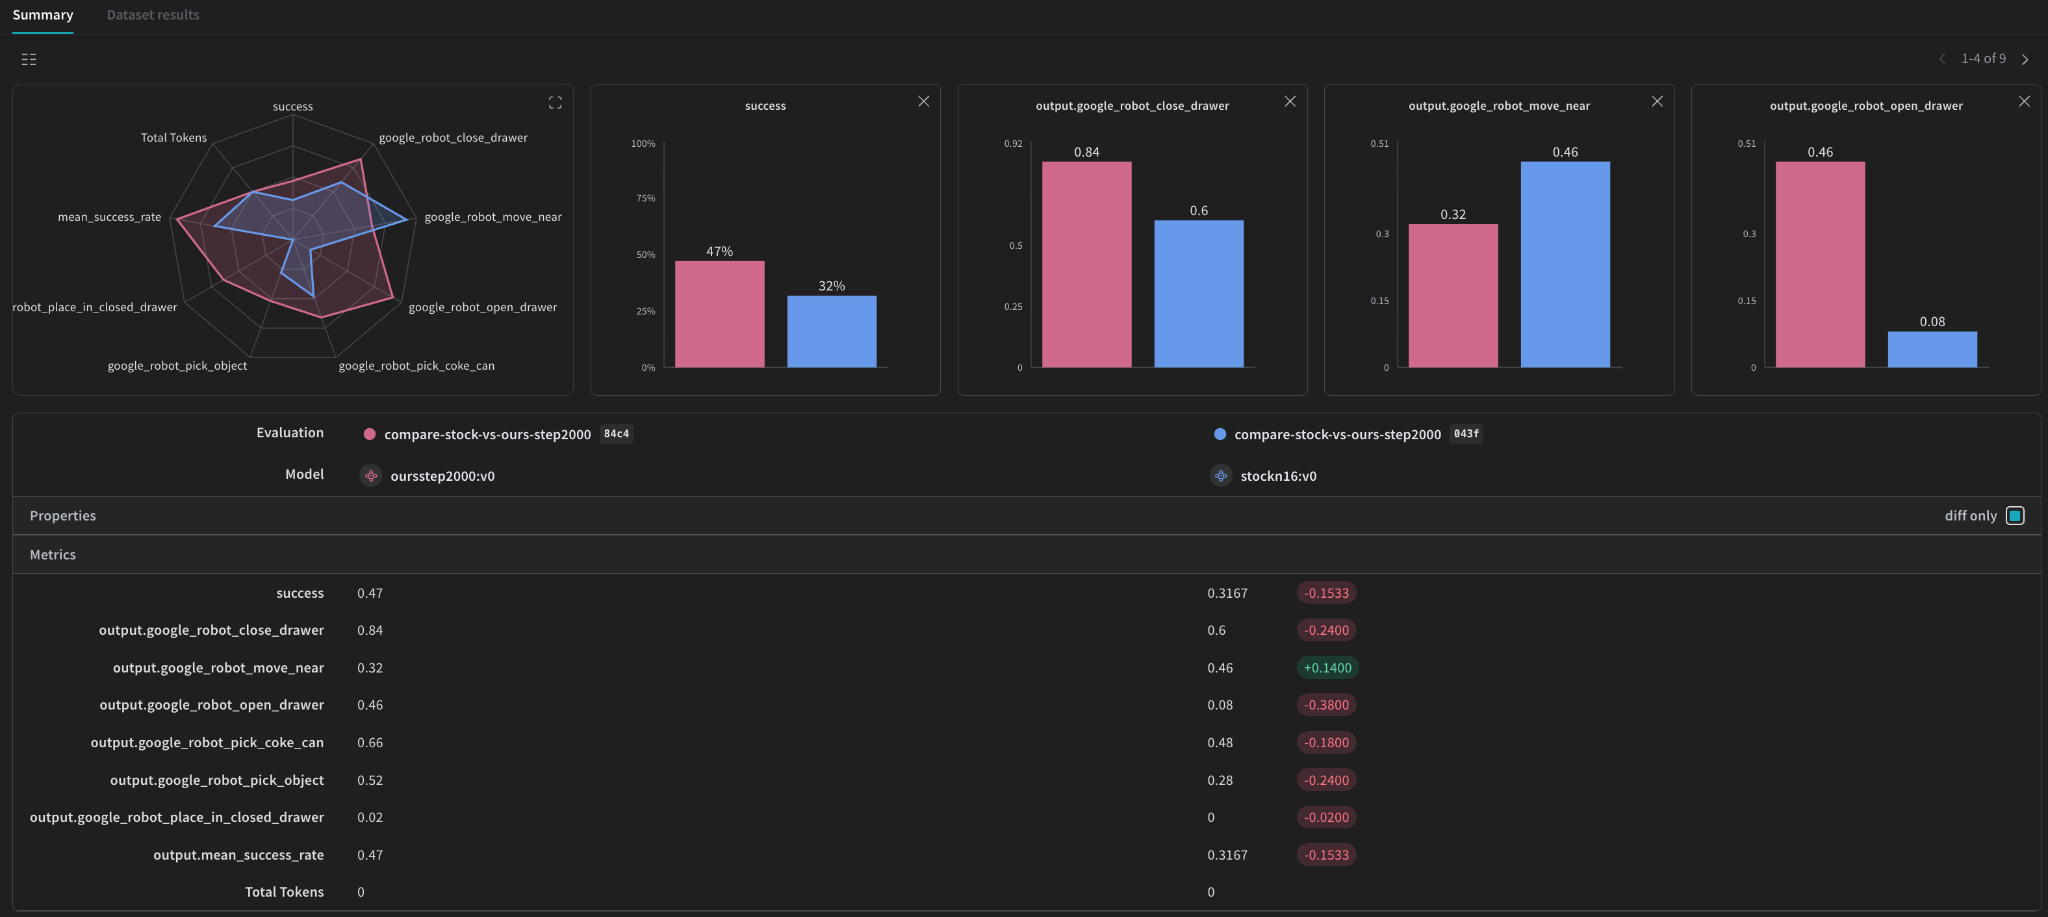
最终 checkpoint 在 SimplerEnv(复现 Google Robot 桌面场景的 GPU 加速物理仿真器)上评测:每任务 50 回合、六任务共 300 回合,物体位置与随机种子逐回合随机化,只有 504 步预算内完成任务才算成功——是严格的端到端成功率,不是轨迹质量之类的软指标。
| 任务 | 基线 GR00T | Gemma 3 270M | 变化 |
|---|---|---|---|
| close_drawer 关抽屉 | 60.0% | 84.0% | +24.0 |
| open_drawer 开抽屉 | 8.0% | 46.0% | +38.0 |
| pick_coke_can 抓可乐罐 | 48.0% | 66.0% | +18.0 |
| pick_object 抓物体 | 28.0% | 52.0% | +24.0 |
| place_in_closed_drawer 放入关闭抽屉 | 0.0% | 2.0% | +2.0 |
| move_near 移到近处 | 46.0% | 32.0% | -14.0 |
| 六任务平均 | 31.7% | 47.0% | +15.3 |
大多数任务显著超越基线,唯一回退是 move_near(46%→32%)。最难的 place_in_closed_drawer 两个模型都弱(0%→2%),说明这类长程精细放置仍是共性短板。
结论与适用边界
配方的核心结论:小骨干 + 分阶段对齐 + 指令微调 + 大规模机器人训练 + Fractal 后训练,可以在目标基准上打出高于官方 GR00T-N1.6-fractal checkpoint 的成绩。骨干规模只是 VLA 性能的一个因子,初始化、训练结构与数据混合同样关键。
作者明确标注了局限:评测范围不够宽,没跨多基准、多本体、分布外任务验证,缩小 VLM 骨干可能损失部分泛化推理能力;要下更强的结论需要更全的评测套件。
对自己的项目而言,这套配方的可迁移部分是「冻结-解冻节奏 + 数据加权策略 + 评估 watcher 并行打分」——想用小模型压成本做窄域机器人策略时,直接照这个骨架搭。
原文信息
- 作者:Brett Young(byyoung3)
- 发布时间:2026 年 4 月 29 日 原文地址:
暂无评论,快来抢沙发~