用 Gemini Live 音频接口在浏览器里搭一个可打断的语音对话工具
一句话结论
Google 发布了两款语音到语音新模型 Gemini 3.8 Live 和 3.8 Live Extended Thinking,Simon Willison 直接把官方文档丢给 GPT-6 Astra,让 AI 写出一个浏览器语音对话 Web UI:选模型、选音色、设系统提示词、可打断对话,零依赖直连 WebSocket,配套官方 WebSocket 入门教程可直接上手。
新模型与背景
Google 本次发布的 Gemini 3.8 Live 和 3.8 Live Extended Thinking 是两款 speech-to-speech(语音到语音)模型,形态上对标 OpenAI 的 GPT-Live 家族——直接音频进、音频出,不再走「语音转文字→文字模型→文字转语音」的拼接链路。
Speech-to-speech 架构的实际意义在于延迟与自然度:省掉两次中间转换,对话节奏更接近真人,还保留了打断能力——你说到一半插话,模型会立刻停下来听。
工具怎么用
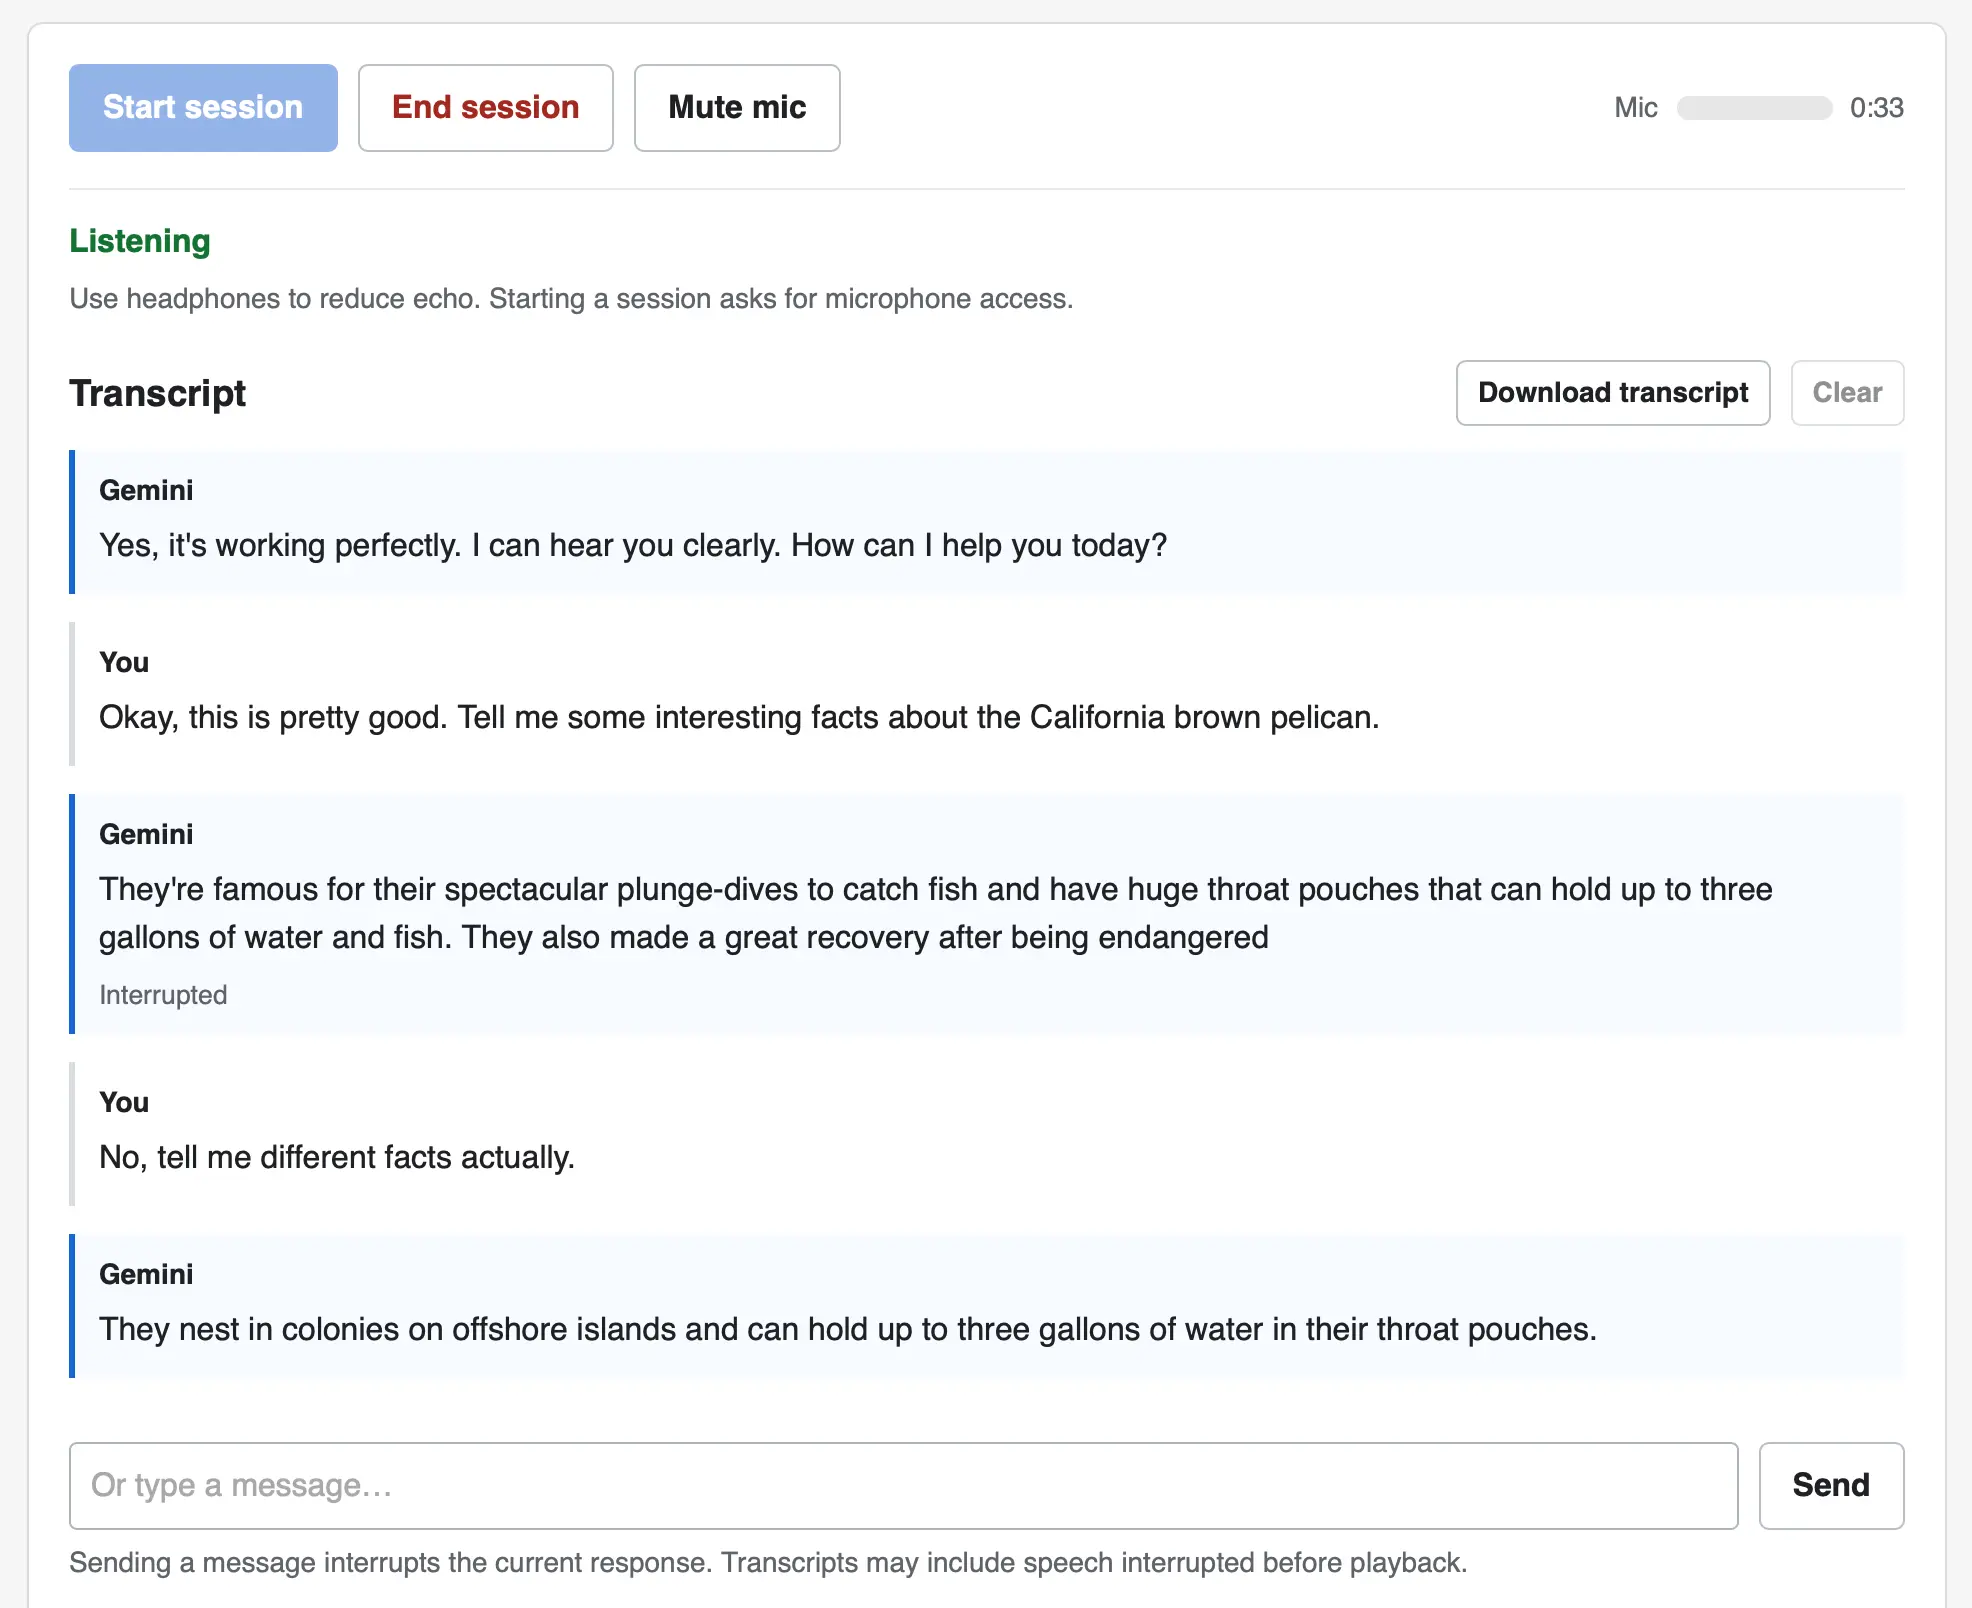
Simon 用 GPT-6 Astra Extra High 读官方文档后生成的这个 Web UI,功能覆盖了试用新模型的全部核心操作:
- 选择模型与音色预设:在界面顶部下拉选择要对话的 Live 模型和声音。
- 可选系统提示词:想测试特定人设或行为约束,直接在输入框里写。
- 开始语音对话:点击 Start session 授权麦克风,即可通过浏览器与模型对话。
- 随时打断:模型说话过程中直接开口,模型立即让位——界面会实时标记 Interrupted 状态。
- 完整转写留存:对话文字稿实时显示在界面上,支持一键下载和清空。
想自己跑一个的话,工具已开放:访问 Simon 的 tools 站点即可使用,也可以直接复刻实现——完整源码就是一个单文件 HTML,托管在 GitHub 上。
技术实现要点
这个工具最值得借鉴的是实现方式足够克制:零依赖,不用任何库。核心就两件事:
- 连接 Google 官方 WebSocket 端点
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent,双向音频流走这一个连接; - 用浏览器原生 Web Audio API 的
AudioContext同时完成麦克风采集和音频播放。
对想动手的开发者,Google 提供了官方的 Gemini Live WebSocket API 入门教程,跟着走一遍就能理解端点鉴权、音频分块和双向交互的完整流程。
对 AI 工作流的启示
这篇文章展示了「用 AI 快速造工具」的标准姿势:模型发布当天,把文档喂给一个强推理模型,让它直接生成可用的试用工具,而不是等第三方应用更新适配。文档在、API 在,配一个 AI 编码助手,从「想试」到「能用」的距离被压缩到小时级。
同样的打法可以平移到任何新 API 的评测场景:先让 AI 读文档搭最小可用客户端,再用它实际跑任务,验证效果后决定是否深入投入。
原文信息
原文地址: 作者:Simon Willison(@simonw),Django 联合创始人、Datasette 作者 发布时间:2026-09-15
暂无评论,快来抢沙发~