以 1% 的成本实现前沿模型品质:LLM 分类器生产环境基准测试
📌 One-Sentence Summary
Airbnb 将微调后的 2B 参数分类器与前沿 API 进行基准测试,发现该分类器能在不到 100ms 的时间内达到同等品质,成本约为其 1%,这表明使用领域特定数据进行微调能够改变品质、延迟与成本之间的前沿,而非只是在三者之间取舍。
📝 Summary
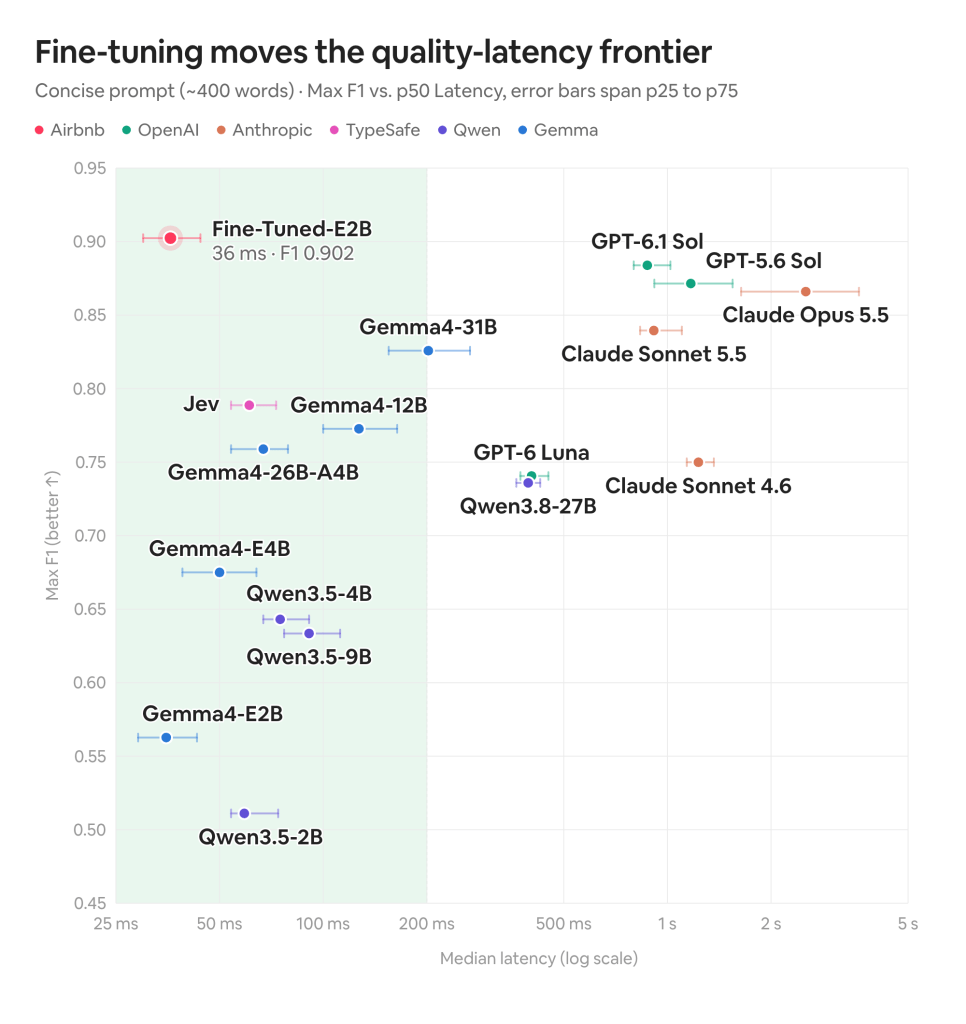
Airbnb 在一项生产环境分类任务中,将微调后的 E2B 分类器与开放权重模型和专有模型进行评估。该任务用于筛查内容是否违反 Airbnb 的定价与支付透明度政策。微调后的分类器 F1 达到 0.902,与表现最佳的专有模型相当;在单张 NVIDIA RTX Pro 6000 GPU 上运行时,其中位延迟约为 35ms。开放权重模型速度快,但品质有所牺牲;专有生成式模型准确但速度慢(中位延迟为 900ms),且灵活性不足;详细提示词虽能提升品质,但无法让延迟预算内的模型弥合差距。每分钟请求数(RPM)超过约 30 后,自托管的成本便低于 API 调用;在高请求量下,微调后的分类器成本更是低出多个数量级。作者总结,若请求量大、延迟要求严格、需要可设阈值的分数,且有标注数据可用,那么基于领域内数据进行微调就能同时实现高品质、低延迟和低成本。
💡 Main Points
微调能够改变品质、延迟与成本之间的前沿
使用数十万个领域特定样本微调 Gemma4-E2B 后,其 F1 从 0.563 提升至 0.902,中位延迟仍保持在 35ms,与表现最佳的专有模型相当,同时没有延迟方面的代价。
开放权重模型速度快,但品质有所牺牲
许多开放权重模型符合延迟预算,但其表现明显低于专有模型或微调后的分类器;模型规模增大也没有带来成比例的性能提升。
专有生成式模型准确,但速度慢且灵活性不足
即使在低思考模式下,GPT-6.1 Sol 和 Claude Sonnet 5.5 的中位延迟也约为 900ms,p99 延迟达到数秒;而且它们只返回二元判断,无法提供可设阈值的分数。
请求量高时,自托管成本更低
每分钟请求数达到数千时,前沿 API 模型的成本比单张自托管 GPU 高出两个数量级;微调后的分类器则能在单张 GPU 上支持每分钟数千次请求,且服务成本保持不变。
详细提示词能提升品质,但无法弥合快速模型的差距
一份包含实例演示、长达 2,700 个单词的提示词能够提升专有模型的表现,但对符合延迟预算的模型提升有限,同时还会增加延迟和成本。
💬 Key Quotes
我们在真实的生产环境分类任务中,将微调后的 E2B 模型与前沿 API 进行了基准测试。它在不到 100ms 的时间内达到了同等品质,成本约为其百分之一。
使用数十万个领域特定样本微调 Gemma4-E2B 后,其 F1 从 0.563 提升至 0.902,与表现最佳的专有模型相当,同时中位延迟仍保持在 35ms。
我们测试的其他模型在这两个维度上都无法与之匹敌。
每分钟请求数达到数千时,使用精简提示词的前沿模型成本比单张自托管 GPU 高出两个数量级。
基于领域内数据进行微调,能够同时实现高品质、低延迟和低成本。
📊 Article Meta
AI Screening: 90
Featured: Yes
Source: Hacker News - Newest: "LLM"
Author: eivarv
Category: 人工智能
Language: 英文
Read Time: 7 min
Word Count: 1659
Tags:
AI 与智能应用 , 模型训练与推理 , 开放权重模型 , AI 工程 , 上下文工程
赞同,实践出真知。
楼主辛苦了,内容很有参考价值。
思路清晰,干货满满。
思路清晰,干货满满。
实测过类似工具,作者说的基本属实。
讲解得很细致,新手也能看懂。
作者写得真不错,学到了不少。
点赞,必须点赞
有没有更详细的教程,期待后续。
内容翔实,正好需要,先收藏再看。
这个比较实用,已转发给同事。
看完了,收获满满,期待更多更新。