修图,而非改提示词
📌 One-Sentence Summary
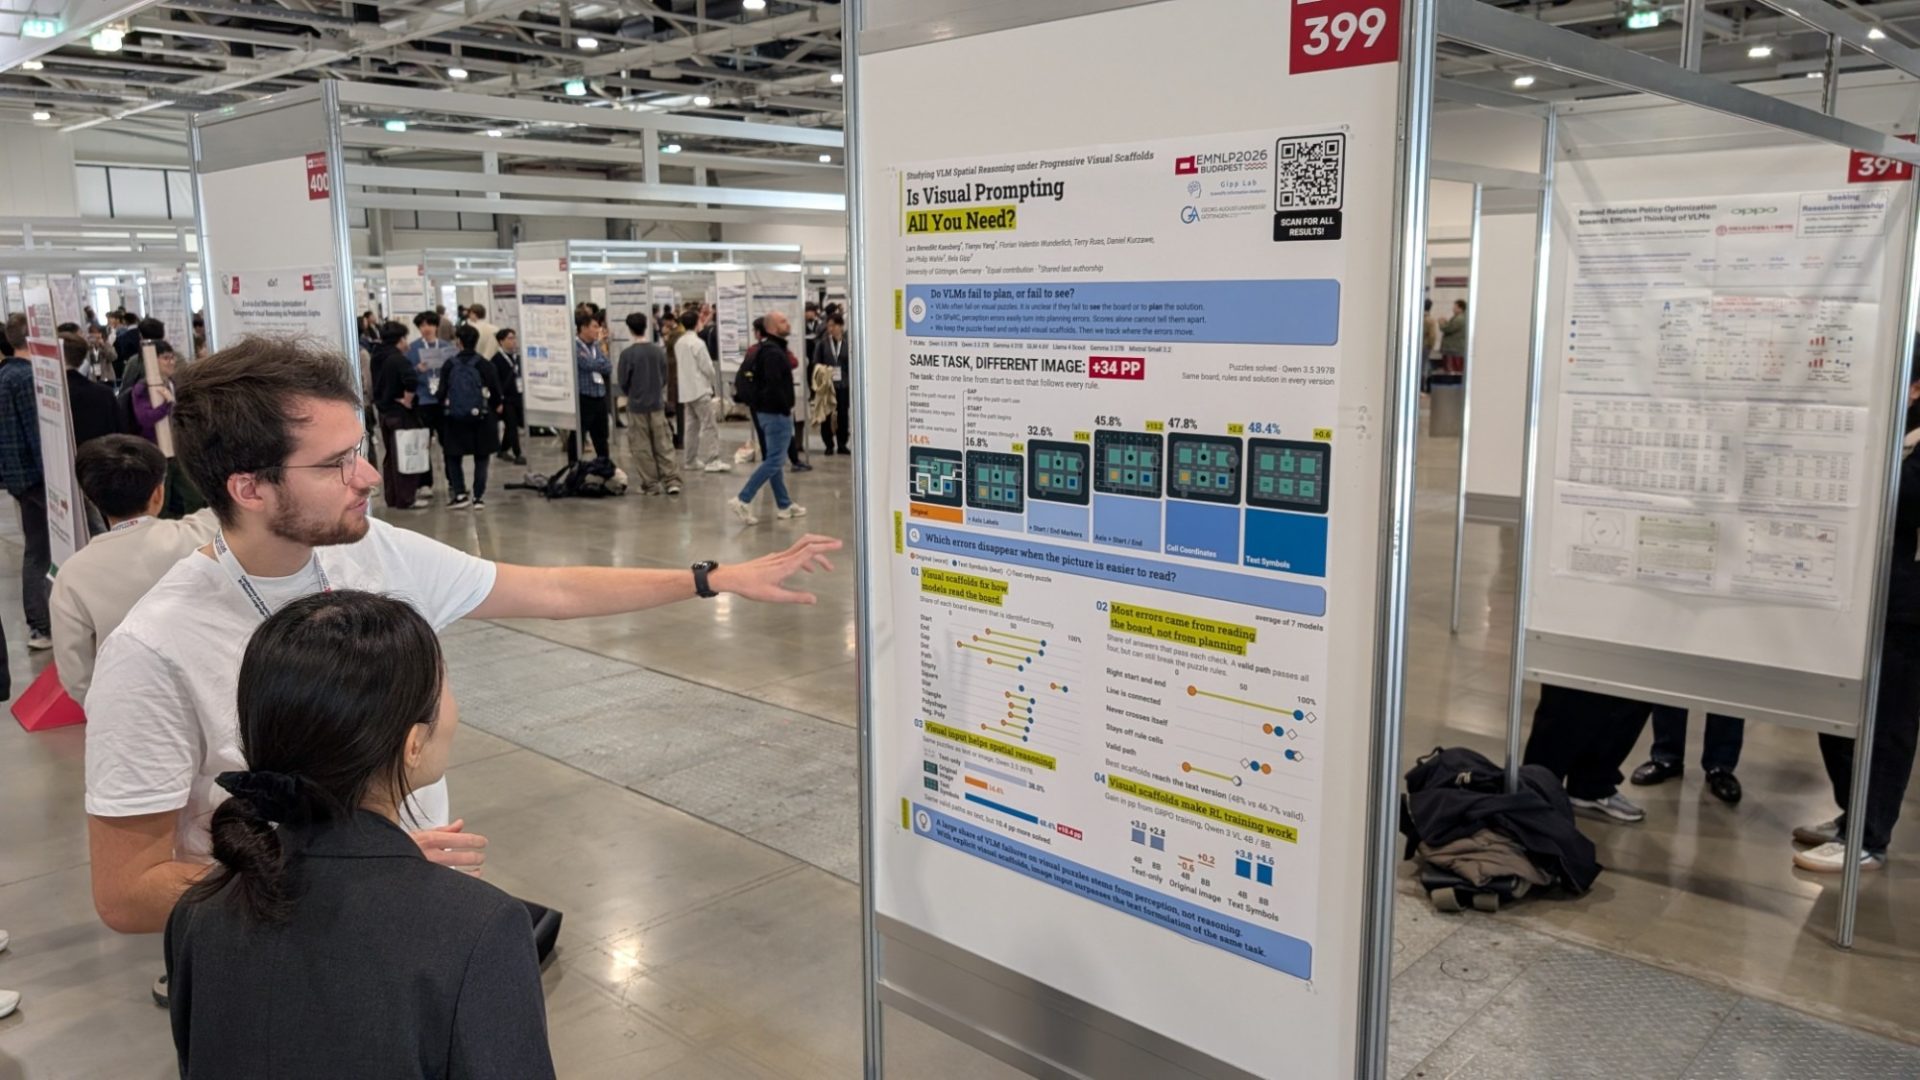
本文表明,在空间推理基准测试中,提升图像质量并添加有针对性的视觉标注对视觉语言模型准确率的影响(最高达 34 个百分点)远大于提示词工程微调(最高 5.2 个百分点)。
📝 Summary
文章呈现了在 SPaRC 基准测试上的实验结果,该基准是一个受《见证者》游戏启发的网格谜题数据集。研究比较了文本提示词修改与图像修改对视觉语言模型性能的影响。结果显示,改变图像绘制方式将 Qwen 3.5 397B 的准确率从 14.4% 提升至 48.4%,而提示词改动仅使 o4-mini 的得分变化最多 5.2 个百分点。研究揭示,有针对性的标注(如标记起点/出口或打印坐标)能显著提升性能,而通用标签或额外杂乱元素反而可能有害。核心洞见是:对于图像任务,修复视觉表征应先于提示词调优。
💡 Main Points
在 SPaRC 基准测试中,图像修改对 VLM 准确率的影响大于提示词工程改动。
重新绘制谜题图像使 Qwen 3.5 397B 的准确率从 14.4% 提升至 48.4%(34 个百分点的差距),而提示词改动仅使 o4-mini 的得分变化最多 5.2 个百分点。
针对特定阅读问题的定向视觉标注非常有效。
为起点/出口添加「S」和「E」标签使 Qwen 3.5 397B 的准确率从 14.4% 提升至 32.6%。在每个单元格中打印坐标则将其提升至 47.8%,几乎是原始分数的三倍。
通用或过多的标签可能降低模型性能。
行/列编号的帮助不如定向标签,而带有空白边距的网格线实际上降低了准确率(Qwen 3.5 397B 从 14.4% 降至 4.4%),因为这让模型对棋盘边界感到困惑。
图像必须「说」任务和答案格式的语言。
在单元格上打印坐标后,90% 的答案起始和结束于正确的单元格,而原始图像上这一比例仅为 11.8%。模型需要将视觉表征与基于坐标的答案格式相匹配。
💬 Key Quotes
我们的结果表明,对于图像输入,这往往不是正确的起点。图像更重要。
图片必须说提示词和答案的语言。
更多标签并不意味着更好的结果。两个定向字母使分数翻倍有余,而行列编号几乎无帮助,空白边距则使分数下降了三分之二。
对于图像任务,在调优提示词之前,先检查模型看到了什么。
📊 Article Meta
AI Screening: 85
Source: Towards Data Science
Author: Lars Benedikt Kaesberg
Category: 人工智能
Language: 英文
Read Time: 9 min
Word Count: 2026
Tags:
AI 与智能应用 , 计算机视觉 , 多模态 AI , 视觉语言模型 , 模型训练与推理
不错不错,已加入书签。
有没有更详细的教程,期待后续。
实话,说的不明不白
思路清晰,干货满满。
赞同,实践出真知。
实测过类似工具,作者说的基本属实。
看完了,收获满满,期待更多更新。
看标题就点进来了,内容果然没让人失望。
思路清晰,干货满满。
收藏了,以后慢慢研究。
楼主辛苦了,内容很有参考价值。
支持作者,持续关注中。