五种经过 Token 压缩与提示词优化技术
📌 One-Sentence Summary
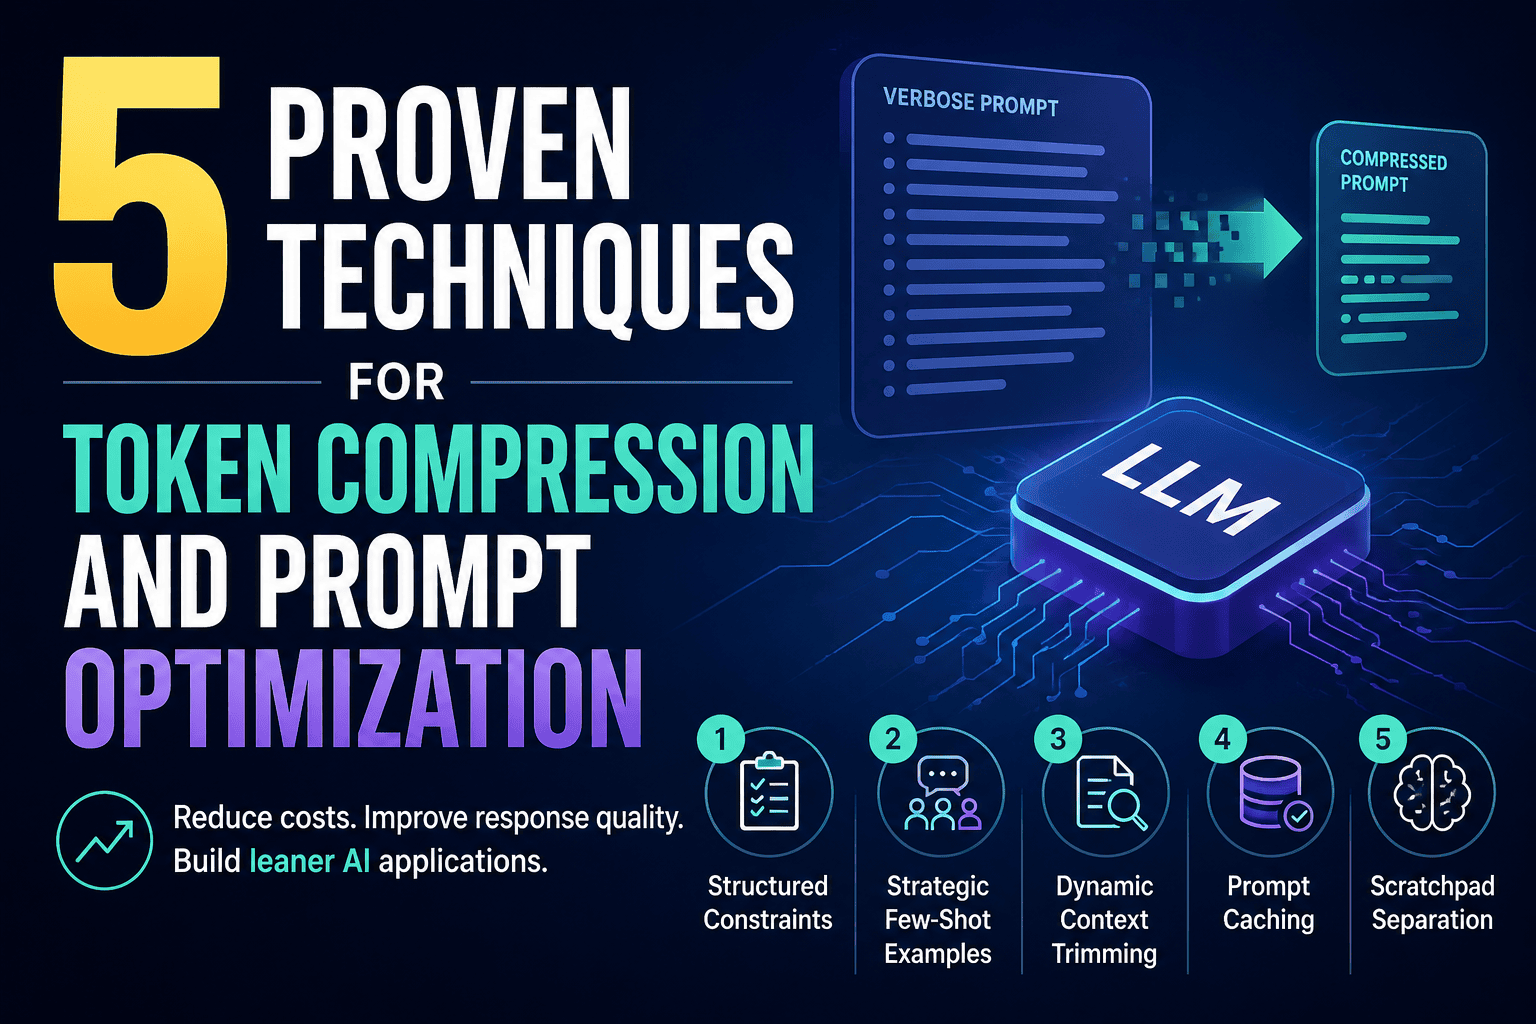
本文提供了五种实用技术,通过结构化约束、策略性少样本、动态上下文剪裁、前缀缓存和任务内省来减少 LLM Token 消耗并优化提示词效率。
📝 Summary
本指南帮助开发者和研究人员在不牺牲输出质量的情况下优化大语言模型应用。详细介绍了五个核心策略:1) 用声明式结构化约束代替叙述性指令以节省 Token;2) 将少样本示例限制在 3 到 5 个,以避免收益递减和模型混淆;3) 使用句子嵌入实现动态上下文剪裁,仅处理相关的文档片段;4) 针对跨 API 调用的重复系统指令利用前缀缓存;5) 使用 Python 内置的任务内省工具(如 asyncio-ps)调试生产环境中的挂起进程。
💡 Main Points
用结构化约束代替冗长指令
叙述性的系统提示词编写起来自然但成本高昂;使用声明式的类 Schema 格式(如 YAML 或 JSON)对模型解析更高效且成本更低廉。
策略性使用少样本示例
研究表明,超过 3 到 5 个示例后收益会递减;添加过多的示例可能会引入矛盾,反而会混淆模型。
针对长文档的动态上下文剪裁
使用句子嵌入和余弦相似度,允许开发者仅检索文档中相关的片段,而非整个文本,从而降低成本。
对重复内容实现前缀缓存
在多次 API 调用中缓存静态系统提示词和指令可以显著产生累积节省,特别是在扩展到数千次请求时。
使用内置任务内省工具进行调试
在 Python 3.14+ 中,像「python -m asyncio ps」这样的工具可以帮助在无需额外日志的情况下,识别复杂并发系统中挂起的根源。
💬 Key Quotes
Token 压缩是用更少的 Token 传递更多意图。
提示词优化是结构化这些意图的方式,以便模型准确且高效地响应。
三个示例就能建立模式。增加十个示例很少能提高准确性,往往会引入混淆模型的矛盾。
每一个 Token 都至关重要。
📊 Article Meta
AI Screening: 88
Source: KDnuggets
Author: Vinod Chugani
Category: 软件编程
Language: 英文
Read Time: 5 min
Word Count: 1097
Tags:
编程与工程 , 提示工程 , 大语言模型 (LLM) , Python , LLM
思路清晰,干货满满。
收藏了,以后慢慢研究。
讲解得很细致,新手也能看懂。
不错不错,已加入书签。
写得挺用心的,支持一下。
写得挺用心的,支持一下。
内容翔实,正好需要,先收藏再看。