我的机器学习流水线作弊了,而交叉验证从未察觉
📌 One-Sentence Summary
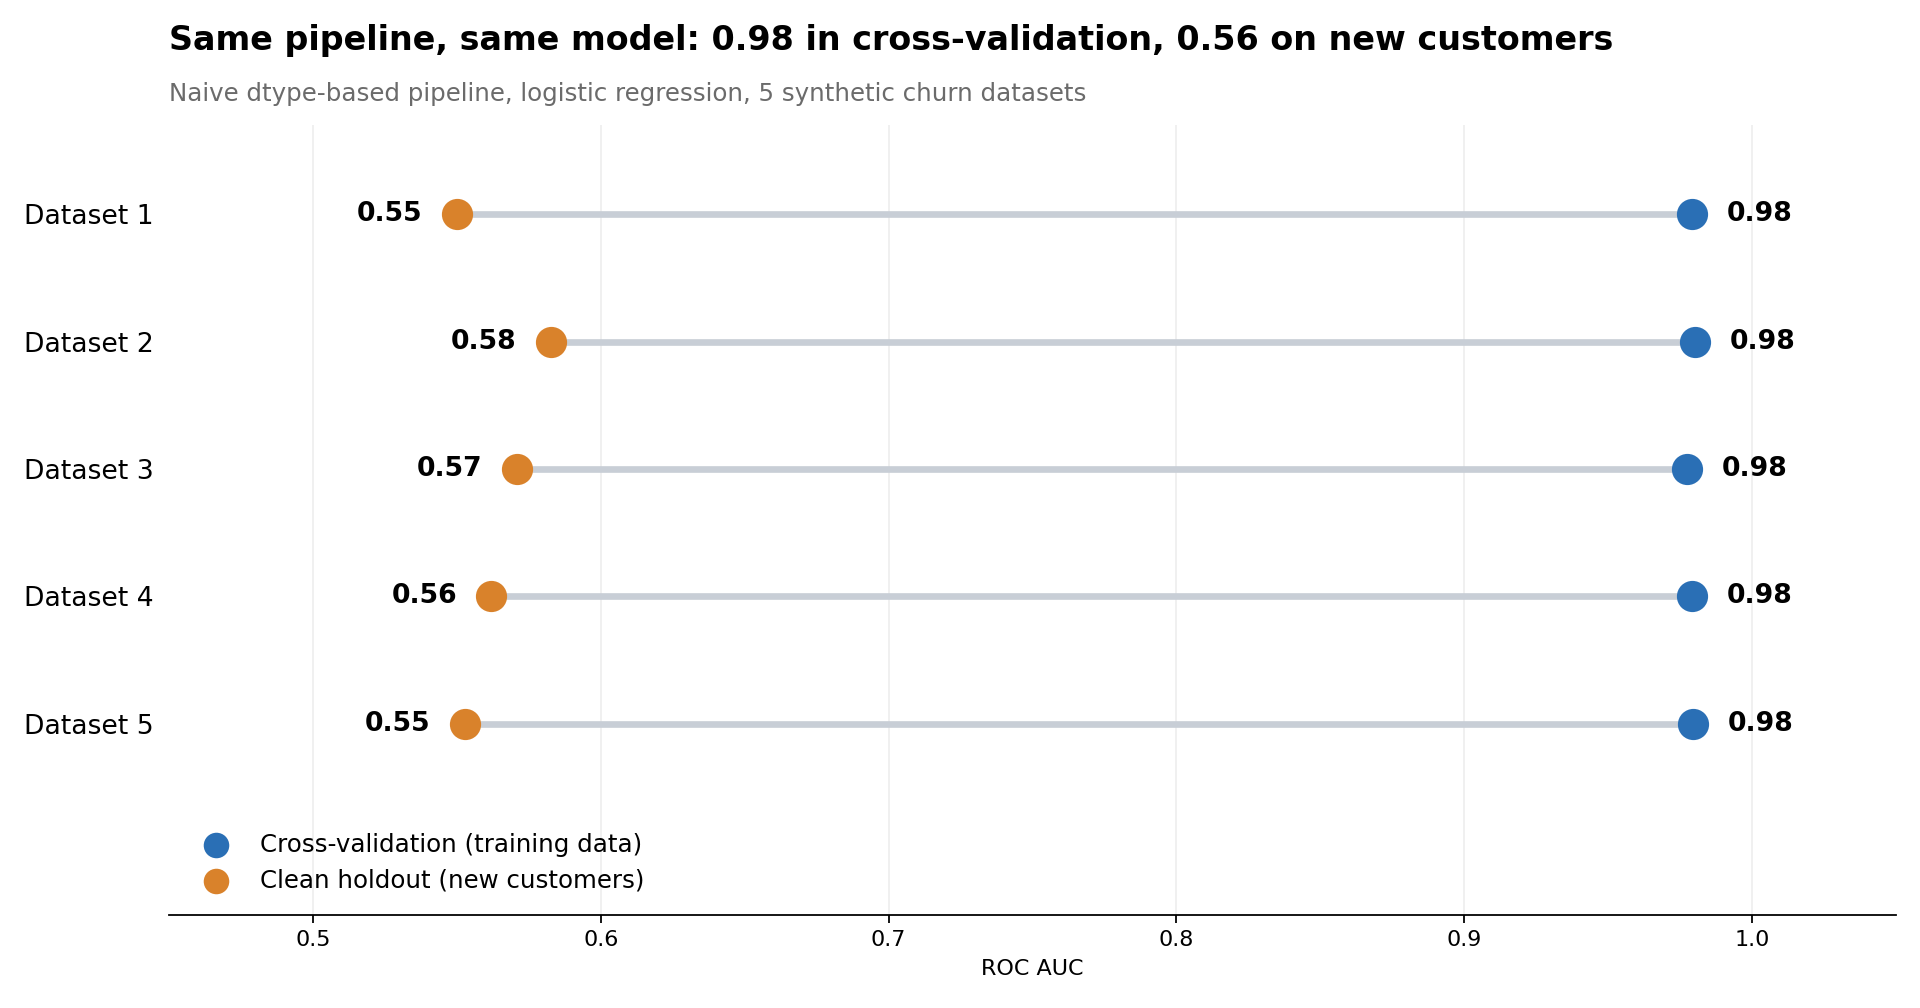
一个基于数据类型的朴素 scikit-learn 流水线取得了 0.98 的交叉验证 AUC,但在新数据上仅有 0.56,原因在于四个静默失败:数值型区域编码、有信息量的缺失值、被独热编码的日期字符串,以及泄露标签的 ID 列。
📝 Summary
作者展示了标准的自动化预处理流水线——按数据类型路由列以进行插补、缩放和独热编码——如何产生极具误导性的交叉验证分数。使用五个合成流失数据集,朴素流水线在交叉验证中得分 0.979 AUC,但在干净的留出集上仅为 0.564。四个埋设的陷阱导致了这一差距:(1) region_code 以整数 1–12 存储但效应非线性,(2) support_calls 在流失用户中更常缺失,(3) signup_date 作为文本创建了 1,931 个独热列,(4) customer_id 在训练中与结果相关。仅丢弃 ID 就使交叉验证变得诚实(0.640 对留出集 0.632),但四项修复全部实施后留出集 AUC 达到 0.826。梯度提升仅部分挽救了朴素流水线。文章提供了一个 audit_table() 函数,能自动标记这些模式并给出通俗英语警告,以及一个 gap_warning() 来捕捉交叉验证与留出集的分歧。文中提出了五个实际问题,用于在信任自动化之前对其进行验证。
💡 Main Points
标准的基于数据类型的预处理流水线可能静默地产生近乎完美的交叉验证分数,但在新数据上完全失败。
在五个合成数据集上,朴素流水线交叉验证 AUC 得分为 0.979,但在干净的留出集上仅为 0.564。没有出现任何错误或警告;高分完全由泄露和记忆化驱动,而交叉验证无法检测到这些,因为泄露存在于训练折中。
四种常见数据模式会愚弄基于数据类型的自动化:实际是类别的数值列、有信息量的缺失、高基数文本(如日期),以及泄露目标的类 ID 列。
每个陷阱都留下统计指纹。区域编码(1–12)被当作连续变量缩放;support_calls 的缺失预示流失;signup_date 变成 1,931 个独热列,记忆了每日噪声;customer_id 通过插入顺序与结果相关。单独修复每个问题都有帮助,但只有四项全部修复才弥合了交叉验证与留出集的差距(0.833 对 0.826)。
交叉验证无法捕捉训练数据本身存在的泄露;一个模拟未来数据到达方式的留出集至关重要。
ID 泄露存在于每个训练折中,因此交叉验证欣然使用了它。只有按照新数据实际到达方式构建的留出集(单独导出,无 ID 与结果的相关性)才揭示了问题。文章的 gap_warning() 函数明确比较交叉验证和留出集分数以标记这种分歧。
建模前的自动化审计可以在建模前检测这些失败模式,将静默失败转化为可操作的警告。
提供的 audit_table() 函数扫描:具有预测能力的近唯一数值列(ID 泄露)、与目标有非线性关系的低基数数值列(类别编码)、缺失与目标相关的列(有信息量的缺失),以及高基数文本列(日期/名称噪声)。它在所有五个数据集中准确标记了四个埋设的列。
更强的模型(梯度提升)只能部分补偿糟糕的预处理;诚实的预处理仍然必要。
在朴素流水线上使用梯度提升仅达到 0.614 的留出集 AUC,而逻辑回归为 0.564。丢弃 ID 帮助最大(0.739),所有修复后达到 0.809——仍低于逻辑回归加修复后的 0.826,表明模型强度不能完全替代正确的特征工程。
💬 Key Quotes
一个 8 行的流水线是好的起点,却是糟糕的终点。
在训练数据上做交叉验证无法捕捉存在于训练数据中的泄露。
模型做了两件事:它从 ID 中读取了标签,并记忆了每日噪声。
自动化节省了时间,但它没有做检查,所以我把检查加入了自动化。
📊 Article Meta
AI Screening: 87
Source: Towards Data Science
Author: Himanshu Sharma
Category: 人工智能
Language: 英文
Read Time: 7 min
Word Count: 1731
Tags:
AI 与智能应用 , 机器学习 , 数据科学 , 模型训练与推理 , AI 工程
很有价值的分享,感谢整理。
看标题就点进来了,内容果然没让人失望。
实话,说的不明不白
写得挺用心的,支持一下。
这个观点很中肯,深有同感。
赞同,实践出真知。
写得挺用心的,支持一下。
写得挺用心的,支持一下。
作者写得真不错,学到了不少。
实话,说的不明不白
不错不错,已加入书签。
有没有更详细的教程,期待后续。