vLLM x AgentX:智能体流量的推理服务优化实战,KV缓存、并行策略与PD配比方法
一句话结论
智能体(agentic)工作负载正在成为 vLLM 流量的主要来源,其多轮会话、超长上下文与海量前缀复用特性,要求整个服务栈协同优化。这篇 vLLM 官方长文给出了实战路径:
KV 缓存管理、并行策略与引擎优化、预填/解码分离(P/D)配比方法论。在 SemiAnalysis 的公开智能体基准 AgentX 上,vLLM 于 DeepSeek V4 Pro 达到单卡 GPU 秒 13 万 token 总吞吐,MiniMax M3 达到每秒 376 token 交互速度;对比 Opus 5 API 定价,三款开源模型的服务成本优势为 14.6 至 106 倍。

智能体工作负载的特征:重新审视
自 5 月发布第一篇智能体服务文章以来,智能体流量份额持续增长。截至 2026 年 6 月,OpenAI 报告称企业客户中 Codex 产生的输出 token 已占 Codex 与 ChatGPT 合计的 64%。
不断增长的 token 消耗沿两条轴线挤压服务基础设施:成本与延迟。
成本效率决定固定硬件预算下能跑多少并发智能体;延迟决定每个智能体在推理与工具调用循环中推进多快。优化智能体服务需要整体改善「延迟-成本」前沿。
为在代表性流量下评估这一前沿,SemiAnalysis 发布了 AgentX——基于真实智能体编程轨迹构建的公开基准。这些轨迹给出了服务系统必须适应的工作负载画像:
- 长时多轮会话:每会话中位数 43 轮。
- 长上下文短输出:输入中位数 14.2 万 token,输出中位数 444 token。
- 大量前缀复用:前缀缓存命中率超过 96%。
- 子智能体密集:44% 的会话至少含一个子智能体,这些会话的中位数为 4 次子智能体展开。
服务智能体流量的三大挑战
这一工作负载特征对高效服务提出三个挑战:
- 前缀缓存压力:多轮会话每一轮都要回放此前全部对话。要让大量会话同时运行,引擎必须在轮次间卸载 KV 缓存。大规模部署时更难——KV 缓存管理、前缀缓存与卸载必须在多 GPU、预填/解码分离实例和多副本间协同高效工作。
- 执行效率:智能体负载上下文长、延迟要求紧,引擎必须在更短时间内处理更多 token、每个 token 做更多工作。这要求把并行策略、算子、调度、投机解码等引擎优化正确适配新的请求形态。
- P/D 配比难找:不同会话与子智能体的上下文长度和缓存命中率差异巨大,路由必须在缓存亲和与跨卡负载间高效平衡。这让不同并发下的最优 P/D 配比难以确定。

数据面:让 KV 缓存保持热态且靠近算力
**混合 KV 缓存管理:持续演进的地基。
** KV 缓存管理自 PagedAttention 起就是 vLLM 的核心,长上下文智能体负载进一步加重了 KV 容量压力。现代混合模型把滑动窗口注意力、线性注意力与全注意力组合在一起,其缓存块的大小与生命周期各不相同,使分配更复杂。
vLLM 混合 KV 缓存管理器的核心思路很简单:用统一内存页作为基本分配单元,再通过一个共享块池管理这些单元。
共享池让 vLLM 按需动态重分配内存,而不是按注意力类型静态划分容量。这很关键——全注意力的 KV 随序列长度增长,而滑动窗口与循环状态遵循不同的生命周期和扩展规则,最优划分随并发、上下文长度与前缀复用模式而变。

该抽象随新架构暴露的碎片化与传输低效持续演进。例如 DeepSeek V4 的初始 KV 缓存布局把不同缓存类型切进三个尺寸桶、分配了 92 个独立张量,碎片化导致额外填充浪费,对 P/D 传输和 KV 卸载都很低效。
新的打包式 KV 缓存布局把缓存组与层存进每块一个连续后备分配,而非 92 个碎片。这降低了描述符与 PD 传输开销,并在启用 FP4 索引器时允许更小分配单元,节省约 10% 的 KV 缓存内存。
**分层 KV 缓存卸载:带智能保留策略的分布式缓存池。
** 为在 GPU 显存容量之外、跨引擎保留前缀缓存,vLLM 集成了 MooncakeStore 提供分布式 KV 缓存池。集成以来采用率持续上升,团队持续在容量、效率与智能体负载的保留策略上发布新特性。
模型架构对等。 KV 缓存卸载集成始终是 vLLM 一等公民,完整支持稀疏注意力、压缩注意力、线性注意力等新架构,同时确保异步调度、P/D 分离、投机解码、并行等引擎功能不受影响。
分层 KV 缓存卸载。 vLLM 支持分布式 KV 缓存池的分层层级,用磁盘与额外纯 CPU 节点进一步扩容。
其实现方式是 MooncakeStore 独立存储模式——外部 Mooncake 客户端持有 CPU 池与磁盘层,vLLM worker 变为纯请求方。每节点启动独立 Mooncake 客户端后,可自由用 CPU 内存与磁盘扩展 KV 缓存池。
团队还把分布式共享 KV 缓存池与 Dynamo、llm-d 等路由器集成,简化路由策略,让请求在任意实例都能命中缓存。
性能优化。 混合模型必须为每种注意力类型分别构建键并查找,CPU 开销成倍增长。
团队通过更高效的数据结构、异步查找、把工作移出调度器关键路径、并行收发操作降低了这一成本。实现细节见 PR#46188、PR#45444、PR#45659 与 PR#47317。
会话感知的前缀缓存保留:对带线性或滑动窗口层加全注意力的混合模型,前缀复用需要保留线性状态或滑动窗口缓存。
在每个 token 处保存这些快照代价高昂,因此组合了两个互补策略:
- 间隔式保留:在每轮自动保留提示末尾缓存/线性状态。后续轮次与分叉的子智能体通常回放并扩展早前轮次的上下文,可复用已缓存上下文。但共享前缀通常在轮内结束,间隔式保留可能没保住检查点。为此引入第二个策略:
- Marconi 式选择性保留:当某个前缀第二次被观察到时保留一个检查点。请求遇到此前观察过但没有保留检查点的前缀时,vLLM 重算缺失状态并在该边界保存检查点,后续共享该前缀的请求即可复用。
两个策略组合,在大规模智能体负载下既保持高缓存命中率,又避免过高存储开销。技术细节可参考 vLLM Kimi K3 博文。
执行面:快速生成 token
模型专属并行策略。 现代推理系统有多个并行轴:张量并行(TP)、数据并行(DP)、专家并行(EP)、流水线并行(PP)与上下文并行(CP)。
最优并行取决于模型架构、硬件拓扑、负载模式与延迟 SLO。本节考察 NVIDIA GB/B 系列 GPU 与 AMD 对应产品上的两个代表模型。
Kimi K3 采用多头潜在注意力(MLA)与 Kimi 增量注意力(KDA)。MLA 把 KV 压缩进单一潜在空间且只有一个头,普通张量并行(TP)会在各卡复制该潜在缓存,效率不高。
作为 TP 的替代,团队在解码上下文并行(DCP)中发现了显著性能收益——DCP 沿序列维度分片缓存,每卡持有 1/N 的 KV 状态。对智能体负载,DCP 有两个好处:
- 更低解码延迟:MLA 注意力是访存受限的,成本随上下文长度增长。智能体前缀变长时,注意力占每个解码步的比重越来越大。
- 更高吞吐与 KV 容量:避免 KV 缓存复制让引擎能同时保持更多序列不在 KV 准入上停滞,从而更高吞吐。

DCP 的代价是额外通信:KV 缓存按序列分片,每个 MLA 解码层在注意力前需要一次 query 收集、注意力后需要部分输出归约。
团队仔细优化了 DCP 计算路径以绕开 NCCL 操作:利用对称内存缓冲区让对等 GPU 直接加载/存储;query 直接多播进注意力算子消费的缓冲区;每块 GPU 把部分注意力输出与 log-sum-exp(LSE)统计直接写进对端的接收槽,各卡再用在线 softmax 本地合并结果。
上述 GPU 间写入与计算融合进同一算子,对比默认 DCP8 实现每层延迟降低约 13%。

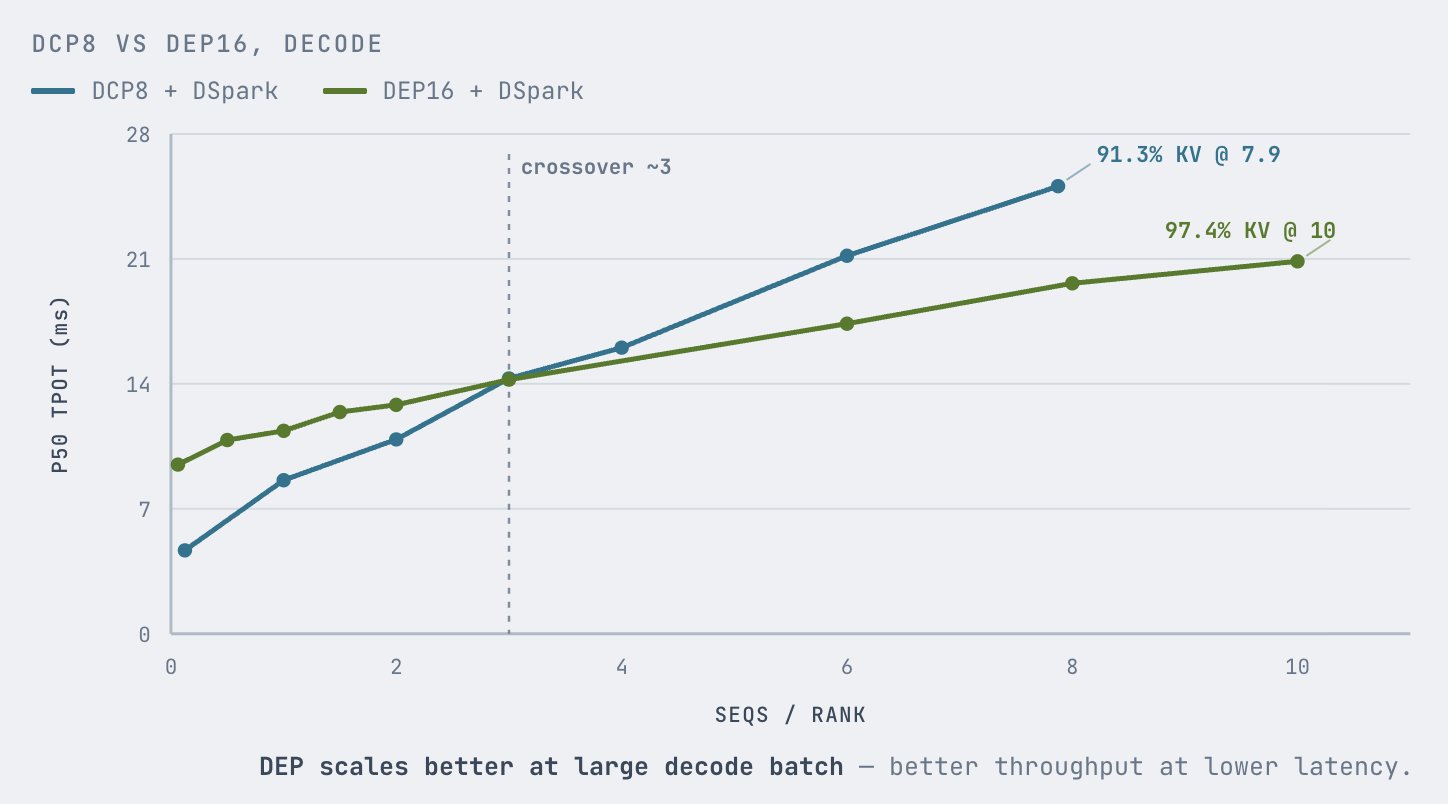
更大的伸缩域会改变最优策略。例如 NVL72 级系统上,宽 EP 加数据并行(DEP)可以比 DCP 扩展更好,在同一解码延迟 SLO 下达到更高吞吐。
原因在于更大的多节点 DCP 尺寸下,分片注意力的通信成本超过其节省的计算。DEP 把请求及其 KV 缓存分配到不同数据并行卡,避免 DCP 的注意力集合通信,同时跨卡分片 MoE 专家。
DeepSeek V4 同样有 TP 下复制导致显存低效的 MLA 式 KV 缓存。此外其独特的压缩稀疏注意力让 TP 头分片在计算上低效,原因有三:
- 压缩器路径每个压缩位置只产出一个共享 KV 表示,而非每头独立状态。TP 因此无法沿 KV 头维度分片计算,每张卡都重复压缩器工作。
- 索引器虽有 64 个头,每个 token 只产生一个全局 top-k 选择。当前 TP 路径在每张卡复制完整索引器,避免了 top-k 前的稠密分数归约,但重复了工作。
- 稀疏 MLA 的开销集中在扫描与收集 top-k KV 缓存条目,而非注意力算术。TP 在每张卡重复这类访存受限工作,却只分摊了更便宜的按头计算。
实践中,预填上下文并行(PCP)在长预填上表现最好,而数据加专家并行(DEP)在更宽的服务条件下都表现良好。
PCP 分片提示序列(query 张量),把压缩器与索引器工作分摊到各卡,同时给稀疏 MLA 更宽、更高效的头本地形态。对 3.2 万 token 提示,PCP8 相比 TP8 实现 2.65 倍预填加速,显著降低首 token 延迟(TTFT)。
不足是它仍在各卡复制解码侧状态,因此最适合专用预填 worker。
DCP 对 DeepSeek V4 的效果不如 Kimi K3,因其模型架构更复杂(详见「苦涩教训」)。
DEP 则把请求与解码 token 分配到不同数据并行卡,注意力路径完全本地。这使 DEP 成为大多数 DeepSeek V4 配置的默认选择。
两层调度混合智能体流量。 智能体服务混合了两类请求:
频繁的、只追加的、带长前缀复用与短预填的请求;偶发的、跨数万 token 的全新长预填。这产生两个调度问题:
实例内,一个长预填会阻塞短交互轮次;DEP 卡间,预填摆放不均造成负载失衡。团队用两个互补调度控制解决。
打破队头阻塞。 默认情况下 vLLM 的分块预填调度器遵循先进先出。
一个长预填可以一步接一步占满整个预算,同卡排队的短轮次在长预填完成前完全无法调度——这就是队头阻塞。
解决方式是一个简单调度策略:用 --long-prefill-token-threshold 限制单个请求每步最多可调度的 token 数。
设 512 token 阈值时,长预填给短轮次留出进入同一批次并更早开始解码的空间。在 B300 上跑 DeepSeek V4 Pro,这使单卡 GPU 秒 token 数(TPGS)提升最高 93%,p90 交互性改善约 2.3 倍。
代价是长请求自身 TTFT 变高,TTFT 敏感的部署应使用更高阈值。
对齐 DEP 预填调度节奏。 DEP 带来第二个低效:
MoE 全对全通信迫使各卡同步推进,一张在做预填的卡会拖慢整组。预填在不同步到达各卡时,这一惩罚被反复暴露。
为缓解失衡,设置 --prefill-schedule-interval 让预填工作仅在每第 N 个引擎步被准入,用一个跨数据并行卡对齐的计数器。这把预填工作集中到各卡相同的步上,提高中间步完全用于解码的比例。
下图展示了 DEP8 组上的这种节奏。

用最优 P/D 分离配置伸缩。 优化单个引擎不足以找到分布式部署的最佳延迟-成本点,加更多 GPU 或做分离不会自动改善前沿——预填与解码阶段必须速率匹配。
团队使用标准化两阶段速率匹配方法论,可由智能体工作流自动化:
- 阶段一:饱和画像。 分别对纯预填、纯解码部署做基准测试,扫描并行策略(如 TP 对宽 EP)与部署规模(8/16/32 卡),并发递增直到吞吐饱和。输出是一张饱和表:每种(并行、规模)配置的最大预填/解码请求速率。
- 阶段二:P:D 扫描。 从各配置的阶段一饱和点推导 P/D 配比,再对组合后的分离部署扫描并发,收集工作区间内的各项指标。
**闭环:模型专属算子与社区贡献。
** 智能体负载也把算子瓶颈推向长上下文注意力、投机解码与通信。几项有端到端实测影响的改动:
所有算子全部开源,部分已被其他开源引擎采用。
- MiniMax M3:CuteDSL 长上下文索引器按形状把 GB300 索引器延迟改善约 3% 至 31%;上游化的 MSA top-k 路径把最坏情况算子性能提升最高 4 倍、AgentX 端到端吞吐提升约 7%;投机验证路径在中批量解码上改善约 20%。
- Kimi K3:GEMM 与 reduce-scatter 融合改善序列并行通信,潜在尾部 MoE 融合降低端到端延迟约 5%。
- DeepSeek V4:社区贡献改进了 MXFP4 MoE 与 HCA 压缩(#43584 与 #44230),新增多流 C4A,改进了基于聚类的 top-k。
性能:智能体优先,公开可验证
vLLM 用 SemiAnalysis AgentX 独立验证其「智能体优先」定位——该基准基于 300 万美元真实智能体编程轨迹构建,100 万上下文,公开基准设施运行在超过 1000 芯片、约 2 兆瓦算力上。

图中展示 Kimi K3 仪表盘为例,基准与结果都在 AgentX Dashboard 公开可查,强烈建议查看其他模型与配置的帕累托结果。
本文聚焦三个开源前沿模型:DeepSeek V4 Pro、MiniMax M3 与 Kimi K3。对每个模型,展示保持 p90 每用户每秒 50 token 以上交互性的最高吞吐 vLLM 配置——这是常用的严苛延迟 SLO。下表汇总关键结果。

- DeepSeek V4 Pro 代表高吞吐与成本高效用例:12 卡 GB300 PD 部署支撑 256 路并发智能体会话,p90 每用户 58.3 token/s,单卡 GPU 秒处理 8.3 万总 token。
- MiniMax M3 把交互性推得更远、响应速度高:仅 2 张 B300 就维持 p90 每用户 74.2 token/s,总 TPGS 7 万。
- Kimi K3 作为最大的开源前沿模型之一展示前沿智能案例:2.8 万亿参数太大,无法常规单机部署;16 卡 GB300 维持 p90 每用户 62.7 token/s,总 TPGS 1.18 万。
除性能外,成本与用户日常使用和 token 经济高度相关。下表对比三款开源模型与 Opus 5 的成本。

成本优势来自智能体流量的定义性特征:理论缓存命中率超 96% 时,vLLM 有效复用前缀,在同一配置下释放全部三款模型的服务效率。
对 DeepSeek V4 Pro,服务实测负载的 GB300 基础设施 TCO 成本约每小时 28 美元。同样 token 量用 Opus 5 处理,即使对每个理论上可复用的 token 都按缓存读取计价,也要约 2926 美元。
MiniMax M3 在 B300 上有 85 倍成本优势;Kimi K3 在 GB300 上尽管模型大得多,仍便宜 14.6 倍。
数据截至发布日,但仪表盘是活的、人人可交互访问。AgentX 测试框架在 SemiAnalysisAI/agentx-harness 公开,上述每个结果都链接到 InferenceX 仪表盘上的运行记录,便于复现。
苦涩教训:哪里失败、学到什么
每个失败的想法都缩小搜索空间。团队观察到几个「合理直觉没能扛住端到端实测」的案例,仍在继续改进这些特性,同时分享已学到的教训。
流水线并行(PP)不适合热态智能体轮次。 PP(含分块流水线并行 CPP)在长、全新提示上表现好:
大预填提供足够工作填满流水线各级,吞吐近乎线性扩展且通信成本小。
然而大多数智能体轮次已缓存系统提示与此前轮次,每个新请求可能只追加几百到几千 token。没有足够新计算高效填满流水线,流水线气泡吞掉大部分潜在收益。
教训不是 PP 无效——它对冷的、计算密集的预填有效,但不应作为智能体会话中占主导的热态、前缀密集轮次的默认选择。
解码上下文并行(DCP)不能干净迁移到 DeepSeek V4。 DCP 对纯 MLA 模型(DeepSeek R1、Kimi K2.5、K2.7)与混合 MLA 模型(Kimi K3)效果良好。
换到 DeepSeek V4 上实现类似收益则难得多——其注意力栈更复杂:压缩稀疏注意力与高度压缩注意力包含索引器、额外压缩器与主注意力操作。
上下文并行必须划分并协调所有这些子层,引入大量通信与实现复杂度。
团队投入大量精力做通信与计算重叠及算子优化。即便如此,DCP 也只是追平 DEP 而非超越。
结果强化了执行面部分的更广泛结论:并行策略必须跟随模型架构。
在一个潜在注意力模型上成功的策略,未必能泛化到另一个。
负载均衡不保证更好性能。 聚合 DEP 部署中,观察到各卡 KV 缓存使用的显著不均。自然反应是按队列深度、运行 token 数或当前 KV 利用率均衡请求。
换成 AgentX 实验的结论是,所有这些策略都不如简单的会话感知粘性路由。原因是缓存局部性:
许多智能体会话轮间延迟很短,下一轮经常在前缀还驻留在上一块 GPU 时到达。把会话移到负载较轻的卡——即便其前缀缓存在分布式 KV 缓存池中保留着——也迫使系统取回 KV 缓存。
传输本身是异步的并与计算重叠,但并非零成本:预取块临时占用 GPU KV 缓存容量,减少目标卡能准入的序列数。
系统可以在队列更均衡的同时,整体处理更少的并发请求。
对轮间延迟短的工作负载,保留会话局部性比完美均衡瞬时负载更有价值。路由决策必须考虑每个 worker 已驻留的状态,而不仅是排队工作量。
前路:计划中的优化
下一步是让智能体结构在整个服务栈中显式化,每层各举一例:
- 控制面:让路由对首轮请求(往往需要长全新预填填满前缀缓存)与第 2 轮及以后请求(高缓存复用、相对短的追加预填)更显式。这一分离避免队头阻塞,并允许两侧分别配置引擎与并行(如 PCP 与 CPP)以最大化效率。
- 执行面与数据面:与社区合作支持——智能体提示(agentic 框架随请求携带会话结构、潜在分叉点与缓存位置、工具调用延迟、会话生命周期等提示,先用标准化 API 消费这些提示,再用于调度、缓存驱逐等优化);可编程 KV 缓存(不同负载需要不同放置、保留、复制与驱逐策略,可编程接口允许用户按负载模式控制预取、驱逐或软钉住 KV 缓存);基于会话的 KV 缓存管理(轮间空隙提供了把保留的 KV 状态移向最可能服务下一轮 worker 的机会,空闲区间预取可隐藏传输延迟、减少冷启动恢复)。
原文信息
- 作者:vLLM 项目(@vllm_project),开源大模型推理引擎官方团队
- 发布时间:2026-09-08
- 基准地址:AgentX Dashboard(行内代码
semanalysis.ai/agentx,测试框架github.com/SemiAnalysisAI/agentx-harness)
原文地址:
支持作者,持续关注中。
看完了,收获满满,期待更多更新。
有没有更详细的教程,期待后续。