vLLM 推理引擎两年 6 万星:PagedAttention 起家、Ray 胶水串起 RL 全流程的开源基础设施
一句话结论
vLLM 项目联合负责人 Simon 在 Ray Summit 2025 现场访谈中梳理了这个开源推理引擎两年半的发展脉络:它从管理 KV 缓存内存的 PagedAttention 研究起步,如今 GitHub 星标超过 6 万、下载量 2900 万次,定位是让开源与自研大模型在数据中心硬件上跑得又快又省;通过与 Ray 的「三明治」式嵌套协作,它已经成为开源强化学习框架里 rollout 与奖励打分两个关键阶段的标配引擎。

vLLM 是什么,解决什么痛点
用负责人自己的定义:vLLM 是一个推理引擎,把你从 Hugging Face 下载的开源大模型,或者公司内部自研的模型,高效地运行在数据中心硬件上——GPU、TPU、各类加速器都算。它要做的只有一件事:把模型跑得足够好。
「跑得好」具体指三个指标:更高的 tokens per second 吞吐、更低的延迟,以及整个生态的广泛兼容。对企业来说,这两个方向直接对应两类收益:终端用户侧,同样的对话请求返回更快,使用体验更流畅;服务提供侧,同样的硬件能承载翻倍的用户量,每个 token 的推理成本随之下降。
项目的起点是加州大学伯克利分校 Sky Computing 实验室的一个具体研究问题:如何高效管理 KV 缓存内存。所谓 KV 缓存,就是模型推理时保存的对话状态,每一个 token 的中间结果都要存下来才能继续生成。管理的粒度越细、越像操作系统管理内存页那样精确,同一块 GPU 上能同时容纳的并发对话数(batch size)就越大。这个思路后来发展成 vLLM 的奠基论文 PagedAttention。
从 PagedAttention 这个单一算法出发,项目逐步长出了更高效的调度器、跨多芯片的分布式推理、跨多节点的扩展能力,一直到对今天最新模型架构的支持。负责人给出的现状数字:万亿参数级别的模型(如 Kimi K2)已经可以在数百卡集群上运行。两年半拿到 6 万星标和 2900 万下载,背后是推理需求本身的爆发。
为什么现在爆发:每个 token 都有计算成本
访谈中主持人和负责人专门讨论了「为什么 vLLM 在这个时间点爆发」。答案回到成本结构:当前的 AI 工作负载受限于推理效率。你与 ChatGPT 的每一次对话、编辑器里每一次代码补全,背后都是按 token 计费的算力消耗;服务商如果能把单 token 成本压低一半,同等硬件下的用户容量直接翻倍。
vLLM 的切入点是成为模型与硬件之间的通用层:上面支持整个开源模型生态,下面对接各类芯片,中间用统一的引擎把两边高效撮合。负责人的表述是「用最好的芯片、以最高效率、跑最好的模型」,开源模式让这套能力对所有团队可用,产品规模化时成本空间就掌握在自己手里。
与 Ray 的三明治结构:训练侧与推理侧的胶水
访谈的技术核心部分是 vLLM 与 Ray 的协作关系,负责人用了「三明治」这个比喻来描述。
第一层:vLLM 在分布式推理场景下内部直接调用 Ray。跑多节点 vLLM 时,它自动初始化 Ray 集群,用 Ray 的 runtime environment、placement group 等原语管理资源;新发布的 GPU objects 特性也在接入计划中。
第二层:反过来,大量用户在 Ray Serve、Ray Data 以及各类 RL 引擎里运行 vLLM。框架层把 vLLM 当作推理服务组件,vLLM 内部又依赖 Ray,两者在同一套生态运行时里层层嵌套——这就是三明治的由来。
这套结构在强化学习场景里价值最大。负责人介绍,如今大量开源 RL 框架用 vLLM 加 Ray 完成两个关键阶段:rollout 阶段(生成样本回复、与环境交互)和奖励打分阶段(对输出质量评分)。这两个阶段都要求高吞吐、高效率,同时还要可靠、数值稳定、可确定——训练时你需要确认算法确实在学正确的东西,出问题时能定位调试。RL 系统的设计千差万别,vLLM 还要保持足够的灵活性让各种自研 RL 算法都能接入。
开源基金会治理:Ray 与 vLLM 加入 PyTorch 基金会
访谈后段谈到近期的治理变化:Ray 加入 Linux 基金会与 PyTorch 基金会,vLLM 也是其中一部分。
负责人的判断是「基金会是开源项目的正确路径」。它带来的不是技术路线调整——roadmap 组织方式、贡献流程、issue 管理都照旧——而是一种治理保障:重要的产业协作方在共同的治理模型下工作,避免单家公司控制项目走向的风险。PyTorch 基金会目前托管着 PyTorch 本体、训练系统 DeepSpeed,再加上 Ray 与 vLLM,训练与推理两端的分布式 AI 基础设施逐渐在同一治理伞下汇合,技术侧的深度集成也随之加深。
对选型中的团队,这个信号的实际含义是:这批项目不会因为某家公司的战略变化而突然变向,长期投入的风险可控。
状态与路线图:四个方向的年度盘点
负责人在 Ray Summit 的年度演讲框架也在访谈中剧透了,可归纳为四个方向。API 侧,vLLM 正在成为集成的通用 API;模型侧,模型生态与模型提供方持续扩充;引擎侧,过去一年重写了引擎核心,性能与兼容性同步提升;分布式侧,借助 Ray 与 Kubernetes 支撑最大规模模型的部署。
最让负责人兴奋的是模型团队与硬件团队在他的项目里直接协作:模型提供方希望新模型发布当天就被支持,芯片方希望新硬件上市时存量模型立即受益。vLLM 居中撮合,让「新模型发布即在所有硬件上可用、新芯片上市即让所有模型提速」成为可能。
上手与贡献路径
对想参与开源贡献的开发者,负责人给出的入口很具体:GitHub 仓库的 good first issue 标签和贡献者指南,从文档改进、API 服务端修复、补充测试,一直到深入引擎内部添加新功能,各层次都有切入点。项目文化强调开放与欢迎,这也是开源基础设施项目保持质量的方式——有问题可以直接去代码里修,社区讨论公开透明。
对企业用户的选型参考意义:如果你的团队在自托管开源模型做推理服务,或者构建 RL 训练管线,vLLM 已经是经过大规模生产验证的默认候选之一;配合 Ray 组成训练与推理一体的工作流,加上基金会治理的长期确定性,属于「生态位成熟」的基础设施选择。
对自建推理服务的团队意味着什么
把访谈信息拼起来,可以还原出一条自托管推理的参考路径。起点是 Hugging Face 上的开源模型,用 vLLM 做推理引擎部署到自有 GPU 集群;需要更大并发或跨节点时,vLLM 内部的 Ray 集成自动接管资源编排;做 RL 后训练时,rollout 生成与奖励打分两个重负载阶段都交给 vLLM,Ray 负责把训练框架、调度与放置粘在一起。
这条路径的每个环节都有开源社区托底:引擎本身、Ray 生态、PyTorch 基金会的治理框架。对成本敏感的团队,负责人点出的账本逻辑值得记住——推理成本是随用户规模线性增长的支出项,引擎层的效率提升会直接放大到整体毛利上;这也是为什么 ChatGPT 对话、Cursor 补全这类高频场景背后,推理引擎的优化空间被如此看重。
访谈里还有一个对选型有直接参考价值的表述:vLLM 的目标是「最快且最易用的推理引擎」。这两点分别对应吞吐性能指标与 API 兼容性——后者决定了从其他推理方案迁移过来的改造成本。项目这两年在引擎核心重写、API 通用化上的投入,都是在降低这两类门槛。
访谈之外:这场对话的上下文
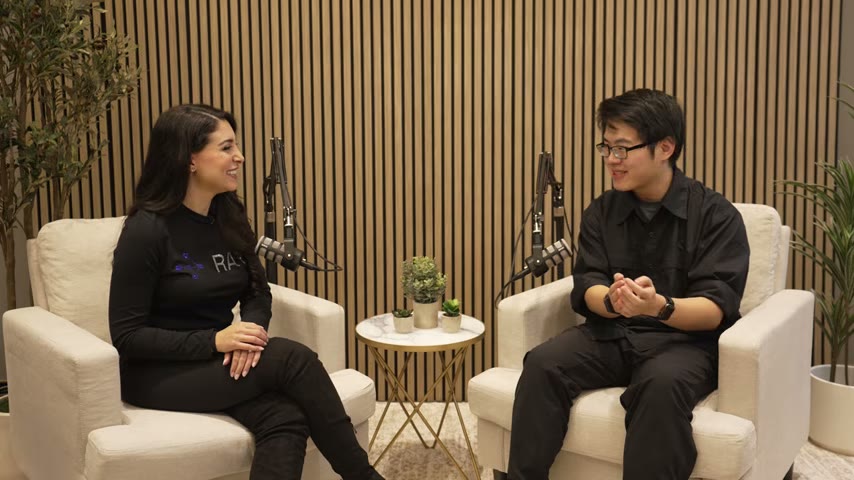
这场访谈录制于 Ray Summit 2025 现场牵头人对话环节,主持人是 Anyscale 生态侧的负责人。选择在 vLLM 联合负责人身上花一整期,本身反映了两个社区的高度绑定:Ray 撑起分布式训练与调度,vLLM 撑起推理层,两者在 RL 工作流里上下咬合。同场会议上 vLLM 团队还有一场年度状态演讲,按负责人预告,内容覆盖 API、模型生态、引擎重写与分布式部署四个方向,感兴趣可以找来对照观看。
对中文读者的一个提示:字幕由自动语音识别生成,个别专有名词(如 PagedAttention、Kimi K2、SkyRL)在转写里有失真,本文已按官方拼写校正;关键数字(6 万星标、2900 万下载、数百卡跑万亿参数模型)均出自受访者本人现场口述。
原文信息
- 原视频标题:The Rise of vLLM: Building an Open Source LLM Inference Engine
- 频道:Anyscale
- 讲者:Simon(vLLM 项目联合负责人,UC Berkeley Sky Computing Lab)
- 发布日期:2026-01-05
- 视频时长:约 13 分钟
暂无评论,快来抢沙发~