Vera Rubin NVL72 首秀 MLPerf:3.7 倍吞吐与 99% 扩展效率,推理选型看三个数
一句话结论
MLPerf Inference v6.1 首批 Vera Rubin NVL72 数据给出三个可直接用于推理基础设施选型的数字:对 GB300 NVL72 最高 3.7 倍吞吐(Qwen3-VL,跨离线、服务器、交互三类场景);288 卡四机架 99% 扩展效率(吞吐随加硬件近线性增长);软件优化在 v6.0 基础上再抬 1.6 倍(且提交后仍在继续)。对按 token 成本算账的团队,这三个数分别对应单机吞吐上限、扩容线性和持续增益节奏——选型时缺一个都会误判。
为什么推理选型看这三个数
系统性能、基础设施高效扩展和持续软件优化,是决定 AI 推理经济性的三个杠杆。性能越高,单位时间产出的 token 越多、收入越高;扩展越高效,加硬件时吞吐近线性增长、服务同等规模用户所需资源越少;优化越持续,既有基础设施投资的产出越高。三者底层是平台通用性——同一套基础设施跑任何模型、任何负载,从训练到推理、从推荐到推理型语言模型、从语言到视频,利用率始终在线。
本轮成绩对应三条主张:Vera Rubin NVL72 首秀即领先;GB300 NVL72 以领先效率扩展;持续软件优化驱动性能增长。
Vera Rubin NVL72 首秀:两个最重基准
NVIDIA 在 MLPerf Inference v6.1 最苛刻的两个基准上提交了 Vera Rubin NVL72 预览成绩:DeepSeek-R1 和 Qwen3-VL。
在 Qwen3-VL 上,用 vLLM 加 NVIDIA Dynamo 开源推理框架,跨离线、服务器和交互三类场景,吞吐最高达 GB300 NVL72 的 3.7 倍。在 DeepSeek-R1 上,用 TensorRT-LLM,吞吐最高达 2.5 倍。
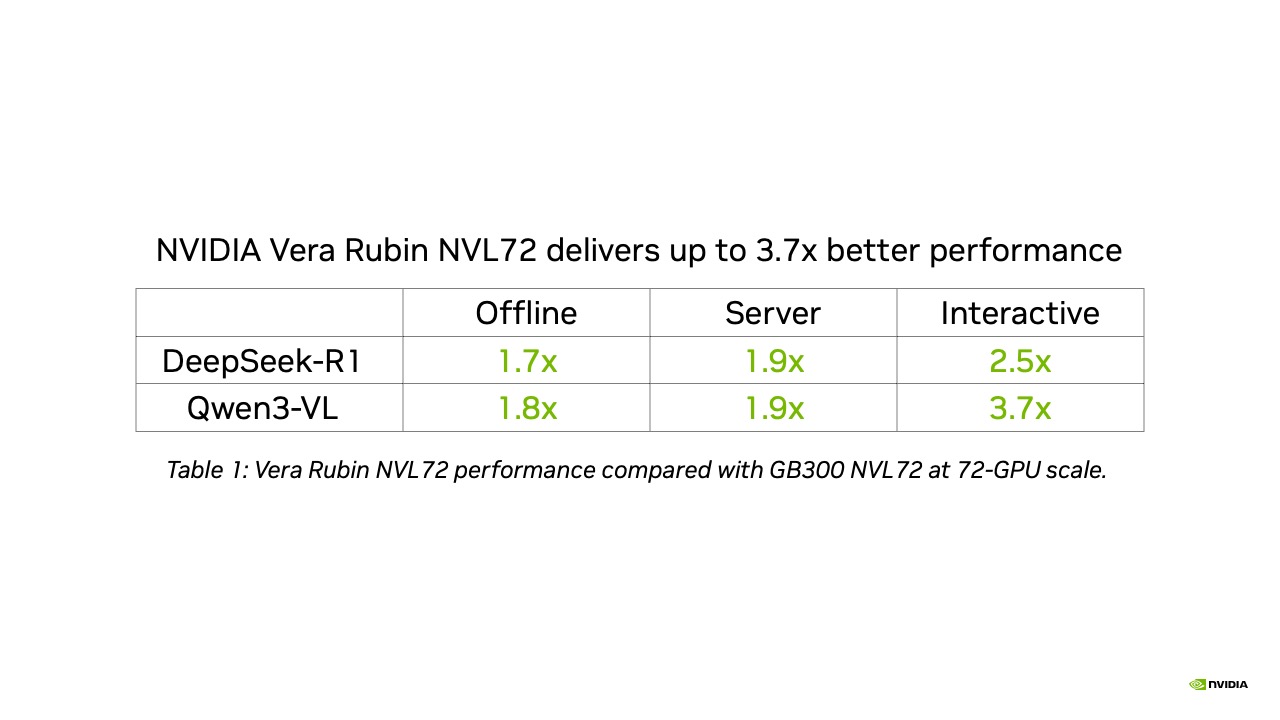
这意味着每台 Vera Rubin NVL72 机架产出的 token 显著更多、服务用户更多、单位 token 成本更低。成绩来自全栈协同设计:Vera Rubin 增强的 Tensor Core 和 Transformer Engine 同时加速推理的预填充和解码阶段;NVFP4 精度压缩模型权重、注意力和 KV 缓存的内存占用,在输出质量损失极小的前提下抬高吞吐。
Vera Rubin 提交大量使用分离式服务——预填充与解码分开部署——配合大规模专家并行,让 DeepSeek-R1 和 Qwen3-VL 这类混合专家模型的专家层拿到最高效率。
GB300 NVL72:288 卡 99% 扩展效率
扩展效率的实测:一次跨四个 GB300 NVL72 机架的 288 GPU 提交,达到 99% 扩展效率——从单机架基线起,吞吐近线性增长。

对扩容决策的直接含义:加第四个机架时仍能拿到近满额回报,不存在「过某规模后边际收益塌陷」。配合 NVLink 扩展域和动态路由,多机架对模型是单一逻辑资源池。
软件节奏:1.6 倍且未停
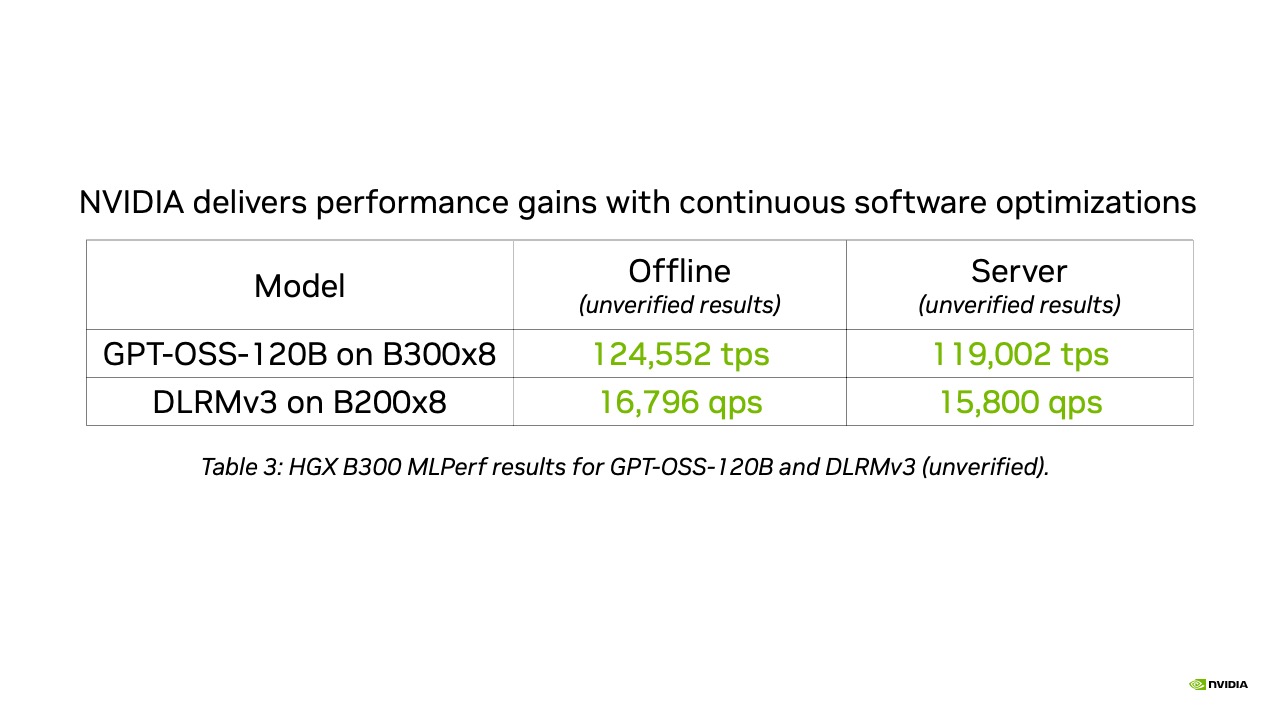
v6.1 提交里的软件优化相对 v6.0 抬升最高 1.6 倍性能,且提交截止后优化仍在继续。这条对选型常被低估:同代硬件的实际产出随软件版本持续变化,锁定「采购时点跑分」做长期容量规划会系统性低估平台价值。
选型框架:把三个数换成三个问题
对要做推理基础设施决策的团队,这组数据可以直接转成三个问题:
第一,单机吞吐上限够不够撑住峰值负载——用目标模型的真实基准(本组是 DeepSeek-R1 与 Qwen3-VL,恰好覆盖推理型与多模态两类主流负载)对照自家 QPS 需求。
第二,扩容曲线是否线性到你的目标规模——99% 扩展效率实测到 288 卡,意味着中大规模部署不必为边际衰减打折扣。
第三,软件增益节奏能否进入你的容量模型——若同代硬件一年内靠软件再拿 1.6 倍,采购窗口与版本锁定策略就该作为变量管理,而不是一次性定死。
原文信息
- 作者:Zhihan Jiang(NVIDIA 技术团队)
- 来源:NVIDIA 官方博客
- 原文发布日期:2026-09-16
原文地址:
暂无评论,快来抢沙发~