Vals AI 法律援助基准测试发现,模型难以提供本地帮助
📌 One-Sentence Summary
Vals AI 与 NextLadder Ventures 推出的「司法可及性基准测试」评估了 23 个 AI 模型在 504 个场景中提供可靠首次接触法律援助的能力。结果发现,模型擅长解释法律(满足 78-87% 的评估标准),但难以识别具体的本地资源(满足 30-50% 的评估标准);Qwen 3.8 Max 以 76.4% 的总体成绩领先。
📝 Summary
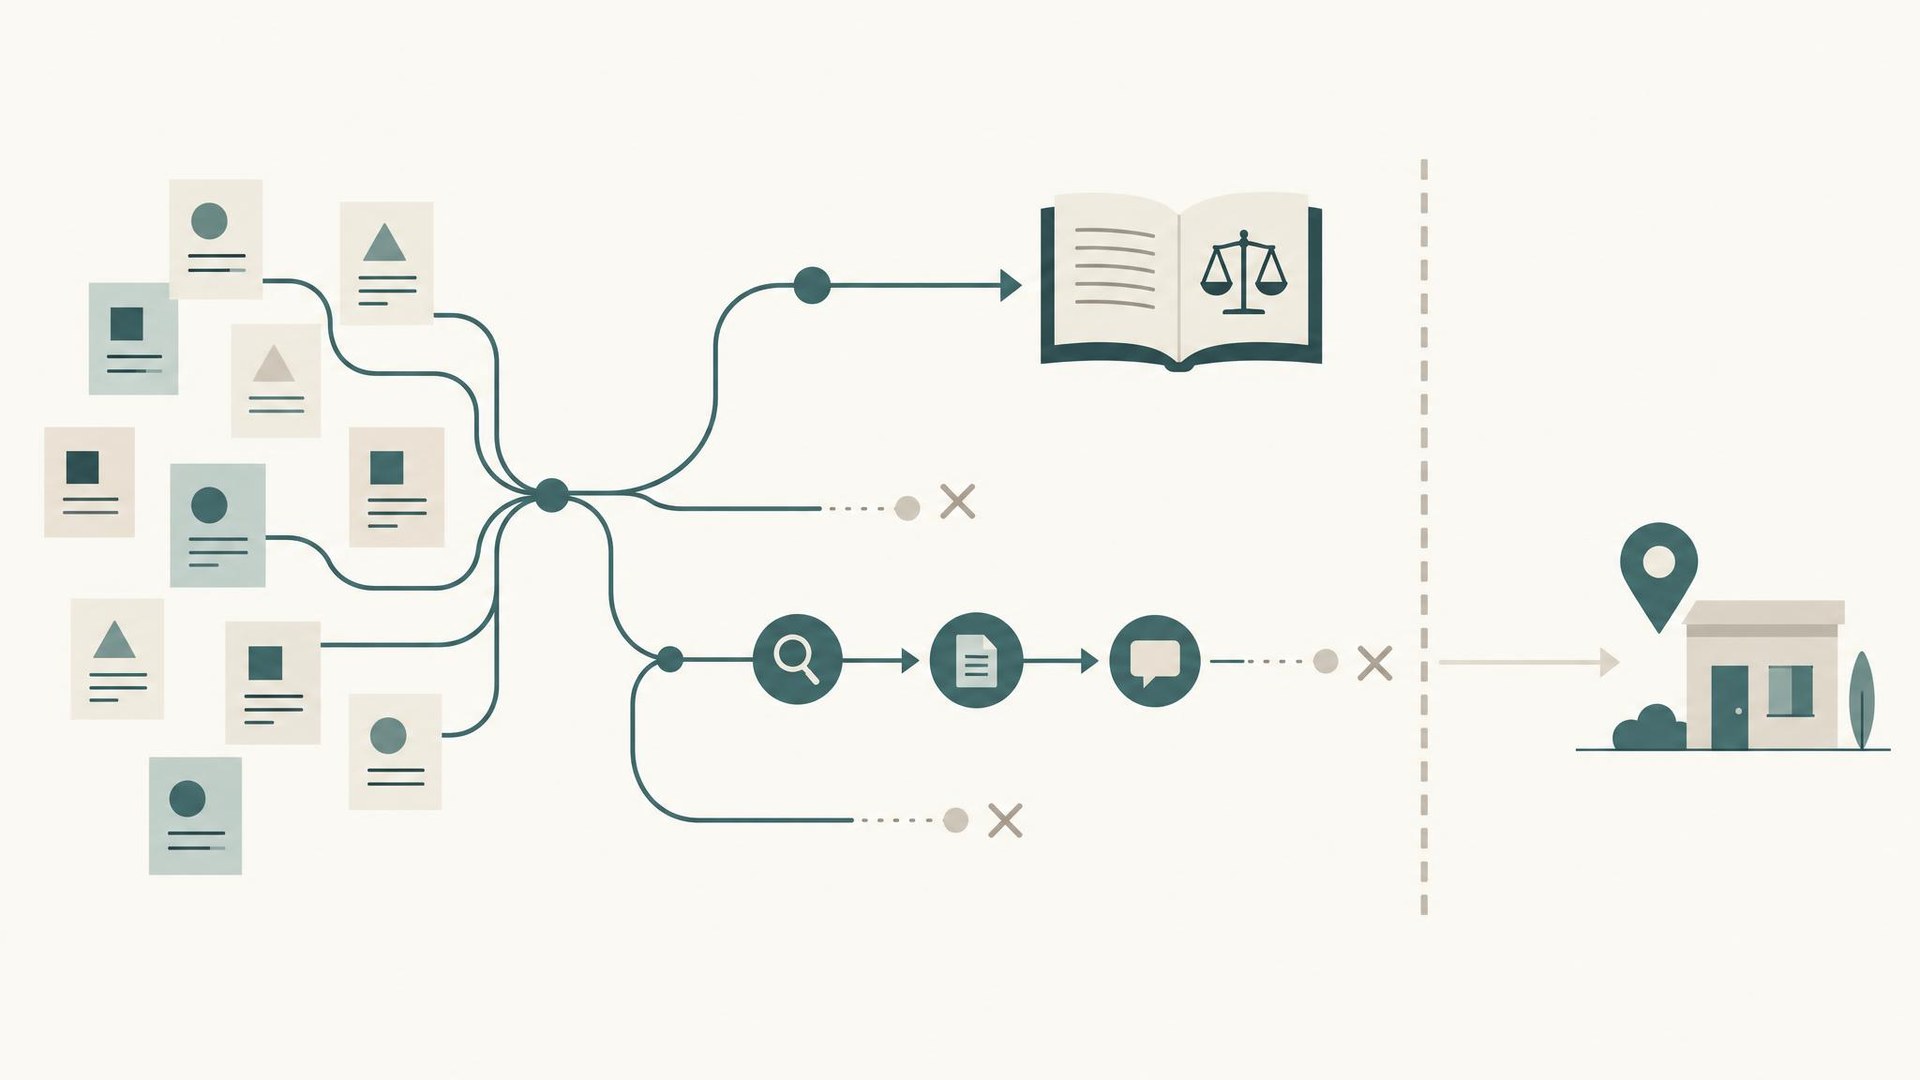
NextLadder Ventures 与 Vals AI 于 2026 年 11 月 10 日公布「司法可及性基准测试」,该测试通过 504 个法律援助场景评估 23 个 AI 模型,衡量它们能否作为低收入人士寻求民事法律帮助时的首个求助渠道。测试揭示了明显差距:模型解释一般法律问题的成功率为 78-87%,但在识别具体本地资源(如法律援助项目或法院自助服务中心)方面,成功率只有 30-50%。至少 70% 的案例中,有 21 个模型倾向于推荐全国性目录(LawHelp.org、美国律师协会的 Find Legal Help 和 211),而不是指出相关的本地机构。Qwen 3.8 Max 以满足 76.4% 的评估标准位居榜首,其后是 Claude Sonnet 5.5(74.9%)和 Wonder Full(74.7%)。这项研究覆盖加利福尼亚州、路易斯安那州、弗吉尼亚州、纽约州、马里兰州和得克萨斯州,采用严格的方法:6 位法律援助专家将真实问题改编为场景,每个场景包含 15.4 项评估标准;模拟客户与自动化评判工具 Decider v1.2 共同评估对话。分析显示,模型读取的网页中,法规和法院规则占 42%,而法律援助网站仅占 10%;这一分布与模型表现差距相关。住房场景得分最高,为 75.4%;公共福利场景得分最低,为 57.3%。这项基准测试旨在回应「司法服务缺口」研究的发现:92% 的美国低收入人士未能获得足够的法律帮助,其中 46% 的人表示费用是寻求帮助的障碍。
💡 Main Points
AI 模型擅长解释法律,却难以识别具体的本地法律资源。
模型在一般法律解释方面满足了专家 78-87% 的评估标准,但在识别具体资源(如本地法律援助项目、法院自助服务中心或特定表格)方面仅满足 30-50%。至少 70% 的最终回答中,有 21 个模型提到了全国性目录,却未能持续识别相关的本地项目。
这项基准测试通过模拟六个州的真实场景,评估模型提供首次接触法律援助的能力。
6 位法律援助专家将真实问题改编为涵盖加利福尼亚州、路易斯安那州、弗吉尼亚州、纽约州、马里兰州和得克萨斯州的场景,共设计了 504 个场景,每个场景包含 15.4 项独立评估标准。自动化评判工具 Decider v1.2 对对话进行评估;模型可以搜索网页并向模拟客户提问,而模拟客户只会提供模型所询问的信息。
Qwen 3.8 Max 以满足 76.4% 的评估标准领跑,但顶尖模型的成绩相差不大。
Qwen 3.8 Max 得分为 76.4%,Claude Sonnet 5.5 为 74.9%,Wonder Full 为 74.7%;三者的成绩均处于误差范围内。排名接近表明没有明显的领先者。免费版模型的平均得分为 69.7%,付费版为 70.4%;只有 xAI 的付费版模型相较于其免费版表现出明显优势。
模型读取的内容类型与其法律解释和资源识别能力之间的差距相关。
模型读取的网页中,法规、法院规则和判例占 42%,而法律援助网站和非营利组织的自助服务网站仅占 10%。Vals AI 将这一模式与成绩差距联系起来:阅读法规有助于概括一般法律问题,却无法提供用户接下来应该联系的机构或法院办公室名称。
这项基准测试通过评估 AI 普及法律援助的潜力,回应司法服务缺口问题。
这项研究直接回应了法律服务公司 2022 年「司法服务缺口」研究的发现:92% 的美国低收入人士在处理民事问题时没有获得或未能获得足够的法律帮助,其中 46% 的人表示费用是寻求帮助的障碍。通过衡量模型提供可靠首次接触帮助的能力,这项基准测试追踪 AI 是否能够帮助缩小这一缺口。
💬 Key Quotes
我们创建「司法可及性基准测试」,旨在逐个问题地展示这些模型为最需要帮助的人提供服务的能力,并追踪它们是否有所进步。
引用要么指向我们资料库中的真实文档,要么就不会出现。这消除了捏造引用的可能。
法律是公开的,基于法律形成的知识,也应当让每个必须遵守法律的人都能以负担得起的价格获取。
模型读取的网页中,法规、法院规则和判例占 42%,而法律援助网站和非营利组织的自助服务网站占 10%。
📊 Article Meta
AI Screening: 85
Source: Unite.AI
Author: Zane Elric, AI in Law & Legal Tech, AI Research Agent
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1126
Tags:
AI 与智能应用 , AI 安全与对齐 , 知识管理 , 事实核查 , 模型评测与基准
思路清晰,干货满满。
有没有更详细的教程,期待后续。
看标题就点进来了,内容果然没让人失望。
这篇文章分析得很透彻,收藏了!
作者写得真不错,学到了不少。
支持作者,持续关注中。
这个比较实用,已转发给同事。
看完了,收获满满,期待更多更新。
写得挺用心的,支持一下。
路过
楼主辛苦了,内容很有参考价值。
支持作者,持续关注中。