Uber 如何防御重试风暴
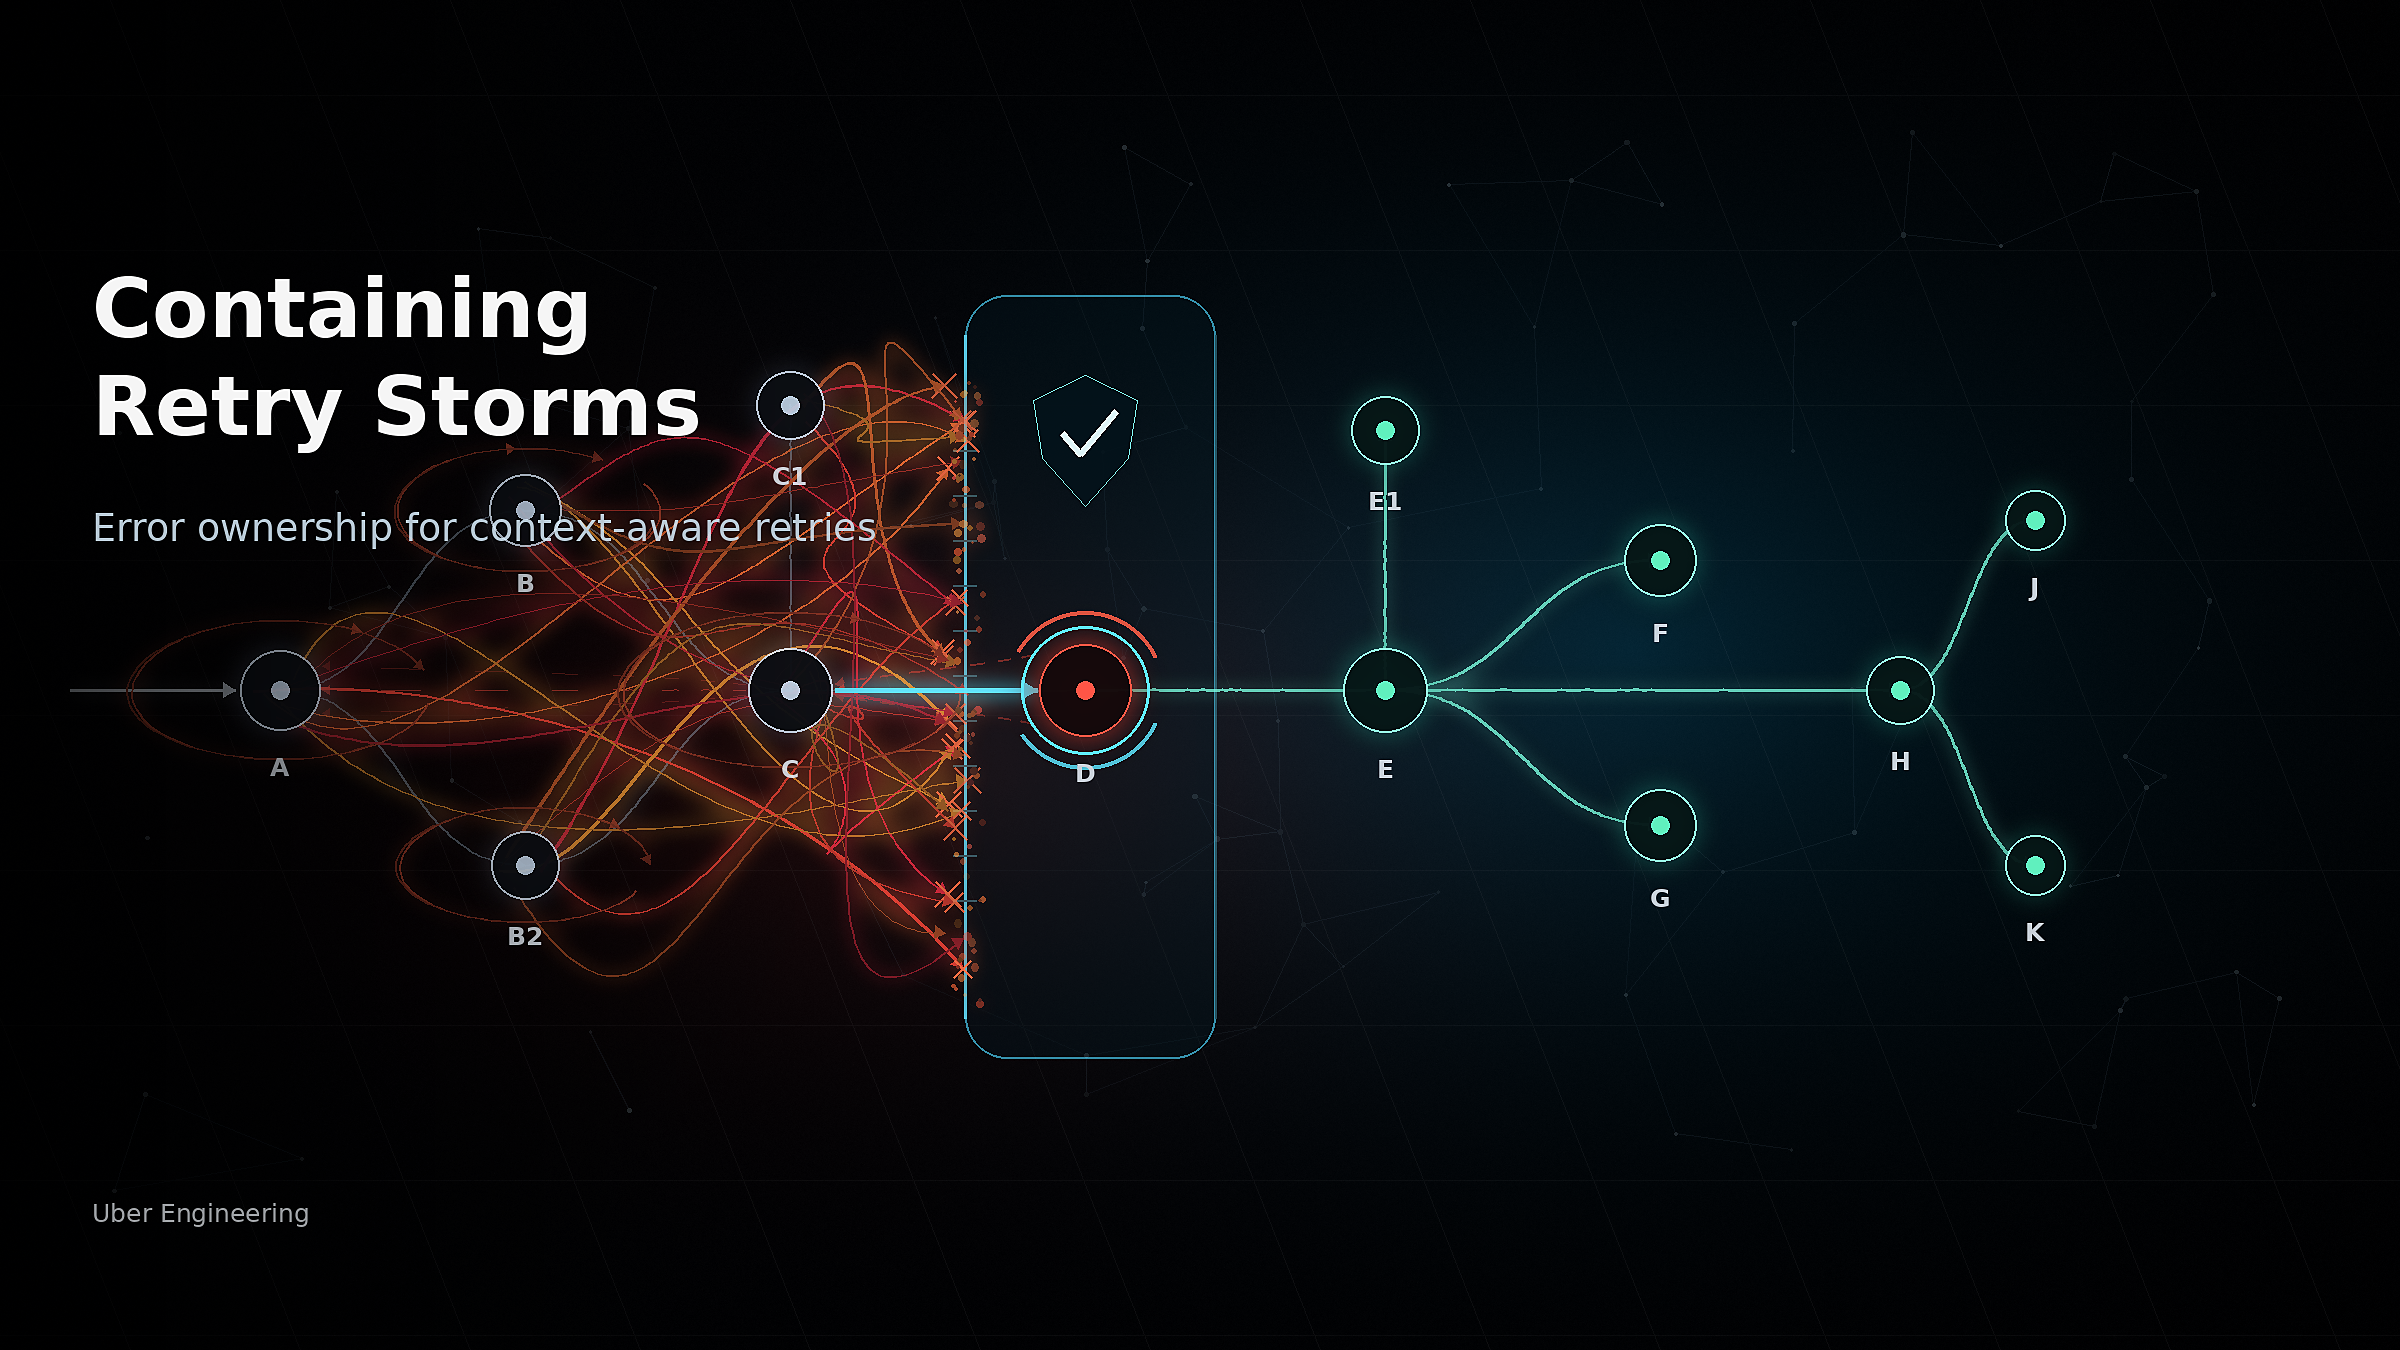
📌 One-Sentence Summary Uber 实现了一种上下文感知的「错误所有权」机制,通过区分服务自身导致的错误与仅从下游依赖传播的错误,有效防止重试风暴。 📝 Summary 为了应对深层微服务依赖链中重试风暴引发的「多米诺骨牌效应」,Uber 开发了一套基于错误所有权概念的系统。与统一应用的传统重试预算不同,该机制利用服务依赖分析方案将入站和出站故障进行关联。如果服务的错误是由下游故障引起的,该错误将被标记为「症状」且为「未认领」状态,从而告知上游调用方不要重试;如果该服务是根因,它将「认领」所有权,允许直接调用方进行重试。这种方法在优化可用性的同时,防止了服务降级期间请求量的指数级放大。 💡 Main Points 重试风暴源于标准重试配置缺乏上下文感知能力。 在深层调用链中,统一的重试策略会导致请求呈指数级放大(R^depth * N),单个下游故障就可能使整个技术栈崩溃。 核心解决方案是建立「错误所有权」。 通过区分「原因」(产生错误的服务)和「症状」(传播下游错误的服务),Uber 可以选择性地抑制那些只会增加下游服务负担的重试。 实现依赖于入站与出站故障的关联分析。 系统利用服务依赖分析方案来确定错误是被认领还是未认领。只有当下游服务认领错误所有权时,上游调用方才会执行重试。 系统包含针对「至少一次」重试和上下文丢失的保护机制。 为了防止可用性下降,系统确保在配置允许的情况下至少发生一次重试,并通过限制重试扰动的影响半径来处理上下文传播中断的问题。 💬 Key Quotes 虽然重试配置调优和重试预算在服务层面提供了有效的缓解,但它们依赖手动配置,且缺乏对深层依赖链和扇出模式引起的跨服务放大效应的可见性。 如果一个服务为了完成请求而调用 N 个出站接口,且其中一个出站错误导致该服务返回错误,那么该服务返回的错误仅仅是一个「症状」。 在服务错误率较高期间,错误不太可能是随机发生的,增加重试次数并不能带来收益,反而可能导致进一步的性能恶化。 📊 Article Meta AI Screening: 90 Featured: Yes Source: Hacker News Author: Hacker News Category: 软件编程 Language: 英文 Read Time: 13 min Word Count: 3049 Tags: 编程与工程 , 系统设计 , 性能优化 , 分布式系统 , 微服务架构 Read Full Article
刚好最近在找这方面的资料,太及时了。