投机解码详解:如何让任意 LLM 的推理速度提升 3 倍 - MachineLearningMastery.com
📌 One-Sentence Summary
投机解码通过将快速草稿模型与并行验证相结合,在不改变模型权重或输出质量的前提下,消除内存带宽瓶颈,将 LLM 推理速度提升 2–3 倍。
📝 Summary
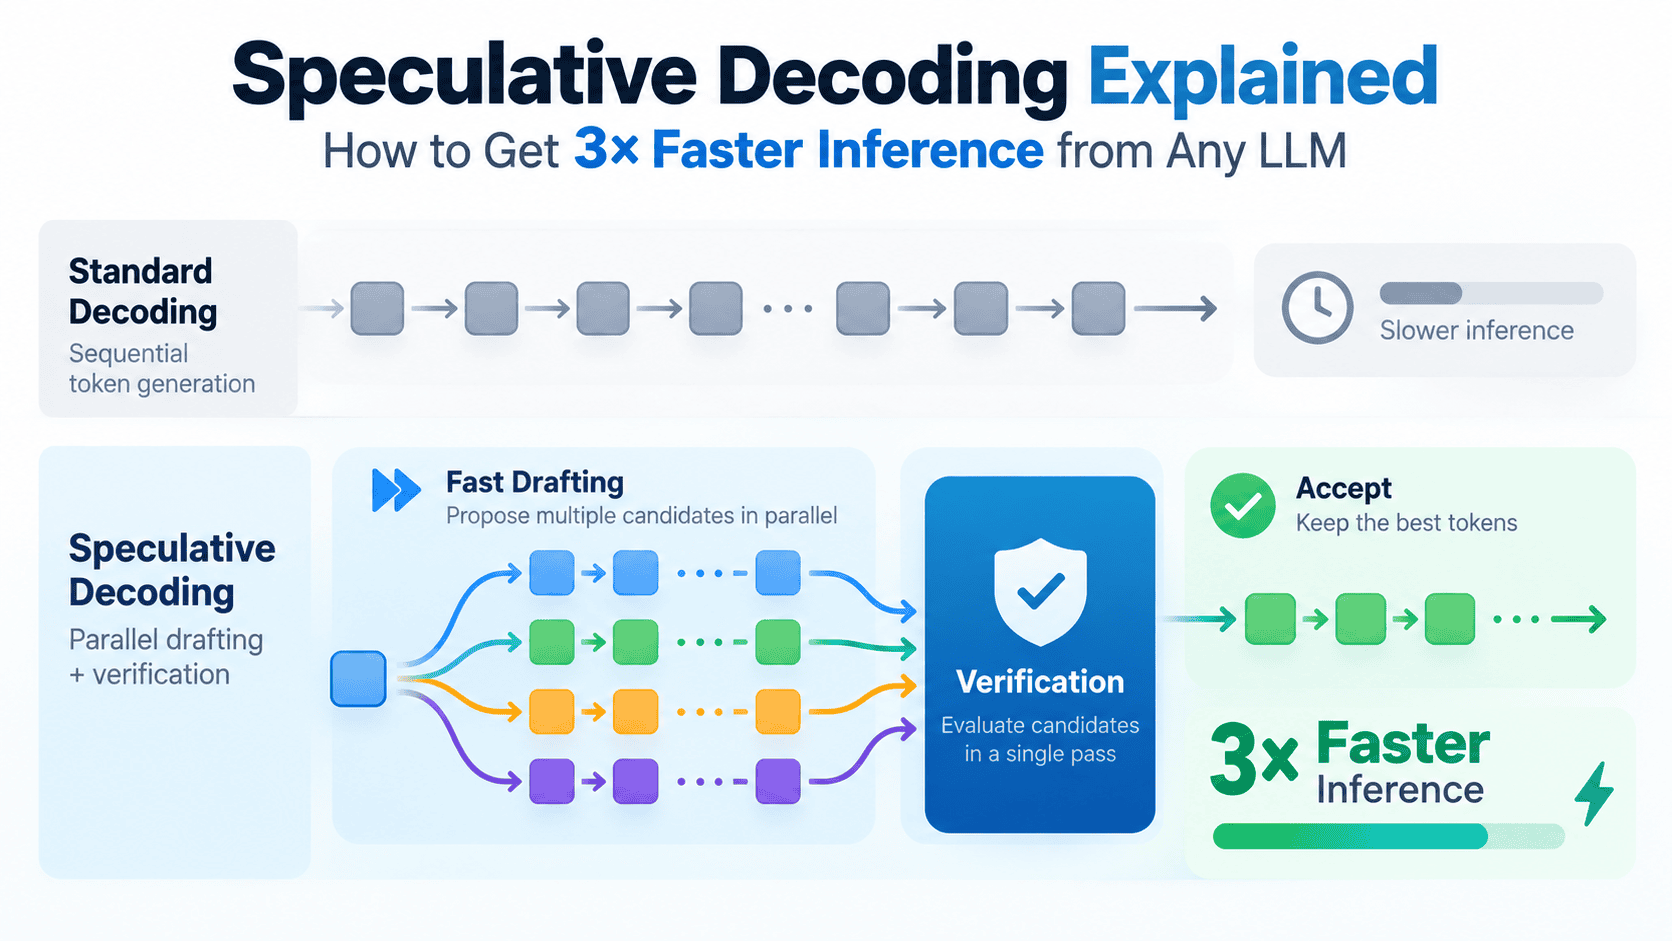
本文解释了投机解码如何加速大语言模型推理。文章首先指出核心问题:LLM 受限于内存带宽,意味着 GPU 计算单元处于空闲状态,等待每生成一个 token 时从内存中传输数十亿模型权重。投机解码通过使用小型草稿模型快速生成多个候选 token,再由大型目标模型在单次并行前向传播中验证这些候选 token 来解决该问题。文章逐步讲解了草稿-验证循环,解释了保持目标模型精确输出分布的数学保证,并介绍了包括 Medusa、Eagle 和 Prompt Lookup Decoding 在内的现代变体,这些变体消除了对独立草稿模型的需求。文章最后给出了关于投机解码何时最有效的实用指导——更长的输出、单请求服务和词汇丰富的任务——并指出在重度批处理场景下它可能反而降低吞吐量。
💡 Main Points
LLM 受限于内存带宽,而非计算能力
像 H100 这样的现代 GPU 在矩阵运算方面极其快速,但瓶颈在于每生成一个 token 时,需要将数十亿模型权重从 GPU 内存传输到处理器。这使得计算单元处于空闲状态,导致逐 token 生成本质上很慢。
投机解码采用双模型草稿-验证方法
小型草稿模型快速生成 4–8 个候选 token,然后大型目标模型在单次并行前向传播中评估所有候选 token。这样只需加载一次目标模型的权重并将其应用于多个 token,从而大幅提升 GPU 利用率。
输出分布在可证明意义上与标准自回归生成完全一致
当目标模型拒绝某个草稿 token 时,它会从一个经过调整的分布中采样,该分布在数学上考虑了两个模型预测之间的差异。这种校正保证了最终输出与目标模型的分布完全匹配,而非近似匹配。
现代变体消除了对独立草稿模型的需求
Medusa 在目标模型本身上附加额外的预测头;Eagle 利用目标模型的内部隐藏状态获取更丰富的上下文;Prompt Lookup Decoding 扫描对话历史中的重复短语。部分方法以牺牲严格的分布保证换取更简单的实现,不过实际质量影响可以忽略不计。
在典型 70–80% 接受率下,最佳情况可提速 2–3 倍
当所有草稿 token 加上一个额外的目标 token 全部被接受时,系统大约以一次目标模型前向传播的成本生成 5–9 个 token。该技术最适合较长的输出、单请求服务以及词汇可预测的任务(如代码编辑和摘要)。在重度批处理服务中,它实际上可能降低吞吐量。
💬 Key Quotes
瓶颈不在于原始计算速度。像 NVIDIA H100 GPU 这样的现代 AI 硬件在驱动这些模型的矩阵数学运算方面极其快速。问题在于,模型的数十亿参数存储在 GPU 内存中,在生成每个 token 之前,所有这些权重都需要从内存传输到处理器中。
正是这种调整保证了最终输出与目标模型的分布完全匹配,然后循环从那里重新开始。
当接受率在 70% 到 80% 左右时——这是匹配良好的模型对在常见任务上的典型水平——实际提速落在 2 倍到 3 倍之间。
高吞吐量批处理服务则是另一回事:在重度批处理场景中,投机解码实际上可能降低吞吐量,因为草稿 token 消耗了本可用于服务更多请求的内存和计算资源。
📊 Article Meta
AI Screening: 85
Source: Machine Learning Mastery
Author: Vinod Chugani
Category: 人工智能
Language: 英文
Read Time: 6 min
Word Count: 1490
Tags:
AI 与智能应用 , 模型训练与推理 , AI 工程 , LLM 推理优化 , 提示工程
很有价值的分享,感谢整理。
楼主辛苦了,内容很有参考价值。
整理得太全面了,省了我不少时间。
整理得太全面了,省了我不少时间。
不错不错,已加入书签。
有没有更详细的教程,期待后续。
刚好最近在找这方面的资料,太及时了。
路过
路过
整理得太全面了,省了我不少时间。
思路清晰,干货满满。
收藏了,以后慢慢研究。