Torc 自动驾驶用 Ray 重构多模态 AI 训练栈:从割裂管线到一切皆变换
一句话结论
Torc Robotics(2005 年成立、20 年安全关键自动驾驶经验、瞄准 2030 年 2000 亿美元无人卡车市场)的两位 ML 工程师 Neil 和 Yash 复盘了用 Ray 重构多模态 AI 训练与仿真基础设施的全过程:核心方法论是”一切皆变换”(everything is a transform)的组件库 + 四类 DAG 图,把组织里散落的重复管线收敛成可组合的共享库,16 个月内数据量涨 10 倍无需重构架构,GPU 实例越调越少而吞吐持续走高。
为什么是 Torc:20 年安全关键系统的 AI 转型
Torc 2005 年成立,总部 Blacksburg、商业枢纽 Dallas-Fort Worth、工程中心在 Ann Arbor 和 Montreal(后者与 Mila 中心有 AI 创新合作)。使命是用安全、可持续、创新的方式把无人驾驶半挂卡车在美国全面商业化,主攻长途货运。公司选择与 Anyscale 同场研讨,也印证了其基础设施层深度共建的关系。
市场判断给足了背景:仅美国市场,2030 年自动驾驶卡车规模约 2000 亿美元;同年长途货运司机缺口预计 16 万人——从业者老龄化导致极高流动率;美国 90% 以上交通事故源于人为失误;任何一条卡车路线约 16% 的里程是空驶(司机返程、通勤),有环境代价却无业务价值。自动驾驶是安全、运力、环保三重问题的同一个解,这也是 Torc 把商业主张锚定长途货运而非城配的原因:里程长、路线固定、司机缺口最痛。

两位讲者分工明确:Neil 是资深工程师、MLOps 技术负责人,管可扩展训练、数据生成、自动标注和测试,自称”公司首席 Ray 布道者,口头禅是’Ray 太棒了,这个为什么不用 Ray’“,常年在公司内外培育开发者社区;Yash 是高级 ML 工程师,带批处理和 RL 训练框架,专注多模态负载的全栈,此前是 ML 科学家后转工程,Base 奥斯汀。
AV3.0:端到端可微 + 可组合模块 + 启发式护栏
产品架构的演进路线值得细看。行业从纯启发式方法走到端到端黑盒,数据驱动工程让数据成为加速的护城河,但黑盒化牺牲了可观测性和模块级调优能力。Torc 的 AV3.0 取中间路线:端到端学习的架构 + 可组合、可内省的模块 + 挂接启发式护栏——把”ML 可以很好”的 AV2.0 时代推进到”ML 可以很安全”的 AV3.0 时代。
架构分三大段:感知、预测、规划,全部连在一个端到端可微优化过程里。关键不在每个模块是否都用深度模型,而在能用数据驱动方法端到端优化整个系统——既能单独改进某个模块,也能联合优化全链路。以感知栈的一个切片为例:图像进相机分支 → 在线标定组件 → 鸟瞰图投影 → 3D 场景模型。这只是感知栈众多数据流中的一条。逐模块迭代训练的坑:一个极强的在线标定组件未必能转化为端到端性能提升——组件级指标涨了,整车行为没变;模块化+端到端可微训练让”组件可观测”与”整机行为可优化”兼得,上游特征提取方式也会随下游需求联动调整。
数据格式的教训同样来自这段演进:各系统自定数据格式的年代,同一份传感器数据要为不同任务重复准备多套特化版本。AV3.0 的统一端到端数据集要求”数据不再按训练任务特化”——一份多模态数据池支撑全链路优化,这对管线的吞吐与弹性提出了远高于从前的要求,也是后文选择 Ray 的直接动因。
数据闭环:前向通路做工程,反向通路做需求
数据工程环路被拆成前向和反向两个概念相位。前向通路:卡车采集数据、神经渲染/数据生成、第三方数据,流过自动标注、数据治理、数据准备系统,蒸馏出对下游有效用的数据池,再送模型训练——这是数据驱动的产品工程。反向通路:从数据分析和组件/系统性能洞察出发,蒸馏出两类需求——数据需求(哪里需要补采、哪些场景要渲染加强)和产品需求(指标计算与测试覆盖的缺口,反哺长尾场景测试集)——这是数据驱动的需求工程。两环咬合构成产品开发的完整数据闭环。
这个闭环的精妙处在于需求方向是双向的:不只”数据服务模型”,模型的性能洞察反过来定义”该采什么数据”。测试覆盖的缺口会被翻译成新数据集需求,用神经渲染补造长尾场景——需求工程本身也被数据驱动了。
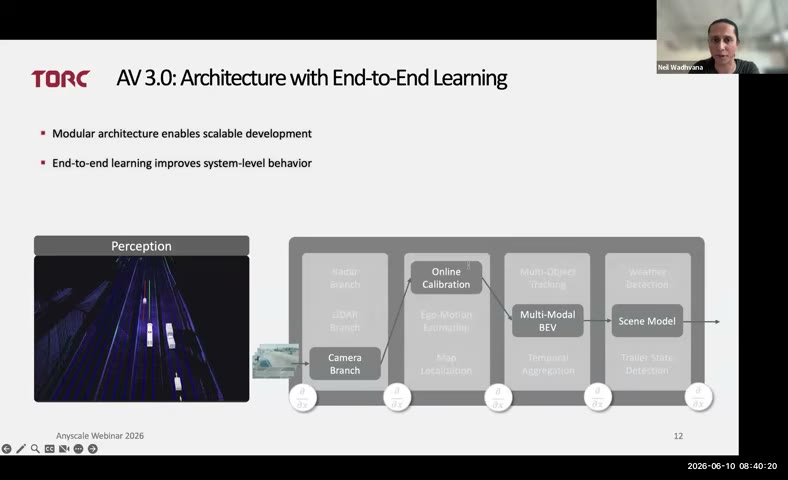
历史包袱直白 candid:AV1.0/AV2.0 时代各系统各自为政——ECS 服务、SageMaker 管线、批推理作业混用,各定数据格式、各建指标与优化环、各引库,代码分裂散落全组织。Neil 引用 Google 2015 年那篇机器学习系统隐藏技术债论文自嘲:实际 ML 工作只占一小块,配套的数据采集、配置、资源池管理、验证流程每个管线都自建一套。重构 AV3.0 支撑系统的四项核心需求:组件组合爆炸的灵活拼接与联合调优、更大规模多模态数据(数据不再按训练任务特化,而是支撑端到端优化的统一数据集)、跨组件的梯度/信息通路(前后向都要通)、同时支持开环(批训练)与闭环(RL/仿真)。
四层架构与”一切皆变换”
选定的高层架构自下而上四层:通用算力与云系统层(S3/表格存储、通用与专用硬件调度)→ Ray 原语层(Ray Core + Ray Data/Train/Tune/Serve)→ 共享组件层(读写 IO、稠密数据变换如传感器、稀疏数据变换如目标检测过滤、含 GPU 型变换如推理/点云体素化)→ 应用框架层(复用共享组件的训练/仿真应用)。
灵魂方法论是”为什么不把它做成一个变换?“——变换单元定义为”进数据、出数据”的操作,既可跑在 GPU(模型推理、点云体素化)也可分布在任意多 CPU。只要输入输出类型明确,变换即可自由组合。由此自然推出第二个原则:如果一切皆变换,那任何大规模系统就是一张图(DAG)。批训练与自动标注共享读数据、体素化等变换,只是模型算子模式不同(训练态收梯度更新 vs 推理态前向出结果);图末端挂灵活的 sink——调试、流式写云、本地可视化皆可。图在 Ray 原语上灵活调度、远程部署,集群调度变得简单。
共享组件层的账要算两层:显性收益是消灭重复实现(前文那些行为不一致的 IoU 们);隐性收益是优化外溢——MLOps 团队对一个变换的融合优化,所有引用它的应用自动受益。散装管线时代每个团队的优化都是孤岛,统一组件库之后优化变成公共财产。这正是 Neil 说”不复用学习成果就会溺死在胶水代码里”的账本依据。
变换库同时承担了算力亲和性的声明:每个变换自带资源需求标注(CPU 型/GPU 型/内存型),调度器据此把它放到对的节点。模型开发者写变换时不需要想集群拓扑,这是”把工作分发到尺寸合适的算力”能自动成立的机制基础。
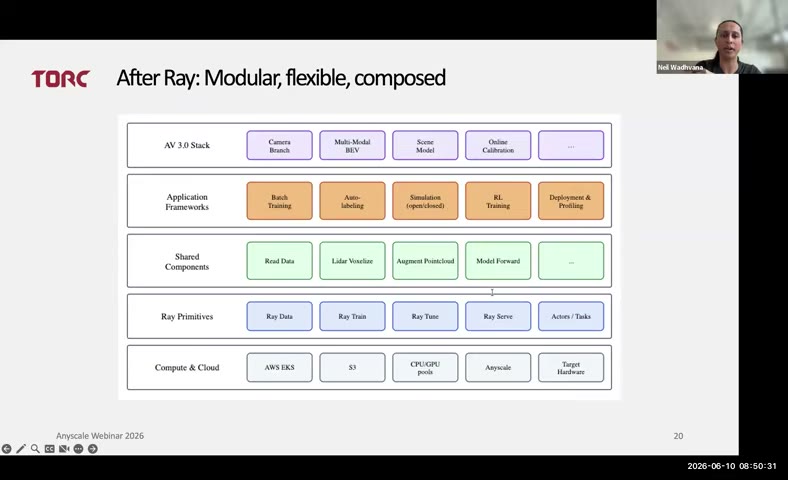
四类核心 DAG 图成型:批训练图(开环流式:读数据→增强→流式进模型→存指标)、自动标注图(同为开环,仅模型算子换推理态)、开环仿真图(回放路面实录或渲染数据)、闭环仿真图(组件每步反馈进世界仿真器,行为不得破坏物理与交规)。RL 训练框架是闭环仿真的再扩展:仿真器反馈环 + 策略优化环双环咬合。
四类图各自的长尾难点值得记录。批训练要吃”单轮多 TB”的数据量——每个 epoch 流过管线的数据以 TB 计,吞吐稳定性是生命线。自动标注看似只是换模型模式,实则对”同一变换库在不同算子模式下行为一致”提出了工程要求。开环仿真相对简单:数据流单向,回放即可。真正的难题在闭环:组件的行为反馈进仿真器,每个时间步都依赖上一步输出,批处理式的并行假设失效,必须设计新的调度器——Torc 的模块化架构恰好把”闭环图的调度问题”与”组件本身的定义”解耦,调度复杂度不再污染业务代码。RL 再叠一层:不仅仿真器要收组件反馈,策略本身还要按梯度步更新,双环同步是框架级挑战。
GPU 饥饿的分布式解法与调度自由度
规模化四挑战:缝合散落重复的代码管线、饿着的 GPU(等 IO、等数据、或与重 CPU 任务混部)、更大规模数据、闭环整合。Neil 对旧管线的吐槽足够生动:“我都不好意思说组织里有多少个 IoU 实现——而且它们行为还不一致。“解法核心一句:把工作分发到尺寸合适的算力上。CPU 密集的变换横向摊到便宜的 CPU 实例,GPU 只接收热流数据满负荷处理。
调度视角的变化最有说服力:2025 年 1 月刚起步时排了一堆欠利用的 GPU 实例;随着工作负载优化,GPU 实例数显著下降、CPU 实例承担更多,吞吐不降反升。用户侧的连锁反应是”越用越敢用”——调度更复杂负载的意愿随易用性上升,看板上 GPU 作业数量与种类都在增长。
多任务目标检测/感知训练的优化实例:从 PyTorch Lightning 基线出发,单机多卡与多机多卡都显著优化。Neil 最喜欢的一张图:同样吞吐既能在 G5.48xlarge 大密度 GPU 实例上达成,也能在 32 张分散于更便宜、更易得的 G5.16xlarge/G5.24xlarge 上达成——调度依据从”算力类型”变为”GPU/CPU 类型”,可按云厂商当刻现货 gang schedule,灵活性直接转化为更多作业同时在跑。
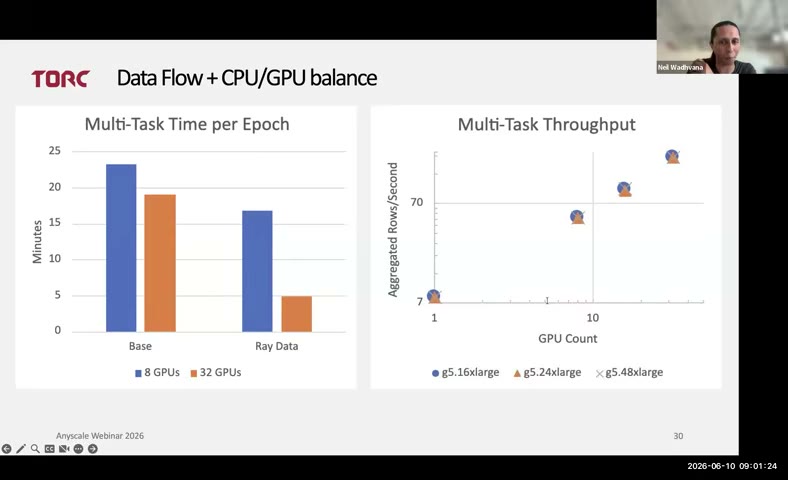
数据规模侧的账本:单训练 epoch 轻松数十 TB,16 个月内涨 10 倍——图像目标检测管线 2025 年 1 月平均 4 TB/轮,到 4 月约 40 TB/轮,全程未重构训练作业,只做分发与调优。Neal 特别强调这笔账的隐含前提:因为一开始就选了 Ray 的横向扩展路线,数据涨 10 倍的代价只是”花更多时间或更多算力钱”,而不是推倒重来——这是架构选型在两年后兑现的复利。自动标注管线同理:10 月某数据抽取作业 2 小时+,如今同管线叠加点云聚合、图像下采样等更多步骤反而更快。
组织设计:两个团队,how 与 what 分治
Yash 的第一课不是技术而是组织:“团队交付的就是组织架构图”——把这条老定律反过来用。MLOps 团队(与 Anyscale 专家协同)管”怎么扩”:吃透分布式系统难题、调参把作业跑出性能,拥有横向扩展与优化层。模型开发者管”扩什么”:写变换和应用逻辑,不要求是 Ray 专家。两层之间的合同就是共享变换库——模型开发者把变换写一次,MLOps 负责放大。团队内部已沉淀的调优招数(变换融合、动态 shuffle、内存清理、自定义可观测指标)按设计沉淀进库,成为组织能力而非个人技巧。
这套分治的可复制性值得强调:多数公司的困境是”懂模型的人不懂分布式、懂分布式的人不懂业务”,两者互相等待。Torc 的解法不是培训全能工程师,而是把接口收窄到一个变换库——模型开发者面对的分布式复杂度被库封装,MLOps 面对的业务复杂度被变换签名封装。招式固定后,甚至调优本身也开始”不看代码只看配置”。
鸟瞰模型训练是双向伸缩的实例:每行数据含多路 180 度环视相机加深度、激光雷达扫描,既可以加 GPU 提速,也可以在资源竞争时主动降速让路。配置优先(config-first)的文化:调优者不看代码,只改扩缩计算配置。
尺寸配对正确的收益:GPU 内存曲线平稳、利用率饱满——秘诀正是 Ray Data 异构计算层把变换调度到对的节点:CPU 变换跑 CPU worker,GPU 节点只留给 GPU 加速变换和模型前后向。结论反直觉但实在:不必买更大 GPU,把便宜 CPU worker 挂上去,贵 GPU 节点保持满载,成本显著下降;配合 Anyscale 的 spot 实例接入与切换能力再压一层。

91,000 场景的生产调优清单
真实生产作业:鸟瞰模型训练,约 91,000 个多模态场景流过 DAG,Anyscale 仪表盘直接可视化 Ray Data 的 map_batches 调用图——每个方框一个变换。仪表盘省掉了自建可观测体系的工作量,瓶颈定位与调参全部从看板出发。团队还自建了一个内部叫 throughput callback 的自定义观测点:吞吐掉下来先判断是管线问题(Ray Data 层)还是模型循环问题——吞吐正常就去优化模型,吞吐异常就回来修管线,这个二分法把诊断路径砍掉一半。
调优方法论三原则:先画像再调参、一次只改一处、让 Ray 接管背压策略。具体清单按收益排序:
- 融合同宿变换(Ray compute task 亲和策略):同节点数据聚合后连续跑变换,减少数据传输,直接稳住吞吐。
- 重 IO 前重分区:元数据密集时 Ray Data 自动收缩 block 数造成瓶颈,重 IO 变换前先 repartition。
- IO 并行加倍:把每任务 CPU 配额降到 1 以下,超额订阅 IO,吞吐再上一档。
- 昂贵 collate 前移进 Ray Data:张量化等重操作从训练循环挪进数据层,获得扇出并行。
- shuffle 降本:元数据上 shuffle 而非加载后的非结构化数据上;能免全局 shuffle 就免——块内 shuffle + 块内行 shuffle 的随机化对训练泛化足够,避免跨集群数据搬运。
Q&A 里 Neil 对 shuffle 策略做了更完整的展开,值得单独立一段:管线启动时先做索引级查询(数据集注册表或预编译索引集),不一次性加载稠密数据;任何全局操作(全局 shuffle、稠密变换)都尽量推到管线最早期;此后数据进入 block 抽象,块间顺序+块内行序的两级随机化即可满足训练泛化——因为再也不需要把分布全集群的数据重新打包一遍,吞吐保住了。Yash 的 TLDR 更直白:“结构化数据已加载进管线后再做全局 shuffle,作业吞吐直接被杀死。”
这些经验很快成为团队部落知识,下一步正在把它们固化成 Anyscale agent 技能——把”诊断、补丁、重部署”循环自动化。强调:每次优化都从仪表盘出发而非读代码,这正是团队分工(MLOps 不必熟悉每个领域变换)的可行性基础。
Arrow 优先与收尾四课
序列化教训:坚持 Apache Arrow 兼容优先、避免嵌套结构。自定义 Arrow 扩展类型触发大量对象 pickling,迁回 Arrow 原生 schema 后序列化/反序列化成本肉眼可见地下降——多数收益只靠 schema 改造就拿到。Yash 展示的对照表明:管线里流动的数据越贴近 Arrow 一等公民类型,对象拾取(pickling)越少;嵌套结构每多一层,分布式传输的隐性税就重一分。这对任何在 Ray 上跑多模态数据的团队都是零成本可抄的第一步。
Ray Train + Lightning 集成解决动态扩缩的学习率问题:学习率按 per-worker 设定,GPU 数量变化时自动缩放,多任务训练的复杂调度策略尚未成为实际瓶颈。数据隐私在数据准备步内处理(PII 脱敏、按标准选择性采样),迭代式数据环路保证新标准可回填历史数据。缓存策略坦承仍在迭代:完全流式系统上按需插桩缓存点,稠密缓存(预处理增强后的场景表示)与稀疏缓存(查询结果复用)因地制宜,没有万能解。Neil 对缓存问题的展开揭示了深层矛盾:传统”为特定模型准备完美数据集”的缓存思路,在”数据、代码、模型三者同时快速迭代”的现实下失效——今天缓存的中间产物明天就可能因为上游变换改了而作废,所以缓存点必须与代码版本和数据版本联动选择。
收尾四课:多模态架构让平台债与框架债指数级增长,不模块化、不复用学习成果就会溺死在胶水代码里;Ray 让你选择”横向扩展开销”而非”完美优化每个单体应用”,灵活服务训练与测试的多样需求;正确尺寸的算力组合中,CPU 才是最重要角色——它让昂贵 GPU 拿到数据和支持;系统设计决定框架复杂度,“一切皆变换”让开环闭环系统都以可组合、可复用的方式搭建。
对”Ray 为什么适合多模态”的收尾论证:多数分布式数据处理框架为表格/批式数据设计,而多模态负载的复杂度来自单点数据体积(几百 MB 一条)与稠密/稀疏混合的变换链,需要 GPU 间传输、Arrow 序列化、字节流传输这类底层优化——Ray 恰好在这些原语上深耕,稀疏与稠密数据统一调度。两位讲者最后预告了 8 月的 Ray Summit,并开放了 LinkedIn 联系方式。

原文信息
- 原视频标题:How Torc Robotics Scales Multimodal AI for Autonomous Driving with Ray
- 频道:Anyscale
- 讲者:Neil(Torc 资深 ML 工程师、MLOps 技术负责人)、Yashwadan Chhatruvei(Torc 高级 ML 工程师、批处理与 RL 训练框架负责人)
- 发布日期:2026-06-10
- 视频时长:约 60 分钟
内容翔实,正好需要,先收藏再看。
赞同,实践出真知。
点赞,必须点赞