通过自动化红队测试提升 LLM 安全性的模糊鲁棒性
📌 One-Sentence Summary
OpenAI 展示了如何通过扩大测试时计算量并采用 worst@n 标准进行自动化红队测试,生成可靠的对抗训练数据,大幅提升 GPT-6 Astra 在网络安全、生物学等高风险领域抵御越狱攻击的模糊鲁棒性。
📝 Summary
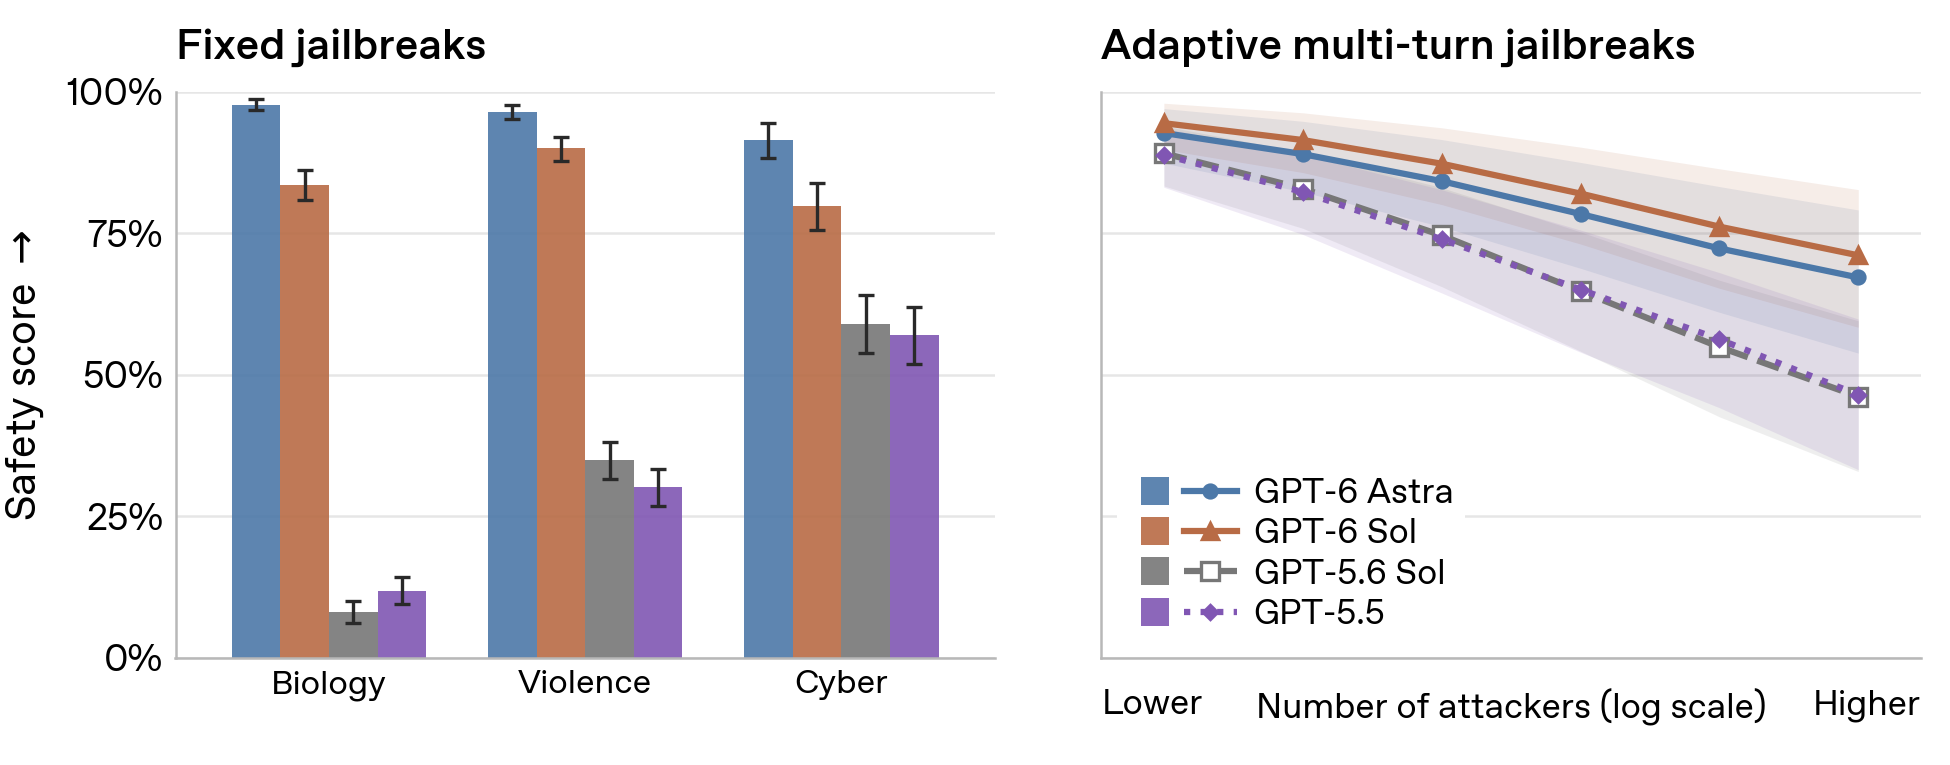
OpenAI 提出了一种提升 LLM 在网络安全、生物学等高风险领域安全性模糊鲁棒性的方法,因为这些领域的安全规范本身就难以明确界定。该方法扩大自动化攻击者在测试时的计算量,以搜索越狱攻击,并要求攻击在重复测试中均取得成功(worst@n 标准),从而生成可靠的对抗训练数据。在受控实验中,使用这些数据训练后,模型在多项评估中的鲁棒性均有所提升,包括抵御自适应多轮攻击者的能力。研究人员将该方法用于改进 GPT-6 Astra 和 Sol,结果显示,模型在面对固定和自适应越狱攻击时的安全评分显著提高,同时仍能妥善回应无害请求。
💡 Main Points
扩大测试时计算量的自动化红队测试可生成可靠的对抗训练数据
该方法会不断优化提示词,直到防御模型给出不安全的回答,并要求攻击在重复测试中均取得成功(worst@n),从而生成高质量训练数据,提升模型鲁棒性。
使用经过鲁棒性强化的提示词进行训练,可显著提升模糊鲁棒性
基于自动化红队测试生成的合成越狱样本进行强化学习后,安全评分的初始饱和程度更低,并且会随着训练不断提高;而使用原始种子提示词训练则没有这种表现。
鲁棒性可泛化到自适应多轮攻击者等新型攻击方式
模型对自适应攻击者的鲁棒性有所提升。这类攻击者与用于生成训练数据的攻击者在性质上不同,表明模型成功泛化到了此前未见的攻击模式。
GPT-6 Astra 在安全性与帮助性之间实现帕累托改进
经过鲁棒性训练的模型能够更安全地处理有害请求,同时与早期模型相比,更不容易拒绝合理请求,说明安全性提升并未牺牲帮助性。
💬 Key Quotes
我们研究如何提升模型在网络安全、生物学等高风险领域的鲁棒性。在这些领域,许多任务具有双重用途,滥用可能造成重大危害。
通过扩大自动化攻击者在测试时的计算量来搜索越狱攻击,并要求攻击在重复测试中均取得成功——我们将这一标准称为 worst@n——我们生成了能够提升模糊鲁棒性的可靠对抗训练数据。
使用这些数据训练后,模型在多项评估中的鲁棒性均有所提升,包括抵御自适应多轮攻击者的能力。
在所有攻击者预算下,GPT-6 Astra 的鲁棒性都高于 GPT-5.6 Sol。
经过鲁棒性训练的模型更容易拒绝无害任务,而我们发现 GPT-6 Astra 并非如此。
📊 Article Meta
AI Screening: 90
Featured: Yes
Source: Hacker News - Newest: "LLM"
Author: Klaster_1
Category: 人工智能
Language: 英文
Read Time: 6 min
Word Count: 1281
Tags:
AI 与智能应用 , AI 安全与对齐 , Red Teaming , 模型训练与推理 , 安全
支持作者,持续关注中。
写得挺用心的,支持一下。
收藏了,以后慢慢研究。
有没有更详细的教程,期待后续。
思路清晰,干货满满。
支持作者,持续关注中。
收藏了,以后慢慢研究。
讲解得很细致,新手也能看懂。
赞同,实践出真知。
很有价值的分享,感谢整理。
讲解得很细致,新手也能看懂。
这个观点很中肯,深有同感。