通过 Agents CLI 评估实现智能体质量的爬山式提升
📌 One-Sentence Summary
本文演示如何使用 Agents CLI 通过迭代评估系统性地提升智能体性能,包括检测回归、比较模型后端以及安排自动化检查。
📝 Summary
本文提供了一份分步指南,介绍如何使用 Agents CLI 为 AI 智能体构建质量工程闭环。内容涵盖运行初始评估、识别由配置错误引发的回归、比较不同模型后端的性能,以及建立自动化监控以捕捉未来问题。其目标是帮助开发者在底层模型和工具不断演进的过程中,长期维持智能体的高质量。
💡 Main Points
迭代评估的重要性
构建一个可靠的智能体,远不止于一次成功的演示。它需要持续的测试与改进闭环,以确保智能体在面对模型、数据或环境变化时依然保持稳健。
检测细微的回归
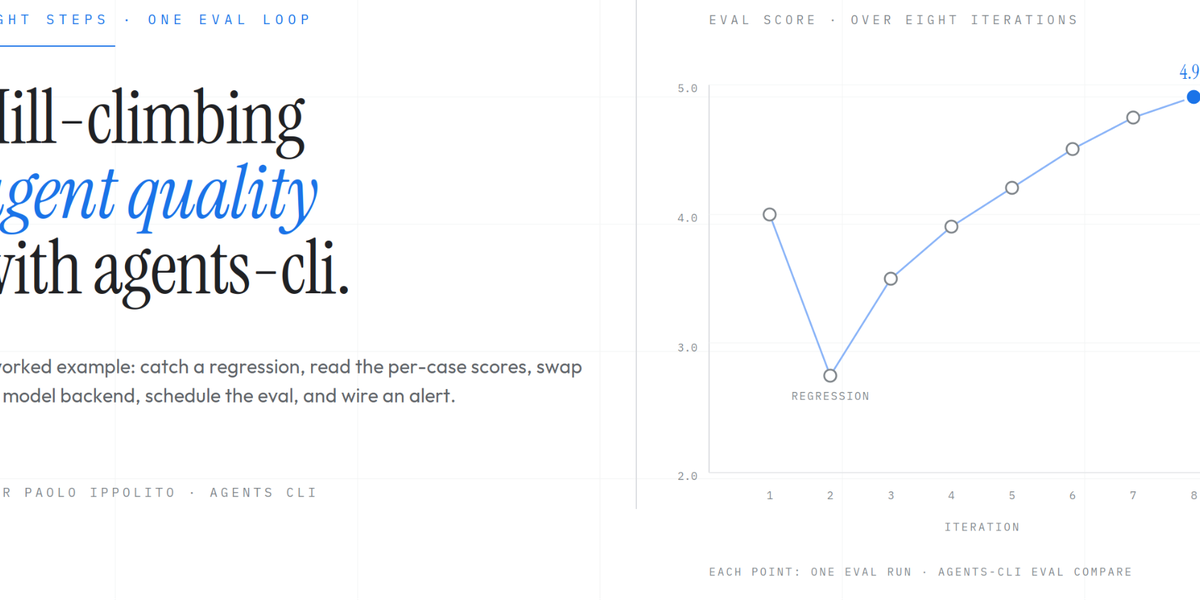
文章强调了 Agents CLI 如何识别出标准单元测试或人工检查可能遗漏的显著性能下降(例如「厨师提示词」回归),因为这类问题往往表现为模型行为的变化,而非代码本身的改变。
比较模型后端
指南展示了如何使用 CLI 比较不同语言模型(例如 Gemini 3.8 与 2.5)的性能,以确定特定用例下最具成本效益的选项,并强调需要查看逐用例数据,而非仅看平均分。
自动化监控流程
为了在问题进入生产环境之前将其捕捉,文章介绍了如何安排定期评估运行并为质量显著下降设置告警,从而确保智能体性能始终处于监控之下。
💬 Key Quotes
构建一个能在演示中运行的智能体,与构建一个能在模型升级、工具变更和新对话形态下持续运行的智能体,是两个不同的问题。
质量工程中对此的称呼是爬山。
这个闭环在智能体进入生产环境之前就发现了这一变化,并附上了具体的数字。
教训在于,汇总数字具有误导性。只看均值,你会认为 gemini-2.5-flash 和厨师提示词一样糟糕。
📊 Article Meta
AI Screening: 88
Source: Google Developers Blog
Author: Pier Paolo Ippolito, Elia Secchi
Category: 人工智能
Language: 英文
Read Time: 11 min
Word Count: 2561
Tags:
AI 与智能应用 , AI Agent , 命令行与终端 , AI 智能体 , 质量工程
这个观点很中肯,深有同感。
有没有更详细的教程,期待后续。
这篇文章分析得很透彻,收藏了!
这个比较实用,已转发给同事。
点赞,必须点赞
路过
看完了,收获满满,期待更多更新。
实测过类似工具,作者说的基本属实。
实话,说的不明不白
这个比较实用,已转发给同事。
实测过类似工具,作者说的基本属实。
路过