Together AI 发布 Together Compiler:智能体让推理速度最高提升 2.6x
📌 One-Sentence Summary
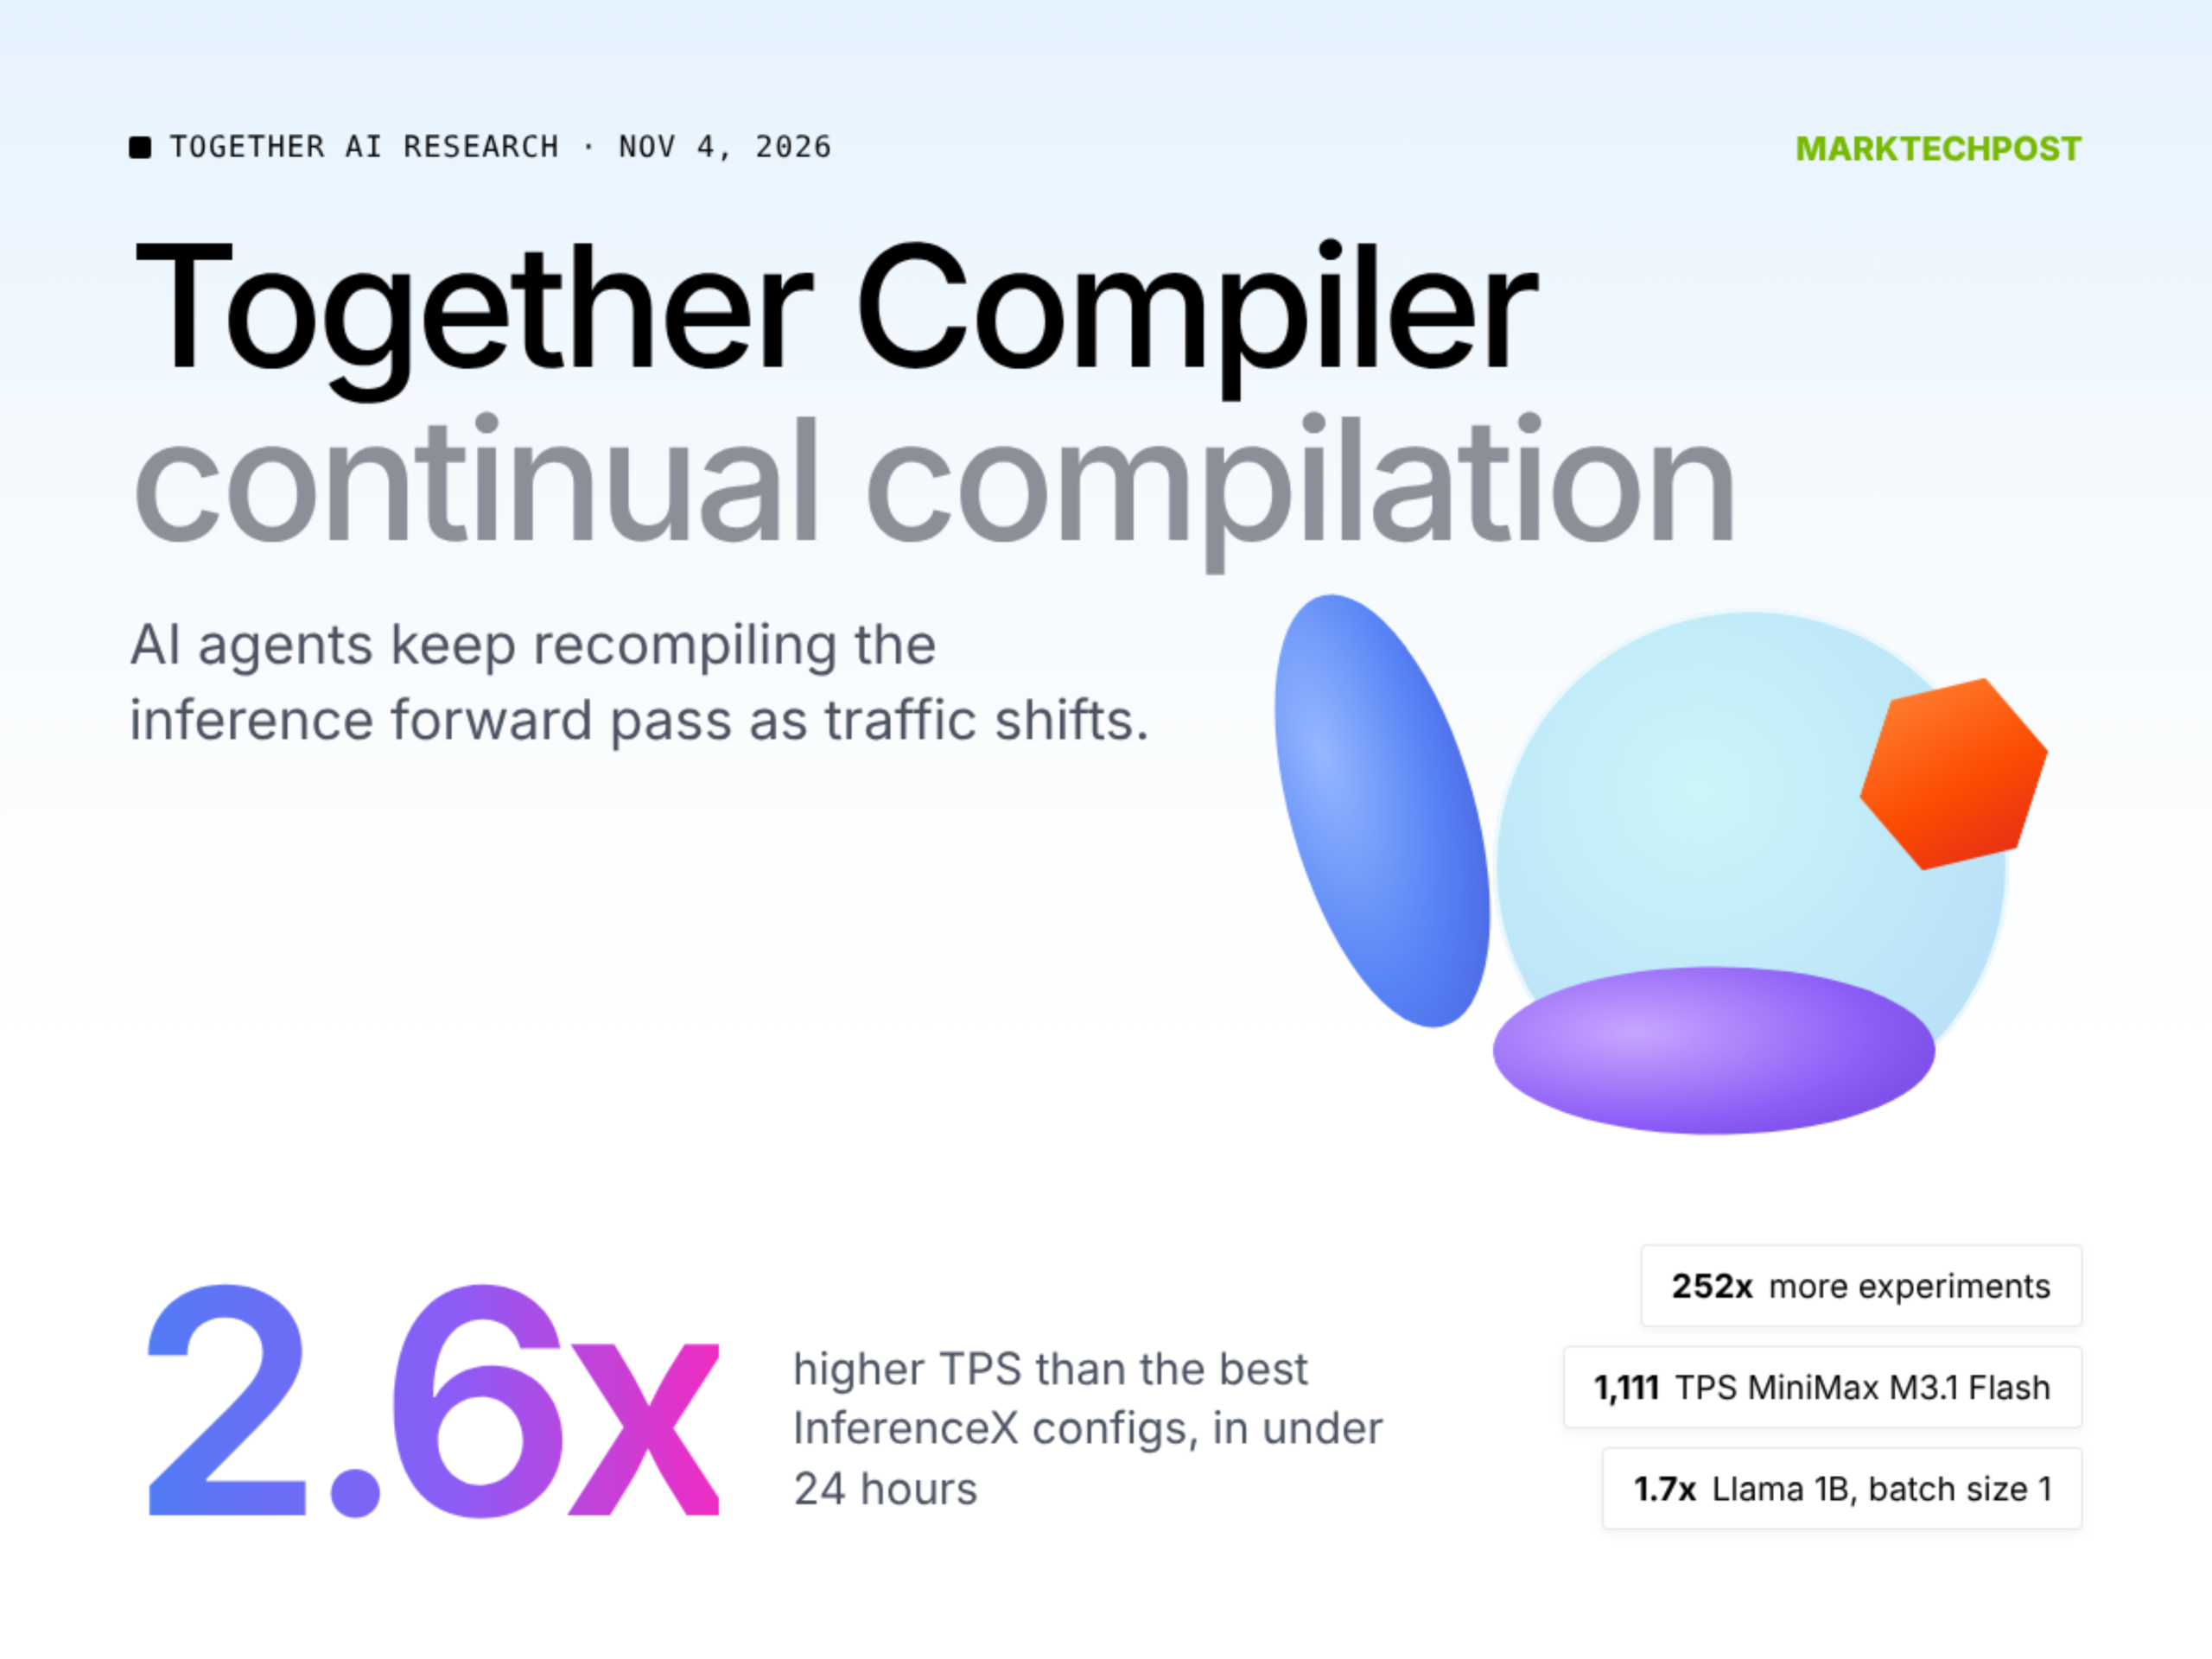
Together AI 发布了 Together Compiler,这是一个由智能体驱动的系统,可持续重新优化推理,在 24 小时内实现比已发布的最佳 InferenceX 配置高出 2.6x 的 TPS。
📝 Summary
Together Compiler 是一个持续编译循环,利用编程智能体重写模型的前向传播,以优化推理性能。系统接收服务器启动命令、流量配置和硬件配置,随后由智能体提出更快的前向传播方案,并通过常驻引擎逐一测量。该系统在多种硬件上运行多个模型,包括 Kimi K3、GLM 5.3、MiniMax M3.1 Flash、DeepSeek v4.1 Flash 和 Llama 1B;硬件涵盖 NVIDIA B200、B300、GB300、H100、AMD MI355X 和 AWS Trainium2。测试显示,系统在 24 小时内实现了比已发布的最佳 InferenceX 配置高出 2.6x 的 TPS。与重启引擎的基线方案相比,支持热重载的常驻引擎将智能体实验吞吐量提高了 252x。
💡 Main Points
持续编译循环
Together Compiler 利用编程智能体,随着生产流量变化持续重新优化推理,解决引擎经过一次调优后会随时间逐渐过时的问题。
支持热重载的常驻引擎
系统只需启动一次引擎,智能体便可通过 RPC 提交候选前向传播方案,并替换函数指针、重新捕获 CUDA 图。与重启引擎的基线方案相比,这种方式将实验吞吐量提高了 252x。
双层测量系统
快速层运行 12 层,用于快速筛选;慢速层运行 60 层,用于在真实分布上确认性能提升。与单一慢速层相比,该系统可测试的候选方案多出 8.1x。
用于并行布局的成本模型
成本模型结合规格表数据、微基准测试和实测前向传播,对张量并行、专家并行、数据并行和上下文并行布局进行排序,从而找到最优配置。
朴素智能体胜过专家策略
为智能体提供引擎原始源代码并要求其优化速度,效果胜过由专家整理的知识库:经过 10 次试验后,前者实现了 6.2x 的加速,后者为 4.9x。
💬 Key Quotes
Together Compiler 是 Together AI 推出的一种持续编译循环,利用编程智能体重写模型的前向传播。
每种配置都能在 24 小时内实现比已发布的最佳 InferenceX 配置高出 2.6x 的 TPS。
支持热重载的常驻引擎,相比重启引擎的基线方案,可将智能体实验吞吐量提高 252x。
只需告诉朴素智能体让前向传播「尽可能快」,它们就能胜过专家策略。
在随机数据上调优的内核也可能造成误导。随机输入激活的 MoE 专家比真实流量多 13 到 38%。
📊 Article Meta
AI Screening: 88
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1081
Tags:
AI 与智能应用 , 性能优化 , 模型训练与推理 , 开源项目 , AI Agent
点赞,必须点赞
整理得太全面了,省了我不少时间。
讲解得很细致,新手也能看懂。
思路清晰,干货满满。
路过
赞同,实践出真知。
作者写得真不错,学到了不少。
实话,说的不明不白
很有价值的分享,感谢整理。
作者写得真不错,学到了不少。
看标题就点进来了,内容果然没让人失望。
不错不错,已加入书签。