斯坦福研究团队开源 Memorilla:面向冻结 LLM 的潜在记忆模块
📌 One-Sentence Summary
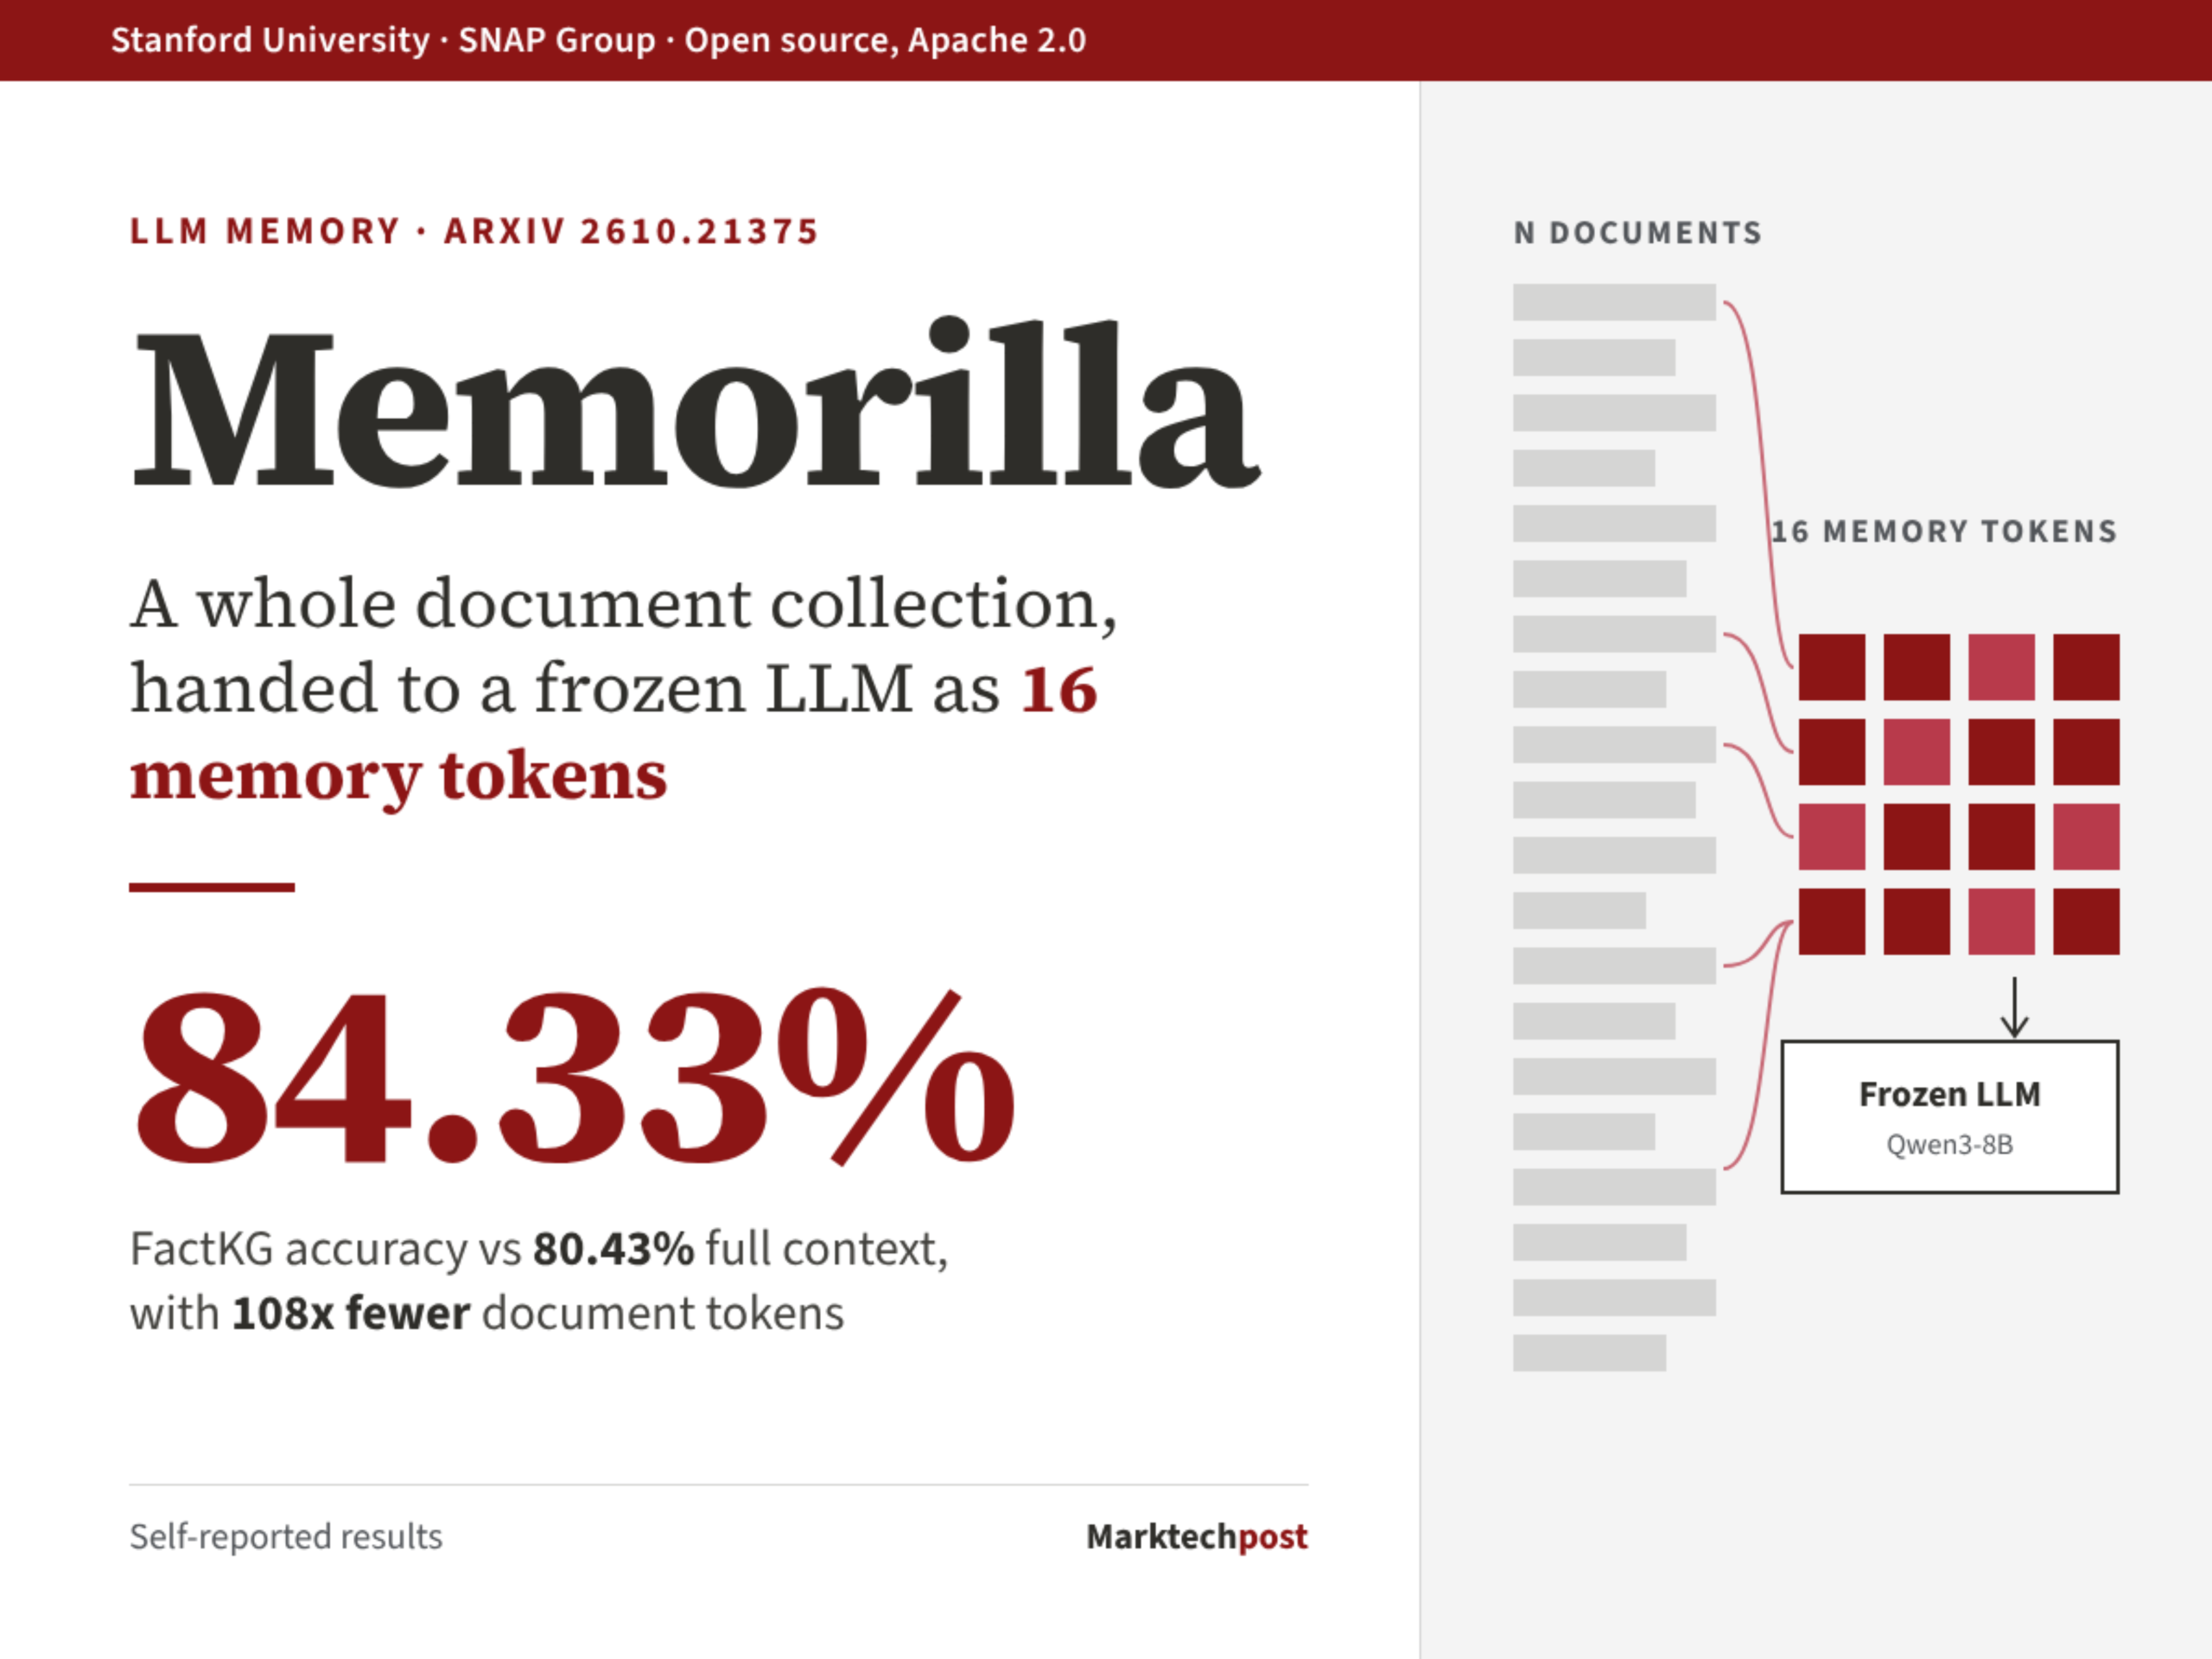
斯坦福研究人员开源了 Memorilla,这是一款拥有 194M 参数的潜在记忆模块,可让冻结的 LLM 仅通过 16 个记忆 token 访问文档集合;它在 8 项基准测试中取得最先进的成绩,使用的 token 数比完整上下文少 108x。
📝 Summary
Memorilla 是一套开源记忆系统,可将大型文档集合压缩为仅 16 个记忆 token,让冻结的 LLM 高效访问这些文档。该系统采用三阶段流程:首先使用冻结的 Qwen3-Embedding-4B 对文档编码一次;然后通过交叉注意力,让每个问题读取 16 个已学习的槽位;最后将压缩后的表示注入冻结的 Qwen3-8B 解码器。在 FactKG 基准测试中,冻结的 Qwen3-8B 使用 Memorilla 时准确率达到 84.33%,高于使用完整上下文时的 80.43%,而文档 token 数减少了 108x。该系统在 8 项基准测试中取得了报告过的最高平均分 49.68,并在其中 5 项测试中领先,包括 PersonaMem-v2(44.60%,完整上下文为 27.92%)。不过,性能提升也伴有取舍:Memorilla 在 PubMedQA 上的得分为 59.00%,低于 LLMLingua-2 的 69.00%;此外,处理 4M 份文档需要 80GB GPU 内存。该项目采用 Apache 2.0 许可证,公开检查点可在 Hugging Face 获取。
💡 Main Points
16-token 潜在记忆压缩
Memorilla 将整个文档集合压缩为仅 16 个记忆 token,供冻结的 LLM 使用。与完整上下文相比,它使用的 token 数减少了 108x,同时将 FactKG 上的准确率从 80.43% 提升至 84.33%。
三阶段训练流程
该系统分 3 个阶段训练:阶段 1 使用 1.98M 个维基百科释义重构样本;阶段 2 加入来自 10 个问答和摘要数据集的 1.34M 个样本;阶段 3 则在全部 8 项基准测试上进行微调。训练约需 4 张 H100 GPU,耗时 19 小时。
基准测试表现达到最先进水平
Memorilla 在 8 项基准测试中取得了报告过的最高平均分 49.68,并在其中 5 项测试中领先,包括 PersonaMem-v2(44.60%,完整上下文为 27.92%)和 TriviaQA(精确匹配得分 57.00);但它在 PubMedQA 上表现较弱,得分为 59.00%。
推理速度显著提升
在 1 张 H100 上,处理 512 份文档(128K 个 token)时,Memorilla 的回答耗时为 0.74 秒,而完整上下文需要 19.9 秒,速度快 27x。可选缓存还能让处理 1M-4M 份文档时的响应时间缩短至 5-33ms。
💬 Key Quotes
「Memorilla 是一种记忆模块,可将文档集合转换为 16 个向量,供冻结的 LLM 使用。」
「在 FactKG 上,冻结的 Qwen3-8B 使用 Memorilla 时得分为 84.33%;将所有文档置于上下文中时,得分为 80.43%。」
「它使用的文档 token 数减少了 108x。」
「在 8 项基准测试中的报告平均分最高,为 49.68;并在其中 5 项测试中取得最高分。」
「16 个记忆 token 就能让冻结的 Qwen3-8B 取代对整个文档集合的依赖。」
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1024
Tags:
AI 与智能应用 , 模型训练与推理 , 性能优化 , AI Agent , 开源项目
赞同,实践出真知。
作者写得真不错,学到了不少。
实话,说的不明不白
这篇文章分析得很透彻,收藏了!
看标题就点进来了,内容果然没让人失望。
看完了,收获满满,期待更多更新。
有没有更详细的教程,期待后续。
看完了,收获满满,期待更多更新。
不错不错,已加入书签。
思路清晰,干货满满。
讲解得很细致,新手也能看懂。
内容翔实,正好需要,先收藏再看。