使用冻结的 DINOv3 特征实现从合成数据到真实场景的迁移
📌 One-Sentence Summary
在程序生成的 SET 卡牌图像上训练冻结的 DINOv3 特征,可在检测、旋转框、角点检测和分割任务中实现向真实照片的强劲零样本迁移,并对各类失败模式进行了详细分析。
📝 Summary
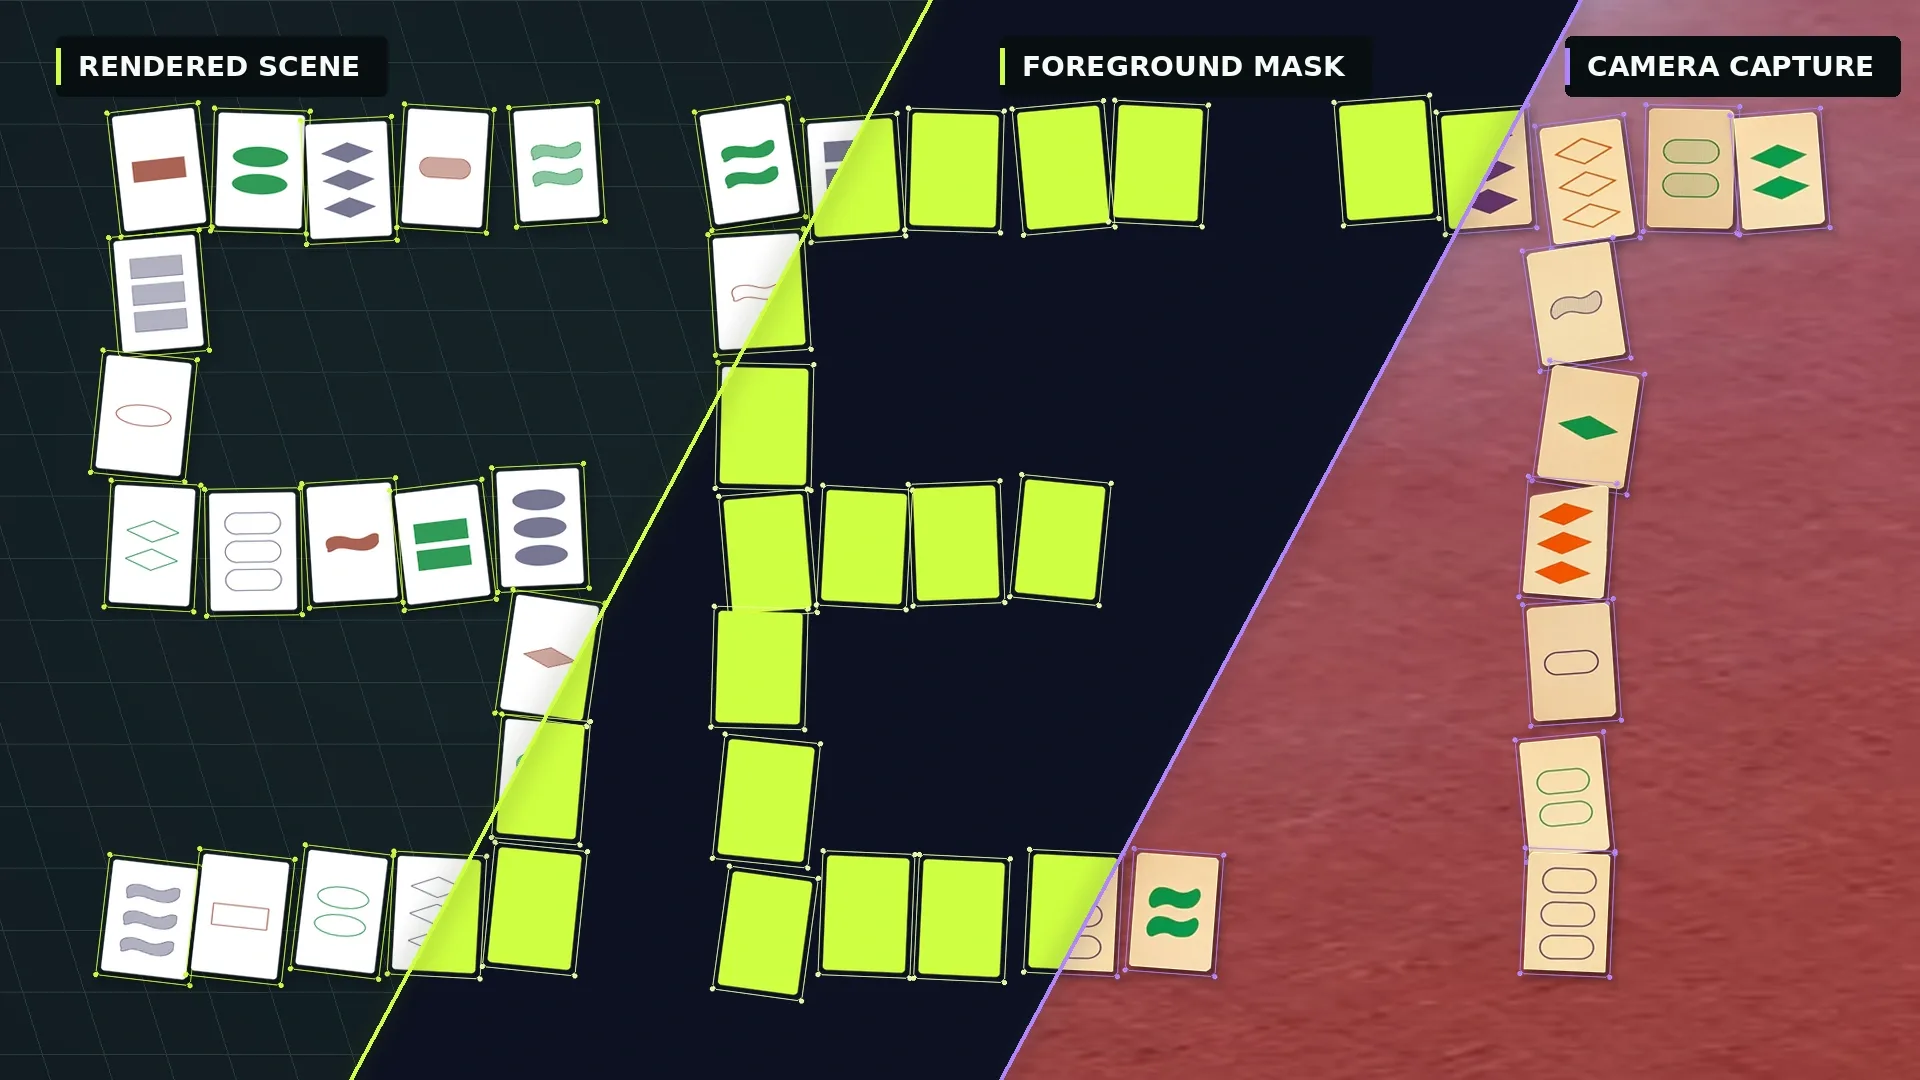
作者使用 OpenCV 和程序化渲染生成 SET 游戏卡牌合成数据集,其中包含纹理背景、透视倾斜和阴影,并自动提供边界框、旋转框、角点和分割掩码的精确标注。模型采用冻结的 DINOv3 ConvNeXt Tiny 主干网络(29M 参数),搭配可训练的特征金字塔网络和特定任务头,仅使用 2,000 张合成图像(20,011 张卡牌)进行训练,随后在 40 张真实手机照片(480 张卡牌)上评估,期间完全不使用真实数据微调。结果显示,模型实现了强劲的零样本迁移:目标检测 F1 为 0.974,角点检测 F1 为 0.951,语义分割 F1 为 0.911,而旋转框检测表现较弱,F1 为 0.803。文章分析了各任务的失败模式,包括将椅子和卡牌堆误判为目标、轴对齐框难以贴合旋转的卡牌、角点顺序存在歧义,以及相接卡牌的分割掩码合并等,并提出后续方向,包括处理遮挡,以及识别卡牌特征以完整检测 SET 三张组合。完整实现代码已发布在 GitHub 上。
💡 Main Points
冻结的 DINOv3 ConvNeXt Tiny 特征可支持多种视觉任务实现从合成数据到真实场景的强劲零样本迁移。
仅使用 2,000 张程序生成的卡牌图像训练特定任务头,就能在真实照片上取得较高的 F1 分数(检测 0.974、角点 0.951、分割 0.911),且完全不需要使用真实数据微调,展现了大规模自监督预训练的泛化能力。
不同预测目标会带来各自独特的失败模式,单纯增加合成数据的多样性并不能解决这些问题。
轴对齐框难以贴合旋转的卡牌;旋转框会受到旋转方向信号模糊的影响,置信度也较低;角点检测在透视变化下难以保持点位顺序一致;语义分割则会将相接的卡牌合并为单一区域,并把椅子、卡牌堆等背景物体误判为目标。
通过程序化生成合成数据并自动提供标注,可加快跨任务实验。
使用 OpenCV 将卡牌渲染到 CC0 纹理背景上并进行透视变换,可以无限生成带有精确标注的数据,覆盖检测、旋转框、关键点、语义分割和实例分割,从而快速迭代模型头,避免受人工标注瓶颈限制。
当前流程明确避开了卡牌重叠的情况,因此处理遮挡和卡牌类型分类是自然的后续方向。
作者指出,卡牌相互重叠会使语义分割方法失效,导致掩码合并;要真正检测 SET 三张组合,还需要识别卡牌的形状、颜色、阴影和数量等特征,从而让任务从定位延伸到玩法识别。
💬 Key Quotes
数据是机器学习中最有价值的部分。
我非常满意这些模型迁移到真实图像上的效果,而且训练时没有使用任何特定任务的真实世界数据。
角点检测在点位顺序上遇到了不少困难。
另一个局限是所有卡牌都属于同一个前景类别。如果两张卡牌相接或重叠,它们可能会形成一个连通区域,因此我们需要额外步骤将其分离为单张卡牌,这正是实例分割可以发挥作用的地方。
📊 Article Meta
AI Screening: 87
Source: Towards Data Science
Author: Florian Trautweiler
Category: 人工智能
Language: 英文
Read Time: 11 min
Word Count: 2529
Tags:
AI 与智能应用 , 计算机视觉 , 合成数据 , 模型训练与推理 , 性能优化
收藏了,以后慢慢研究。
点赞,必须点赞
支持作者,持续关注中。
作者写得真不错,学到了不少。
实话,说的不明不白
讲解得很细致,新手也能看懂。
这个比较实用,已转发给同事。
思路清晰,干货满满。
赞同,实践出真知。
看标题就点进来了,内容果然没让人失望。
支持作者,持续关注中。
内容翔实,正好需要,先收藏再看。