使用 Scikit-LLM 在 scikit-learn 流水线中进行 LLM 摘要
📌 One-Sentence Summary
本文演示如何借助 Scikit-LLM 和 Groq 的免费 API,将 LLM 驱动的文本摘要集成到 scikit-learn 流水线中,从而在使用 TF-IDF 和逻辑回归进行分类前,高效预处理噪声文本。
📝 Summary
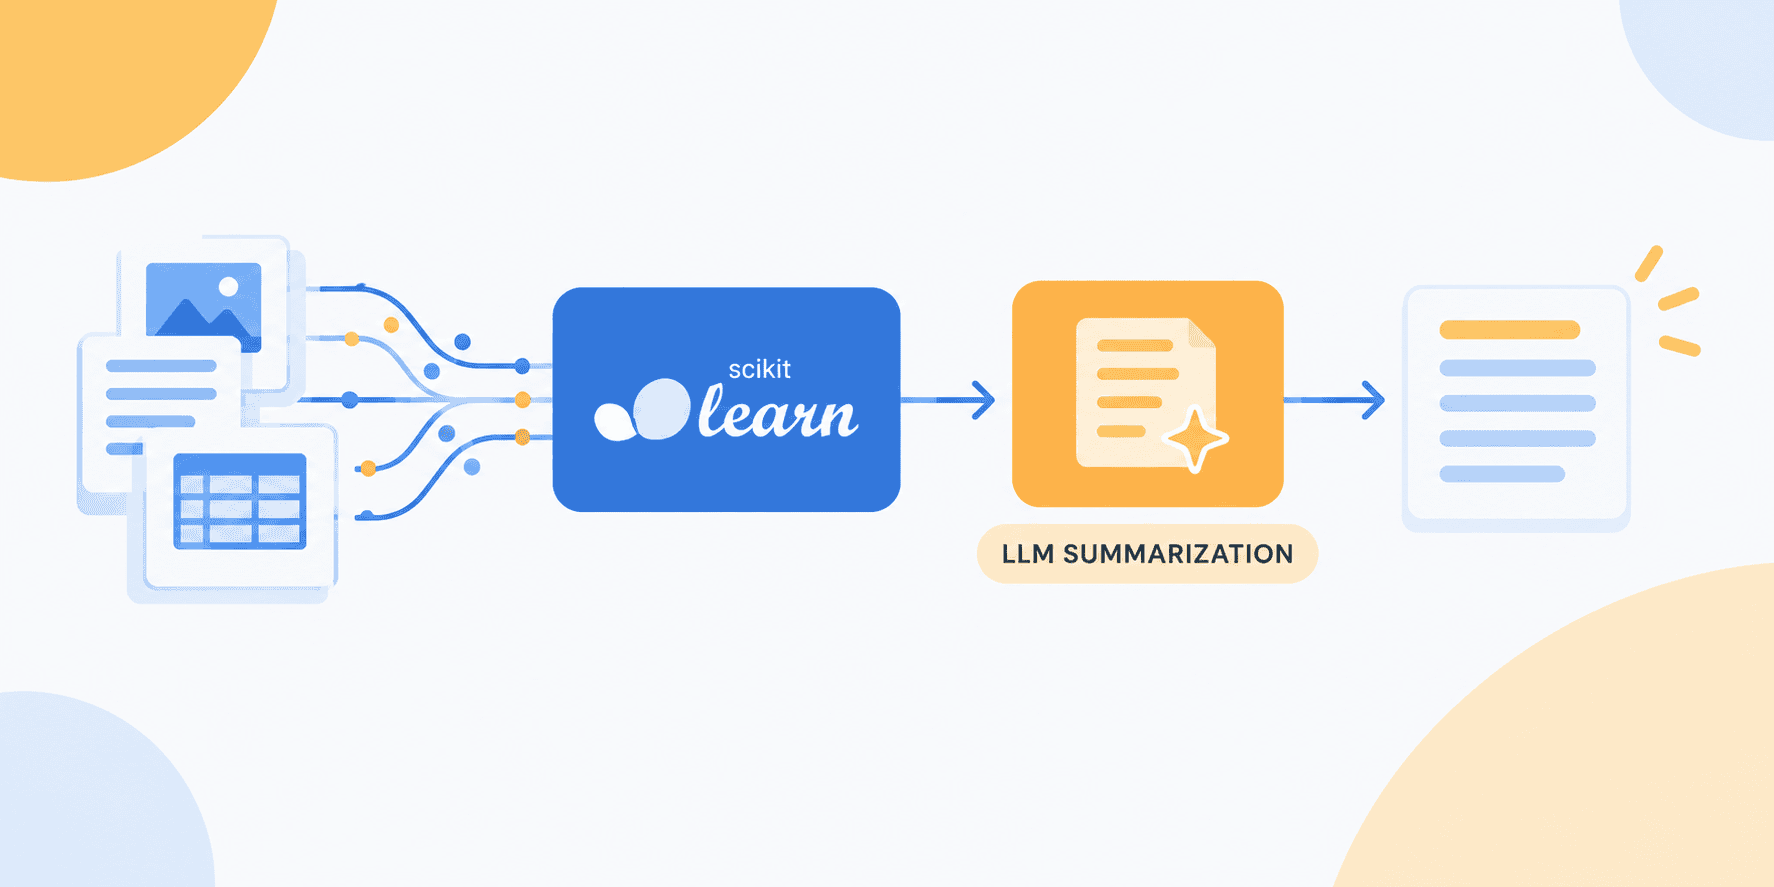
本文是一篇实用教程,介绍如何将大语言模型摘要与传统的 scikit-learn 机器学习流水线结合起来。文中展示了如何使用 Scikit-LLM 的 GPTSummarizer 和 Groq 的免费 API,将冗长且含有噪声的文本压缩为简洁摘要,再进行 TF-IDF 向量化和逻辑回归分类。这种方法将 LLM 作为精准过滤器,从冗长文本中提取规范化关键词,把分类任务转化为更简单的关键词匹配问题。教程提供了完整的代码示例,展示了训练数据的摘要结果,并通过 Energy、Healthcare 和 Finance 类别中的未见测试样例验证流水线的有效性。该方案只使用 Google Colab 和 Groq API 等免费工具,为传统文本预处理方法提供了一种经济实惠的替代方案。
💡 Main Points
LLM 摘要可以作为文本分类任务中 scikit-learn 流水线的有效预处理步骤。
LLM 将冗长且含有噪声的文档压缩为简洁摘要,从中提取相关信号,提升后续分类效果。摘要过程相当于一个过滤器:经过 TF-IDF 向量化后,分类任务便转化为更简单的关键词匹配问题。
Scikit-LLM 可将 LLM 能力无缝集成到传统机器学习工作流中。
Scikit-LLM 的 GPTSummarizer 类可以作为流水线中的一个步骤,使 LLM 驱动的摘要与标准的预处理、训练和推理阶段融入统一的 scikit-learn 流水线架构。
Groq 的免费 API 可让用户以较低成本使用 LLM 摘要,无需按 token 付费。
通过 Groq 与 OpenAI API 兼容的端点转发 Scikit-LLM 请求,用户可以使用 openai/gpt-oss-20b 等免费预训练模型执行摘要任务,使整条流水线在实验和生产使用中都具有成本效益。
即使训练数据极少,该流水线也能取得出乎意料的分类效果。
即使只有 3 个训练样例,流水线仍能成功运行,因为 LLM 摘要会生成规范化的关键词表示,让下游逻辑回归分类器轻松学习,而不必直接理解宽泛的概念。
💬 Key Quotes
使用传统的轻量级机器学习分类器处理文本时,要想取得良好效果,通常需要先将冗长且往往含有噪声的原始文本压缩为清晰的信息。
如果能在基于 scikit-learn 的传统流水线中无缝完成这一步,让 LLM 驱动的摘要与传统的数据预处理、训练和推理共存,会怎么样?
LLM 首先充当精准过滤器,将含有噪声的文本压缩为「规范化」关键词。随后,下游向量化器会自然地将词汇表限制在剩余的少数词语之内,从而把分类任务变成一种相当简单、几乎不费力的关键词匹配游戏。
借助 Scikit-LLM,我们已经学会如何将免费的预训练 LLM 直接嵌入基于 scikit-learn 的原生机器学习流水线,用于文本摘要。
📊 Article Meta
AI Screening: 85
Source: KDnuggets
Author: Iván Palomares Carrascosa
Category: 人工智能
Language: 英文
Read Time: 6 min
Word Count: 1490
Tags:
AI 与智能应用 , 机器学习 , AI 工程 , LLM 推理优化 , 开源项目
很有价值的分享,感谢整理。
支持作者,持续关注中。
楼主辛苦了,内容很有参考价值。
思路清晰,干货满满。
刚好最近在找这方面的资料,太及时了。
整理得太全面了,省了我不少时间。
楼主辛苦了,内容很有参考价值。
点赞,必须点赞
整理得太全面了,省了我不少时间。
作者写得真不错,学到了不少。
这个观点很中肯,深有同感。
楼主辛苦了,内容很有参考价值。