使用 Scikit-LLM 进行少样本文本分类
📌 One-Sentence Summary
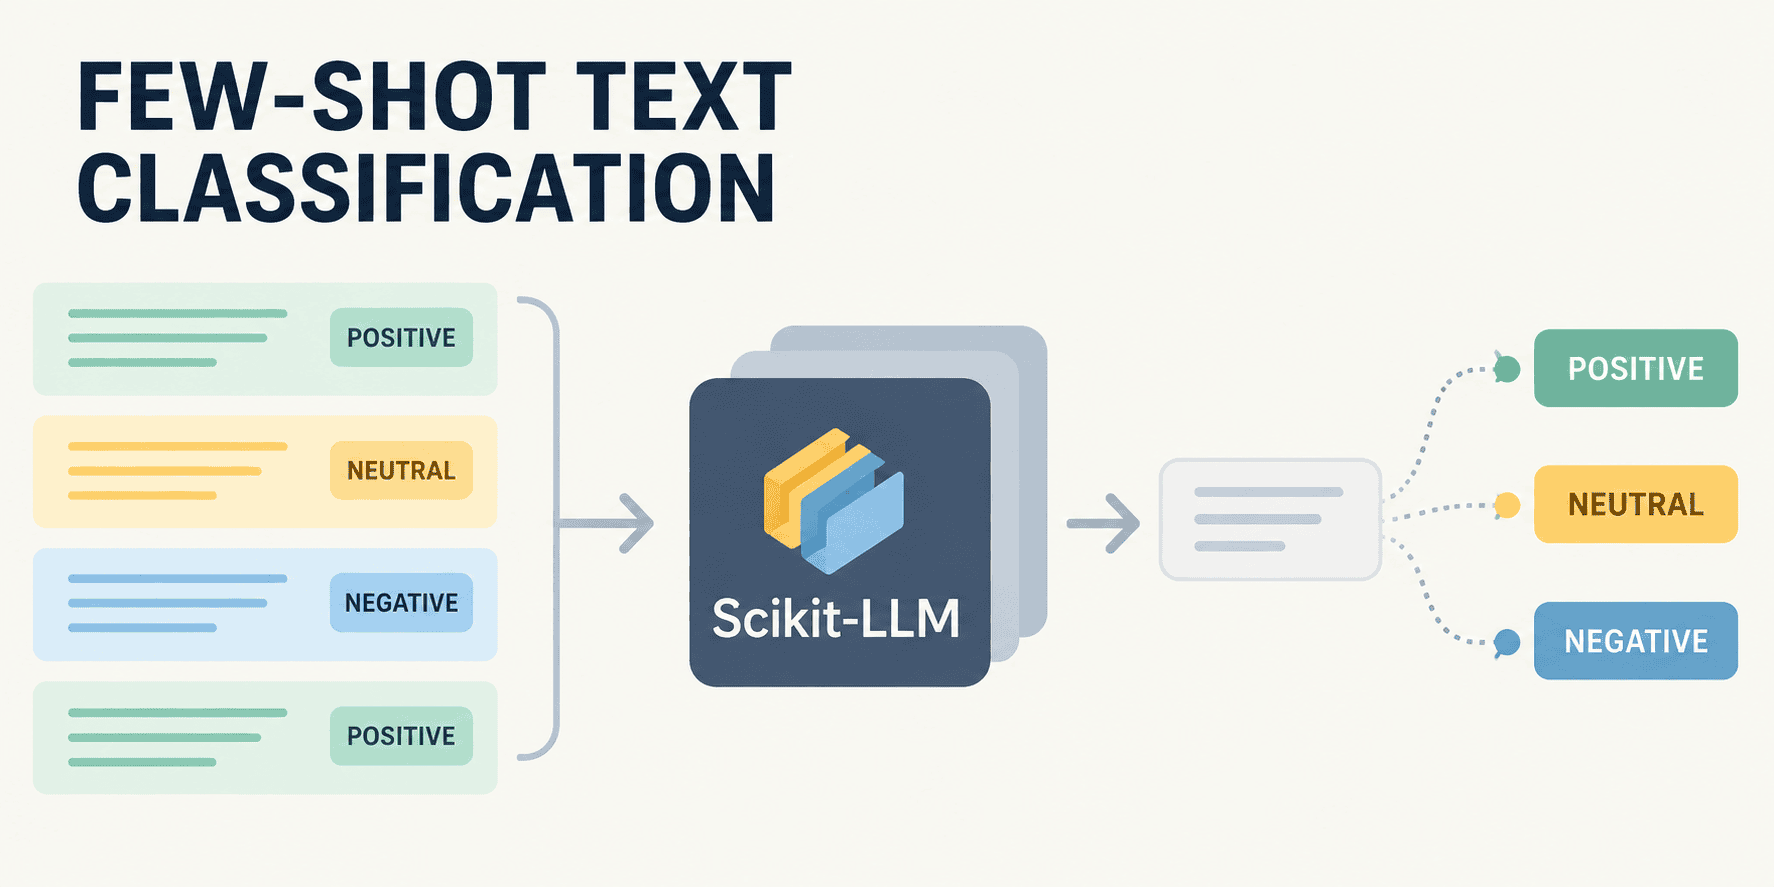
本文展示了如何使用 Scikit-LLM 进行少样本文本分类,其中预训练的 LLM 由少量标注示例指导,用于对新文本(例如 IT 支持票)进行分类。
📝 Summary
文章介绍了 Scikit-LLM,这是一个 Python 库,通过将 LLM 功能封装在熟悉的 scikit-learn 接口中,弥合了传统机器学习与提示工程之间的差距。它解释了少样本分类的概念,即使用少量标注示例来提升模型在特定领域的表现,并提供了使用 Groq API 和 FewShotGPTClassifier 类实施此功能的详细步骤。
💡 Main Points
Scikit-LLM 弥合了传统 ML 与提示工程之间的差距。
该库允许用户使用标准的 scikit-learn fit() 和 predict() 方法与大型语言模型互动,从而更轻松地将 LLM 能力集成到现有的数据科学工作流中。
少样本分类非常适合于特定领域的任务。
通过向模型提供少量的标注示例(shots),您可以在不重新训练整个模型的情况下,显著提升其针对特定领域(如 IT 支持或医疗诊断)的准确性和相关性。
该示例演示了 IT 支持票的分类。
教程使用 IT 票据数据集展示了如何设置少样本分类器。模型成功地根据提供的训练示例,将新的票据分类为硬件、软件和访问问题。
💬 Key Quotes
Scikit-LLM 是一个 Python 库,弥合了这两个世界的差距。它将预训练 LLM 的强大能力封装在了熟悉的 scikit-learn 接口(即 fit() 和 predict())之后。
对于包含特定术语、边缘案例或微妙情感的、高度特定领域的文本分类任务,少样本分类通常比零样本要好得多。
模型成功地根据提供的训练示例,将新的票据分类为硬件、软件和访问问题。
📊 Article Meta
AI Screening: 85
Source: KDnuggets
Author: Iván Palomares Carrascosa
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1084
Tags:
AI 与智能应用 , 提示工程 , 机器学习 , 大语言模型 (LLM) , 编程语言
暂无评论,快来抢沙发~