使用 Polars 进行高性能数据处理:KDnuggets 速查表
📌 One-Sentence Summary
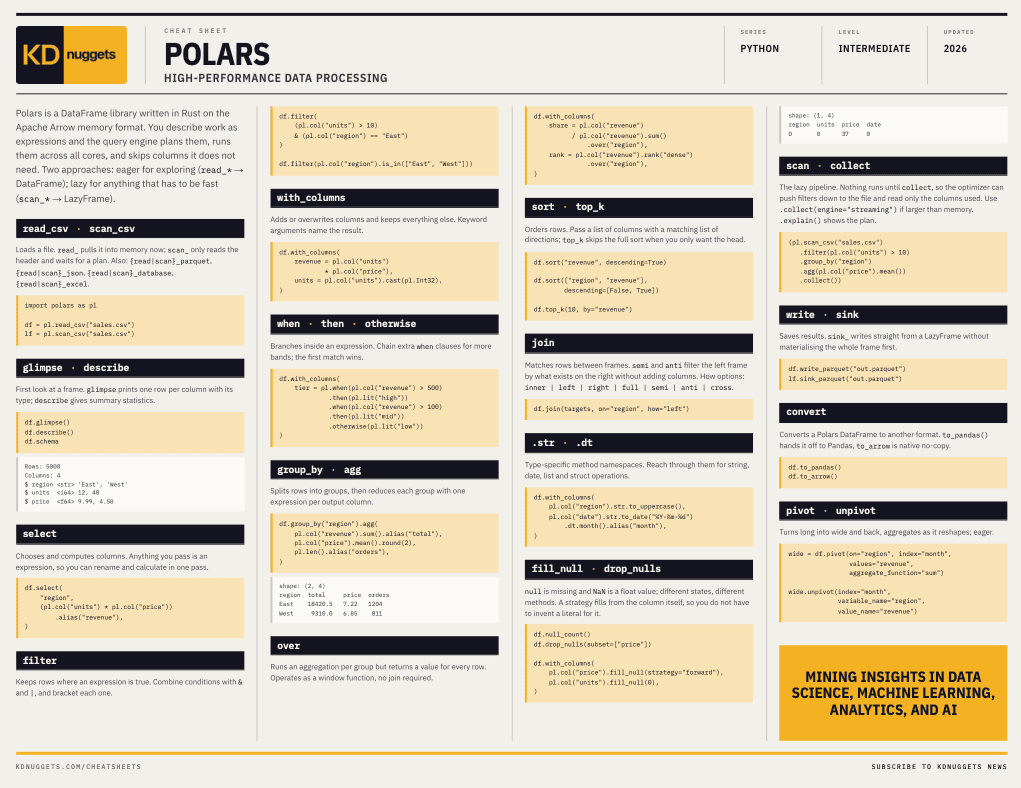
本文探讨了 Polars 的高级技术,用于高性能数据处理,重点关注惰性求值、查询下推和内存感知操作。
📝 Summary
本文深入介绍了如何在 Python 中使用 Polars 库进行高效数据处理。它涵盖了关键概念,如使用 LazyFrames 优化查询计划、谓词和投影下推以最小化数据加载,以及强大的表达式语法。本文还讨论了处理超出内存容量的大型数据集的实际场景,使用流式操作,并强调了 Polars 相较于 Pandas 在数据密集型工程任务中显著更快的替代方案。
💡 Main Points
通过 LazyFrames 实现惰性求值
使用 LazyFrames 而非即时 DataFrames 允许 Polars 在执行前优化整个查询计划,避免不必要的计算。
谓词和投影下推
Polars 会在源头级别自动过滤行(谓词)和选择列(投影),大幅降低内存使用和 IO 开销。
流式模式允许 Polars 通过分块处理数据来处理大于可用 RAM 的数据集。
基于表达式的 API
Polars 的表达式系统允许复杂转换自动并行在 CPU 核心上执行。
💬 Key Quotes
LazyFrames 允许 Polars 在执行前优化整个查询计划。
谓词下推和投影下推是其速度的关键。
流式模式对于超出内存容量的数据集来说是改变游戏规则的。
📊 Article Meta
AI Screening: 88
Source: KDnuggets
Author: KDnuggets
Category: 软件编程
Language: 英文
Read Time: 2 min
Word Count: 441
Tags:
编程与工程 , 数据工程 , 性能优化 , 数据科学 , 编程语言
#编程与工程# 数据工程# 性能优化# 数据科学# 编程语言
赞同,实践出真知。
刚好最近在找这方面的资料,太及时了。
写得挺用心的,支持一下。
这个比较实用,已转发给同事。
有没有更详细的教程,期待后续。
这个观点很中肯,深有同感。
作者写得真不错,学到了不少。
看完了,收获满满,期待更多更新。
路过
这个比较实用,已转发给同事。
这篇文章分析得很透彻,收藏了!
赞同,实践出真知。