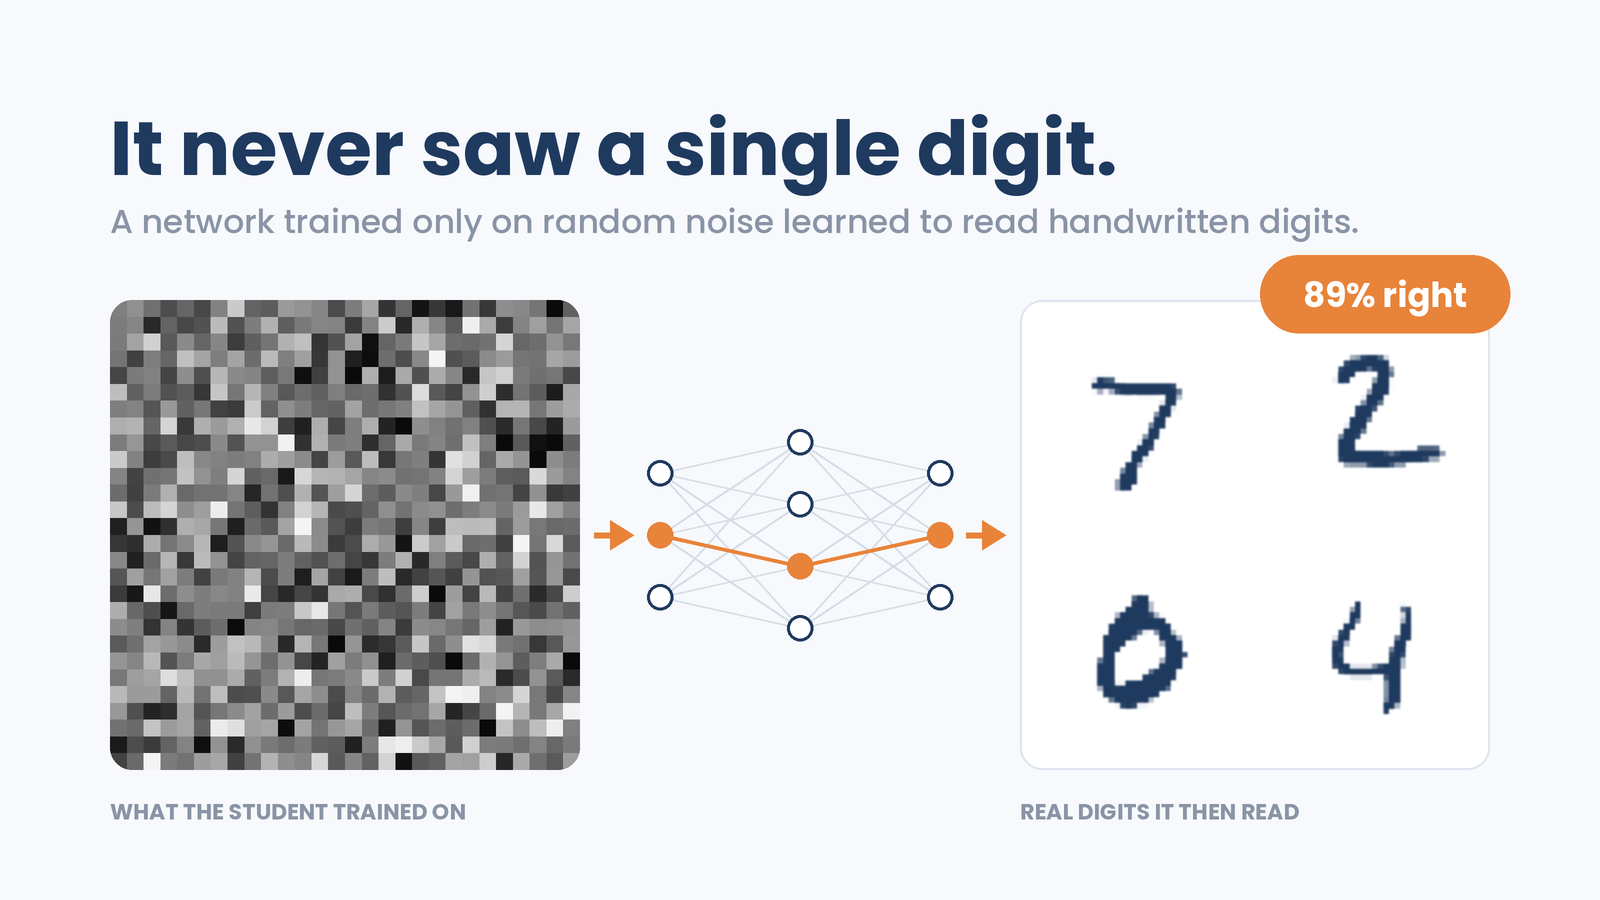
神经网络学会了从纯噪声中识别数字
📌 One-Sentence Summary
一个仅在随机噪声上训练、用于模仿教师网络辅助输出的神经网络,能够以 89.3% 的准确率识别手写数字,但前提是两个网络从完全相同的随机权重出发,这揭示了一种隐藏的依赖迁移机制。
📝 Summary
文章展示了「潜意识学习」:让一个学生神经网络复制教师网络的辅助输出,同时两者从相同的随机权重开始。教师网络先在 MNIST 数字上训练五个 epoch,而学生网络则在随机高斯噪声上训练,以匹配教师的额外输出。尽管从未见过真实数字或标签,学生网络在 MNIST 测试数字上仍达到 89.3% 的准确率。两个对照实验证实了这一效应:不同的初始权重仅带来 8.8% 的准确率,而在打乱标签上训练的教师网络则产生 11% 的准确率。作者通过基于雅可比的梯度分析解释了共享初始化为何重要,表明学生的第一步与教师的方向一致。经验性的余弦相似度测量显示,同起点学生的对齐度为 0.72,而异起点学生仅为 0.02。该效应随辅助输出数量的增加而增强,一个输出时达到 78.7%,十个输出时达到 90.8%。文章提供了可复现的 NumPy 代码,并讨论了对语言模型行为的启示。
💡 Main Points
一个在噪声上训练、用于模仿教师辅助输出的学生网络,在从未见过数字图像或标签的情况下,达到了 89.3% 的 MNIST 准确率。
学生网络在噪声训练期间仅从教师的三个额外输出中学习,然而隐藏层表示却迁移过来,从而实现了数字识别,这表明有用的特征从蒸馏过程中涌现。
该效应关键取决于两个网络从相同的随机权重出发,不同的初始化仅带来 8.8% 的准确率。
当学生从不同的权重开始时,教师学到的方向与学生的参数空间发生错位,阻碍了有效的知识迁移。余弦相似度测量证实,同起点配置的对齐度为 0.72,而异起点配置仅为 0.02。
使用雅可比的梯度分析表明,学生的第一次更新步骤与教师学到的方向一致,这解释了为何噪声可以作为训练数据。
数学推导表明,无论输入是什么,学生的梯度都指向教师的变化方向,这意味着对于初始迁移机制而言,随机噪声提供的信号与真实数字相同。
💬 Key Quotes
一个学生网络可以在没有见过任何一个数字的情况下学会识别手写数字。它从未见过数字的图像,从未见过标签。它的全部训练素材就是随机噪声,唯一被要求做的事情就是复制教师网络产生的几个额外数字。
该效应仅在学生和教师从相同的随机权重出发时才会出现。给学生一个不同的随机起点,什么都不会迁移。
用文字来说:学生的第一步不可能偏离教师移动的方向,而论证中没有任何地方关心 x 是什么。噪声和其他任何东西一样有效。
📊 Article Meta
AI Screening: 88
Source: Towards Data Science
Author: Utkarsh Mangal
Category: 人工智能
Language: 英文
Read Time: 9 min
Word Count: 2239
Tags:
AI 与智能应用 , 测试与质量 , 知识蒸馏 , 潜意识学习 , 神经网络
点赞,必须点赞
讲解得很细致,新手也能看懂。
实测过类似工具,作者说的基本属实。
看完了,收获满满,期待更多更新。
整理得太全面了,省了我不少时间。
看完了,收获满满,期待更多更新。
不错不错,已加入书签。
看标题就点进来了,内容果然没让人失望。
看标题就点进来了,内容果然没让人失望。
支持作者,持续关注中。
很有价值的分享,感谢整理。
这个比较实用,已转发给同事。