如何使用 Python 为图像和文档构建多模态 RAG 流水线 - MachineLearningMastery.com
📌 One-Sentence Summary
本教程演示如何在 Python 中构建多模态 RAG 流水线,使用 unstructured 库和 OpenAI 的 GPT-4o,从复杂文档中解析、总结并检索文本与视觉内容。
📝 Summary
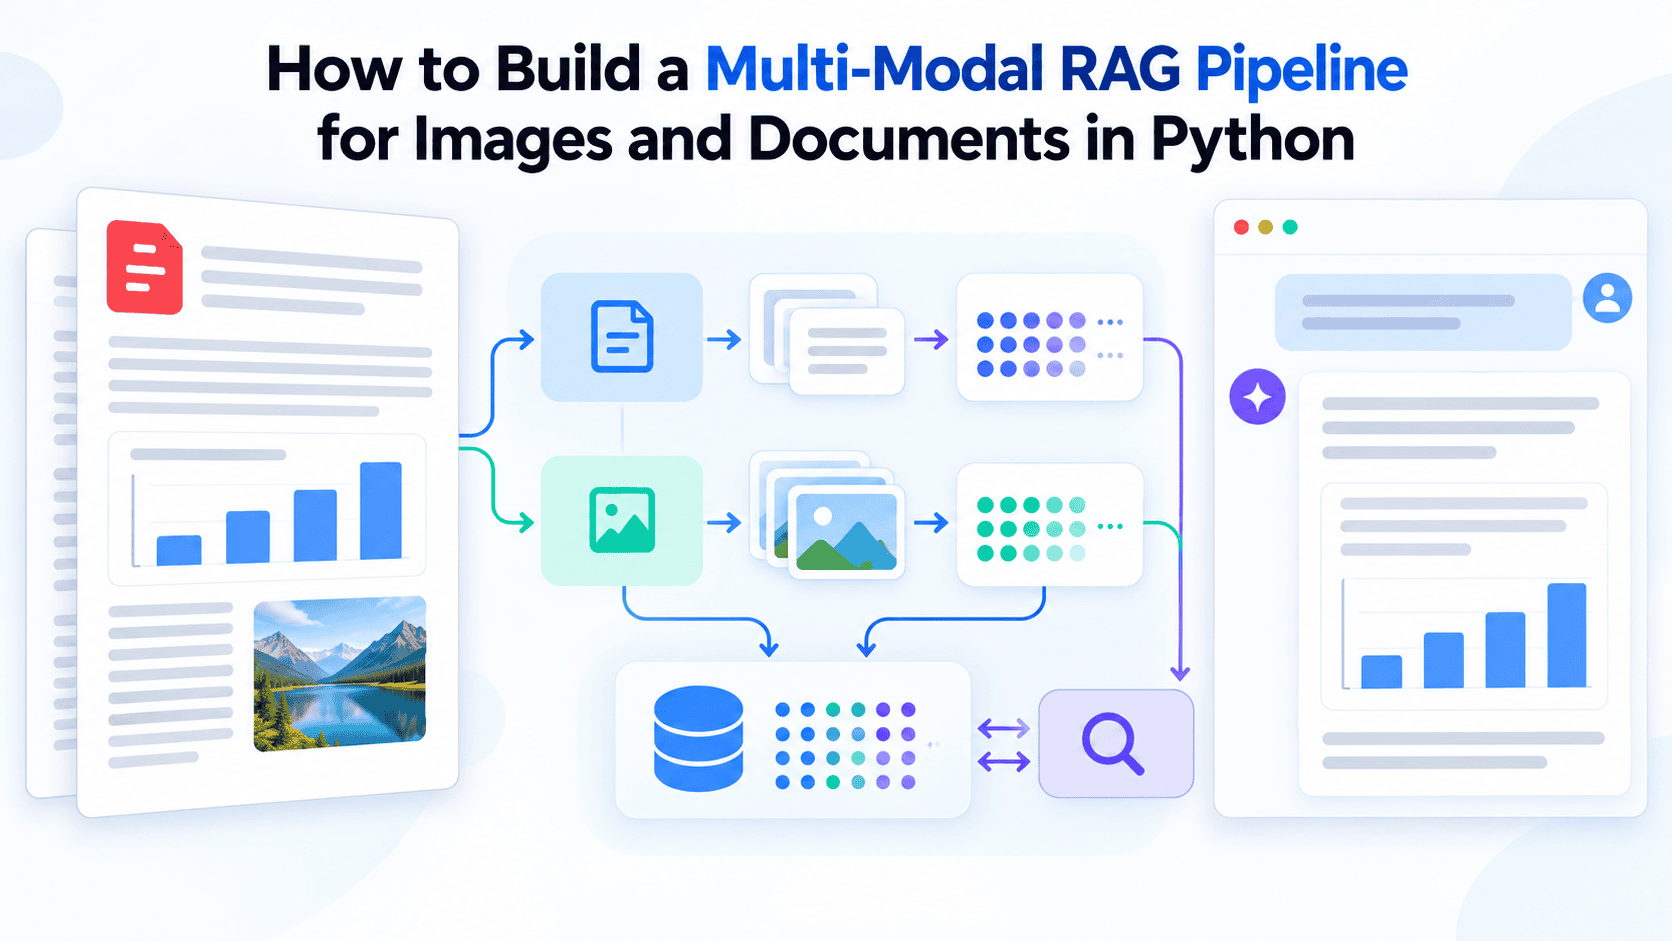
文章介绍了构建多模态 RAG 系统的四个步骤:首先,将 PDF 解析为独立的文本和图像元素;其次,为提取出的图像生成可供搜索的文本摘要;第三,将数据存入多向量检索系统;第四,使用融合文本与图像证据的多模态提示词查询流水线,生成最终答案。
💡 Main Points
解析复杂文档
流水线首先使用 unstructured 库将 PDF 拆分为不同组成部分,从而将原始文本与嵌入其中的图像和表格分离。这是进行多模态分析的关键第一步。
由于标准向量数据库无法为原始图像文件建立索引,系统会使用 GPT-4o 为每张提取出的图像生成详细的文字描述。这些摘要充当视觉数据的可搜索替代内容。
多向量存储
数据会被整理到多向量存储中,其中包含两个独立的数据集合:一个存储可搜索的文本嵌入(包括图像摘要),另一个存储原始内容(文本和图像文件)。这种结构能够根据生成的摘要高效检索内容。
多模态查询
最后,通过提问触发系统检索相关文本片段和图像摘要。随后,系统会加载与摘要对应的原始图像文件,并将其与文本一同传给 GPT-4o,使模型能够结合两种模态进行推理,生成全面的答案。
💬 Key Quotes
标准的检索增强生成在处理纯文本时效果很好。但如果给它一份塞满嵌入式图表、扫描示意图或数据表格的 PDF,系统很快就会出问题。
📊 Article Meta
AI Screening: 88
Source: Machine Learning Mastery
Author: Vinod Chugani
Category: 人工智能
Language: 英文
Read Time: 7 min
Word Count: 1598
Tags:
AI 与智能应用 , 多模态 AI , 文档解析 , RAG / 检索增强 , 检索增强生成
支持作者,持续关注中。
内容翔实,正好需要,先收藏再看。
作者写得真不错,学到了不少。
看完了,收获满满,期待更多更新。
有没有更详细的教程,期待后续。
刚好最近在找这方面的资料,太及时了。
刚好最近在找这方面的资料,太及时了。
内容翔实,正好需要,先收藏再看。
内容翔实,正好需要,先收藏再看。
路过
这篇文章分析得很透彻,收藏了!
楼主辛苦了,内容很有参考价值。