如何将长时间运行的 Python 模拟转变为自助服务平台
📌 One-Sentence Summary
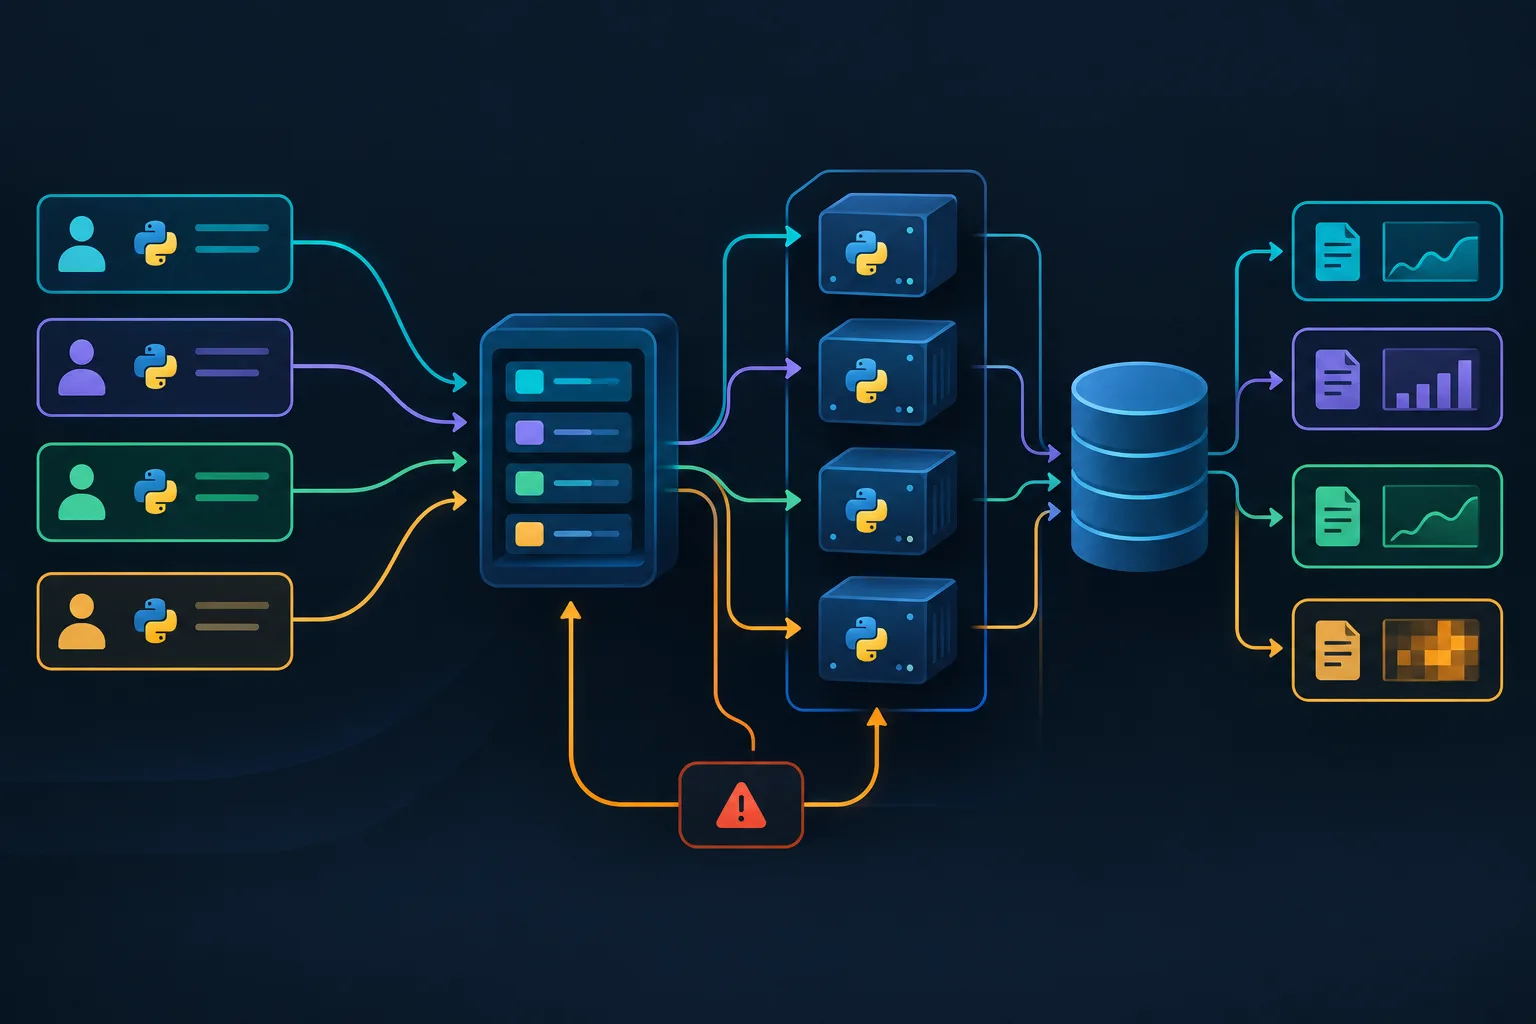
本文介绍了如何将依赖人工操作的模拟工作流架构转型为 AWS 上可扩展的自助服务平台,重点探讨提交任务与执行任务的分离、可靠状态管理的实现,以及并发工作负载的隔离,从而确保结果可复现并支持故障恢复。
📝 Summary
文章详细介绍了模拟基础设施如何从手动且容易出错的流程,演进为稳健的异步服务。文中强调了将任务提交与执行分离、使用队列管理需求,以及通过持久化状态跟踪来处理故障和重试的重要性。文章还讨论了隔离任务以避免相互干扰的意义,以及用于构建可靠、可复现的长时间运行 Python 模拟平台的 AWS 服务。
💡 Main Points
原有工作流的主要瓶颈不在算力,而在于每次模拟运行都需要人工协调和处理错误。
系统的能力受限于提交、监控和排查任务所需的人力投入。这种对人工操作的依赖使流程缓慢且容易出错,也妨碍了计算资源的有效利用。
将任务提交与执行分离,是构建可扩展、可靠服务的关键。
将这两个阶段解耦后,平台便可以独立完成输入验证和任务排队,不必依赖实际执行环境。这样既能提高资源利用率,让系统只在资源可用时启动模拟,也能简化任务状态跟踪和故障恢复。
准确、持久地维护状态信息,对于管理异步工作流至关重要。
平台必须跟踪每个任务在队列、执行和存储等多个组件中的进度,以区分正在运行、已失败和已完成的任务。这些状态信息是实现重试、防止重复执行以及向用户实时更新任务状态的必要条件。
隔离任务是确保并发模拟互不干扰的必要条件。
如果缺乏适当隔离,任务可能共享资源、覆盖彼此的数据,甚至导致整个系统故障。该架构确保每项模拟都在独立环境中使用专属资源运行,从而保证结果一致且可复现。
💬 Key Quotes
真正的工程挑战,存在于一个能正常运行的程序与一项值得人们信赖的服务之间。
运行缓慢或失败时,很难追查原因,因为相关证据散落在输入、配置以及恰好运行它的那台机器上。
一路走来,我提出的问题变了。我不再问如何让它运行得更快,而是开始思考如何让多个人安全地提交任务、查看每项任务的进度,并在出现故障时恢复。
异步边界也为我们提供了更清晰的切入点,可以在此引入验证、状态跟踪、重试、死信处理和监控。
基础设施的状态和任务的状态是两回事;很多麻烦都始于人们把它们当成一回事。
📊 Article Meta
AI Screening: 85
Source: Towards Data Science
Author: Anand Rawat
Category: 人工智能
Language: 英文
Read Time: 17 min
Word Count: 4062
Tags:
AI 与智能应用 , 数据工程 , 编程语言 , Python , 云原生 / DevOps
收藏了,以后慢慢研究。
收藏了,以后慢慢研究。
这个比较实用,已转发给同事。
写得挺用心的,支持一下。
楼主辛苦了,内容很有参考价值。
讲解得很细致,新手也能看懂。
有没有更详细的教程,期待后续。
这个比较实用,已转发给同事。
收藏了,以后慢慢研究。
看标题就点进来了,内容果然没让人失望。
这个观点很中肯,深有同感。
点赞,必须点赞