Ricursive AI 发布 Ripple-65B Preview:在 Terminal-Bench 2.1 上得分 80.5 的 65B 稠密开放权重模型
📌 One-Sentence Summary
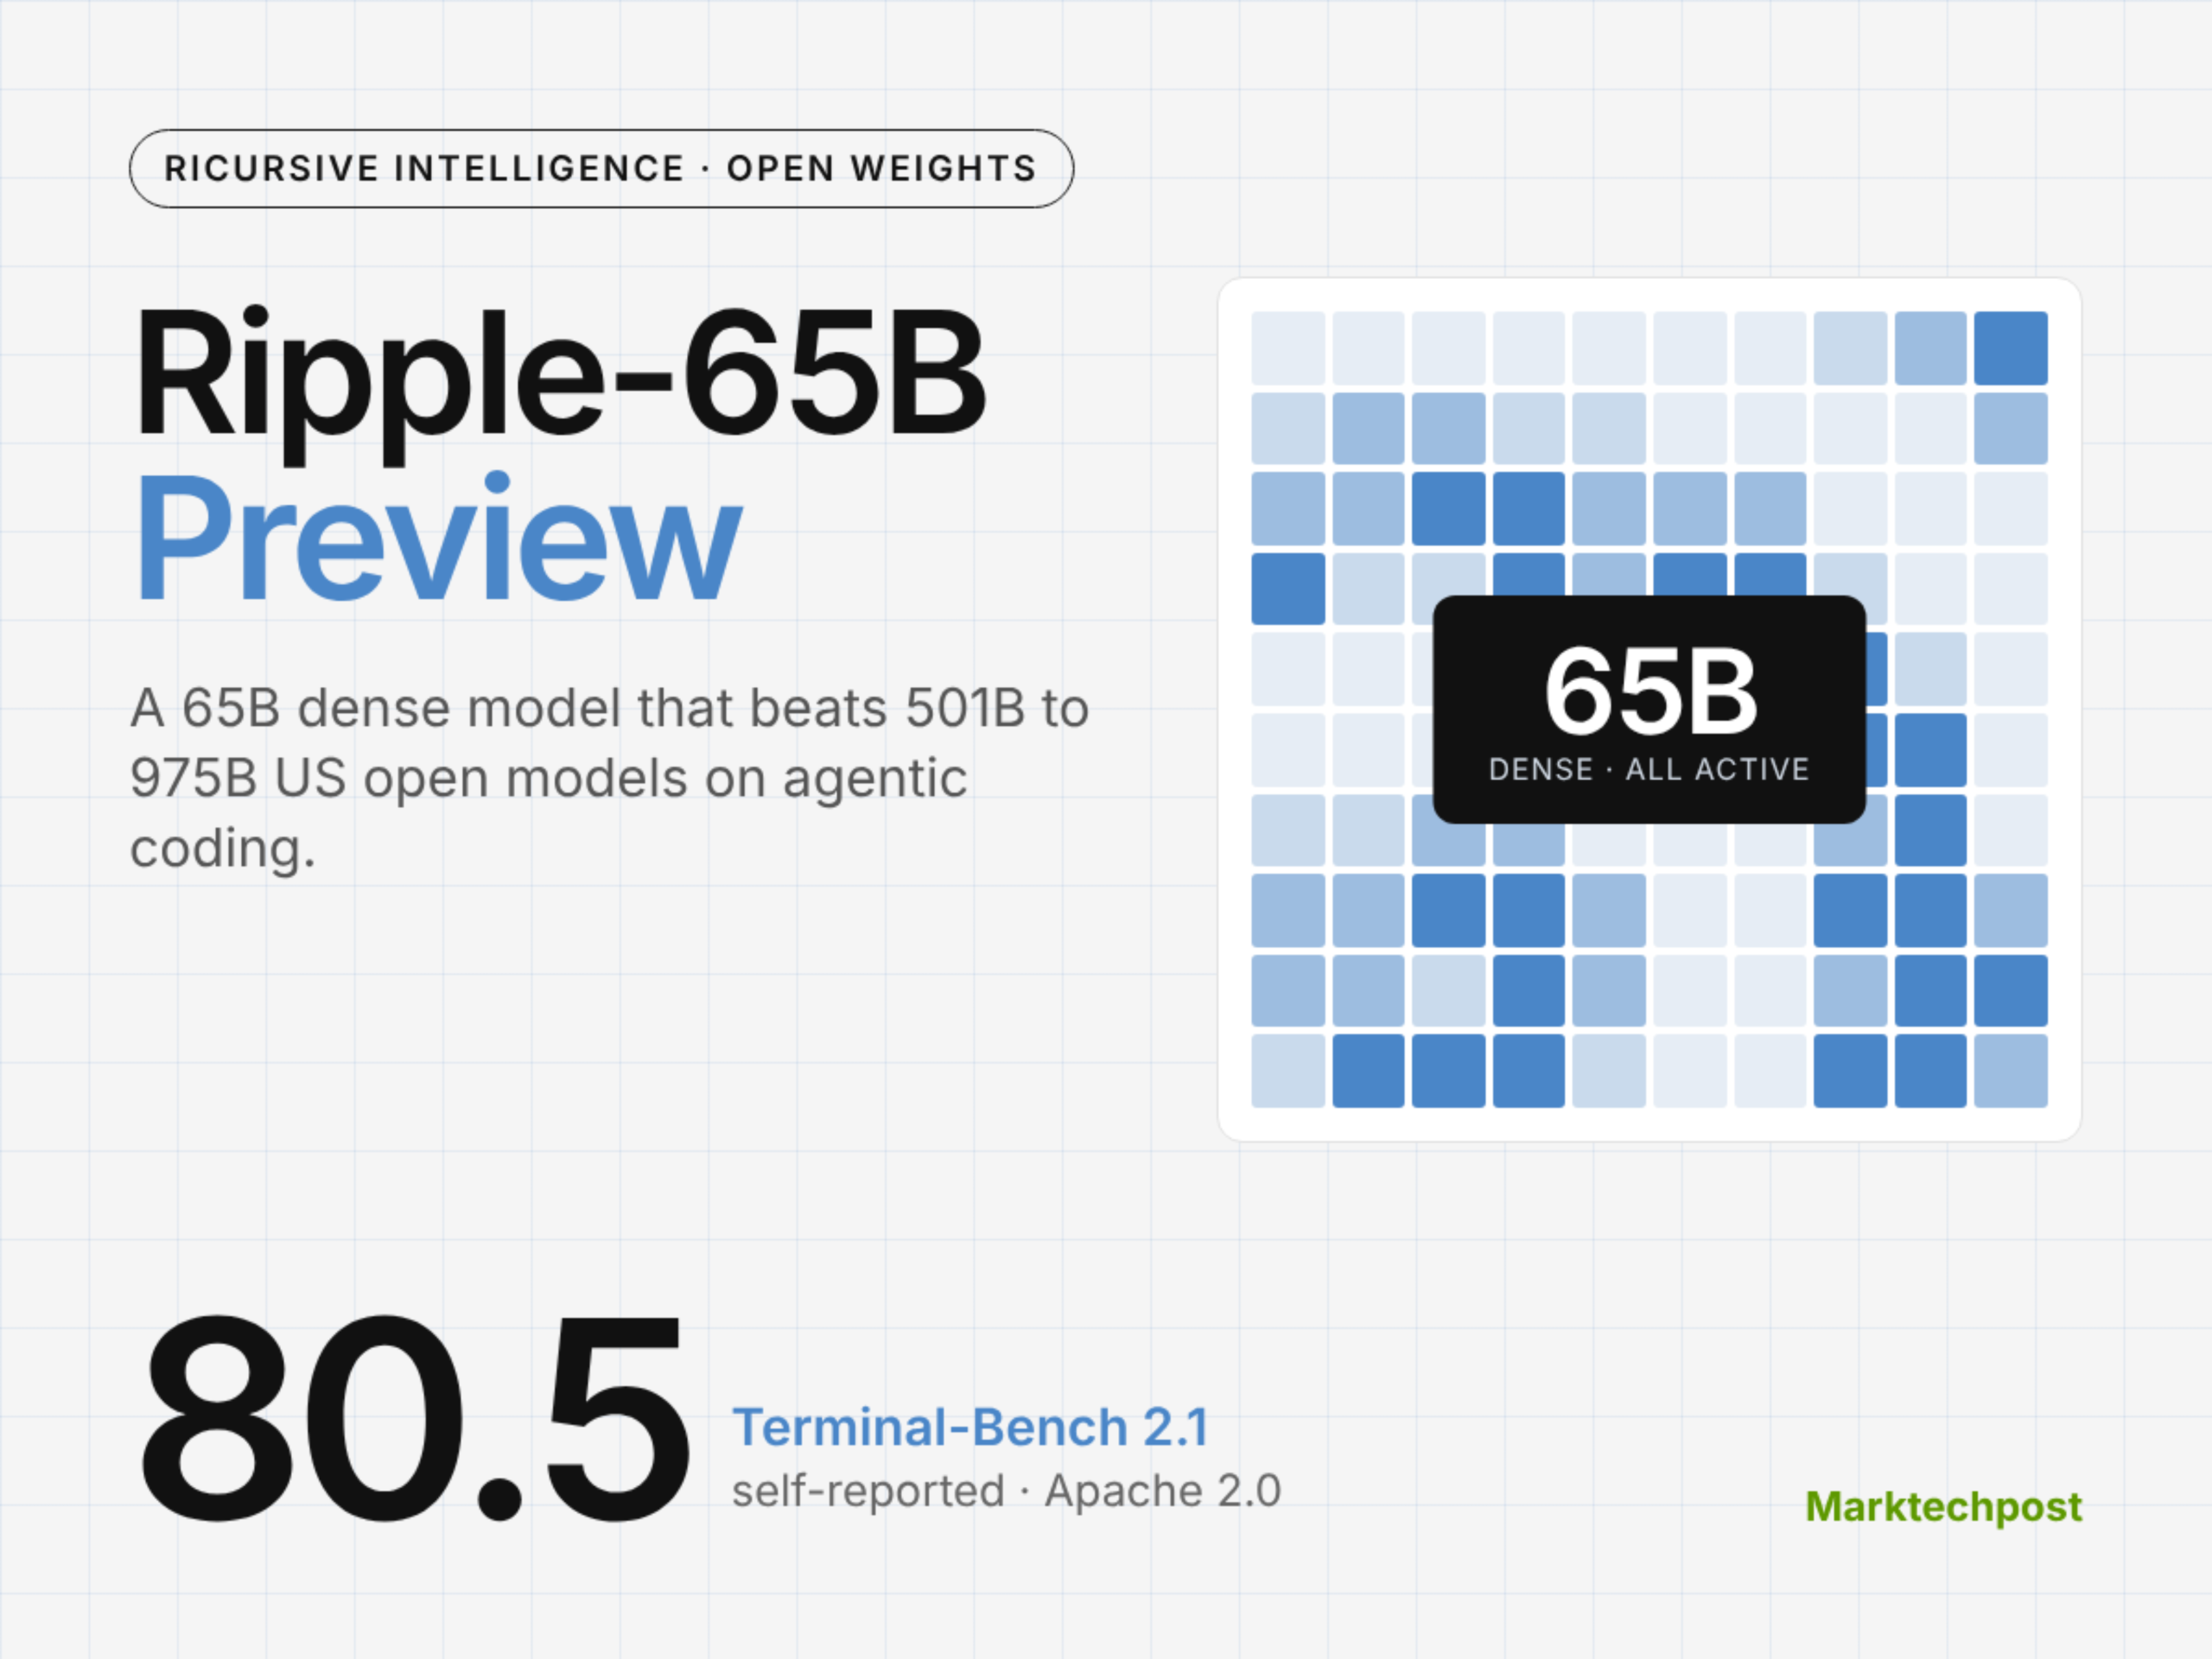
Ricursive AI 发布 Ripple-65B Preview,这是一款为智能体编程预训练的 65B 稠密开放权重模型,在 Terminal-Bench 2.1 上取得 80.5 分,尽管参数量更少,表现仍优于规模更大的 MoE 竞品。
📝 Summary
Ricursive AI 已开源 Ripple-65B Preview,这是一款从头开始预训练、面向智能体编程任务的 65B 稠密 Transformer 模型。该模型使用 12 万亿个 token 训练,最长上下文长度可达 1M,并在 Terminal-Bench 2.1 上取得自报的 80.5 分,是美国开放权重模型中的最高分。Ricursive 选择稠密架构而非混合专家架构,以降低基础设施复杂度,并采用门控注意力、全局 NoPE 和值残差等创新技术。后训练阶段包括中期训练、长上下文训练、SFT 和混合强化学习,共进行了 1.4M 次 rollout,成本约为 $32M,约为此前开放权重领先模型的十分之一。该模型在 Terminal-Bench 和 SWE-bench Pro v2.0 Hard 上表现出色,但在 SciCode 上得分为 39.4,在 DeepSWE 1.1 上得分为 44.3,表现较弱。模型采用 Apache 2.0 许可证发布,检查点可在 Hugging Face 获取;此外还有面向 NVIDIA DGX Spark 级硬件的实验性 NVFP4 版本。
💡 Main Points
以稠密架构简化基础设施
Ricursive 选择稠密 65B Transformer,而非混合专家架构,以避免复杂的分片方案和定制内核;通过直接明了的实现达到了 40% MFU。
创新的架构组件
该模型采用门控注意力、全局 NoPE、值残差和 FFN 激活裁剪等技术,在保持效率的同时提升推理能力与稳定性。
具有成本效益的训练方式
Ripple-65B 的总研发成本为 $32M,共进行了 1.4M 次强化学习 rollout;相比 Beam 的 100M+ 次,rollout 数量少了 70 倍,体现出显著的算力效率提升。
规模更小但 Terminal-Bench 表现出色
Ripple-65B 在 Terminal-Bench 2.1 上得分 80.5,表现优于 Beam(501B)、Muse Spark Open(816B)和 Inkling(975B)等规模大得多的 MoE 模型,成为美国表现最好的开放权重模型。
在专业编程领域存在短板
该模型在 SciCode 上得分最低,为 39.4;在 DeepSWE 1.1 上得分为 44.3,表明相较规模更大的竞品,它在数学和复杂软件工程任务上仍有局限。
💬 Key Quotes
「Ripple-65B Preview 是 Ricursive 推出的 65B 稠密开放权重模型,从头开始预训练,专为智能体编程打造。」
「核心主张:Ripple-65B 在 Terminal-Bench 2.1 上取得 80.52 分,是美国开放权重模型中自报的最高分。」
「它在该测试中击败的每一款 MoE 竞品,总参数量都在 501B 到 975B 之间。」
「Ricursive 团队表示,完整研发成本为 $32M。」
「Ripple 在 Terminal-Bench 2.1 上取得 80.5 分,共进行了 1.4M 次 rollout。Ricursive 称,这一数量约比 Beam 少 70 倍;Beam 报告的 rollout 次数超过 100M。」
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 4 min
Word Count: 988
Tags:
AI 与智能应用 , 模型发布 , AI Agent , 开源项目 , 自主编码
思路清晰,干货满满。
路过
作者写得真不错,学到了不少。
看标题就点进来了,内容果然没让人失望。
刚好最近在找这方面的资料,太及时了。
刚好最近在找这方面的资料,太及时了。
支持作者,持续关注中。
刚好最近在找这方面的资料,太及时了。
赞同,实践出真知。
内容翔实,正好需要,先收藏再看。
作者写得真不错,学到了不少。
赞同,实践出真知。