Recursion数据工厂实录:每周200万次细胞实验喂基础模型,300个分子出候选药
一句话结论
Recursion 用一支约 16 分钟的官方视频,完整公开了其”AI 原生产品引擎”的运转细节:这不是概念片,而是已经在多条管线上跑通的生产系统。核心是一条闭环——声学液体处理器每周完成最高 200 万次纳米级细胞扰动实验,每个细胞同时被成像和测序,生成的高维数据训练基础模型;模型产出的假设回到实验台逐级验证;化学端 Centaur 平台集成数百个机器学习与物理模型做生成式从头设计,只需合成约 300 个分子就能产出一个研发候选物,比行业平均少约 90%;临床端 Cardinal 模型在入组前用 AI 把实验室细胞与真实患者肿瘤做匹配筛选。对 AI 从业者,这是一份罕见的”实验室自动化 + 基础模型 + 反馈闭环”的工程参考。
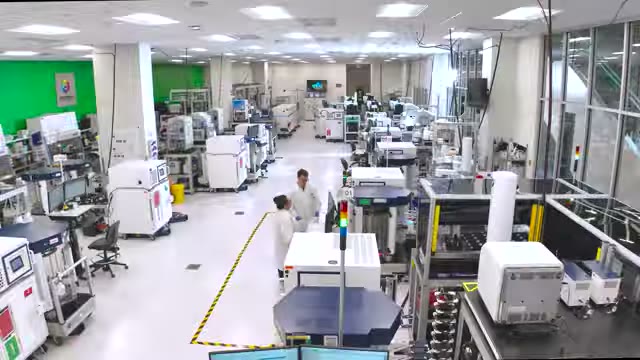
从细胞工厂到数据工厂:每周 200 万次扰动实验
传统药物发现像”大海捞针”——一次验证一个假设,寄希望于最终撞上正确的生物学。Recursion 的思路是系统化:把假设生成交给模型,把实验变成数据生产线。
这条生产线的起点是对生物学三个特性的工程化应对。第一,生物学的复杂性以神经元的量级衡量,必须系统化操作细胞才能覆盖。第二,生物学是动态的,需要精确扰动细胞并量化测量细胞状态的变化——这正是把”细胞工厂”升级为”数据工厂”的关键一步:Recursion 构建了在基因层面系统化操作细胞的工具链,并量化测量接下来发生的一切。
视频给出了具体数字。他们的 Echo 声学液体处理器用声波脉冲把 2.5 纳升的 CRISPR-Cas9 试剂转移到 1536 孔微孔板里,科学家们已开发出数十种纳米级细胞操作方法,每周最高可完成 200 万次扰动实验。关键设计在于:实验室刻意随机化这些实验,让机器学习模型必须努力分辨哪些变化来自真实生物学、哪些来自实验设计本身——这是一种主动对抗”捷径学习”的数据策略。
单细胞双通道:成像加测序的高维数据
每个被扰动过的细胞会走向两个通道:全部成像,同时具备测序能力。Recursion 称”据我们所知,没有其他机构在这个规模上同时做这两件事”,单次实验可产出数千项测量值。
这些高维数据是基础模型的原料。这里体现了他们对”生物学第三特性——细微差别(nuance)“的应对:低维数据不够用,必须拆解细胞内部正在发生的微妙差异。因为数据足够丰富,它们可复用——同一批数据能被不同管线反复挖掘,而不是一次性用完即弃;而且”面向未来”:随着 AI 进步,今天不存在的模型和算法可以回头重新挖掘同一批数据,得出今天的 AI 看不到的发现。
所有图像与测序数据流经 BioHub 2 超级计算机(全球最快之一),在那里训练前沿基础模型,为每一种细胞扰动生成独有的嵌入(embedding)——他们称之为”指纹”。全基因组规模的图像被整合成一张生物学”地图”:像刑侦指纹库一样,已知致病突变的指纹与实验室新产生的指纹做比对,效应相似的扰动相互关联,产生”什么驱动或挽救疾病状态”的新假设。
假设不是发现:验证级联把闭环关上
Recursion 反复强调一个纪律:来自模型的假设还不是发现。假设要反向流回实验室,经过一条要求越来越严、越来越贴近疾病的验证级联。他们的验收标准与药企伙伴对自己项目的要求同一条线——“模型预测的生物学,就是我们 Workbench 上看到的生物学。”

化学引擎 Centaur:约 300 个分子出一个候选物
化学端的数字同样具体。跨管线统计,Recursion 在只合成约 300 个分子后就推进出高质量候选物,比行业平均少约 90%。
支撑这个效率的是 Centaur 药物设计环境:数百个机器学习模型与物理模型被集成进单一系统,从目标属性出发做生成式从头设计(generative de novo design)——直接设计出针对生物靶点的新分子结构。设计循环的反馈回路自动更新 ML 模型,让每个循环后模型都在进步。
具体工作流:结合亲和力等早期信号用 Nesso 1 等模型生成的 3D 结构打分;随后 ADME、效力、高级模拟、AI 逆合成分析等数百个模型作为一个集成系统运行,把数百万分子收敛到一张”不仅体外有戏、而且真的能合成”的短名单。设计进入自动化实验室(ChemSpeed 平台执行复杂多步药物化学,而非简单一锅反应),自动化的后处理、纯化与数字样品追踪管理数千个分子并留下完整数字记录;自研 AI 智能体帮科学家规划合成路线、提高平台与化学家的生产率。

两个工程细节值得单独记:一是化学家用自然语言描述实验,平台自动生成实验方案,无需手工编码;二是这套自动化把药理测试成本压到传统行业基准的约一半。另一个常被忽略的组织设计是:设计、制造、测试三个环节在同一个连接系统里完成,而不是在互不连通的工具与团队之间来回交接——化学家一天之内就能跑通一个完整设计循环,这在不具备模块化、数据与 AI 能力的体系里几乎不可能。
传统药物设计依赖几十年先例、个人经验、熟悉的化学与结合口袋;Recursion 的引擎则扩大化学家的探索口径,用工具分析复杂数据、预测非显然的设计假设、甚至在”没有任何先例可循”的位置预测如何合成。每一步结果都直接回流模型——闭环的意义”不是造更多分子,而是造更少的分子”。目前已产出超过 10 个研发候选物,且每一个都保持同样的质量与新颖性标准——他们强调”质与新颖性优于数量”,这才是 AI 对药物发现的真正影响所在。
ClinTech:把数据驱动延伸到临床试验
分子成为临床候选物后,进入专为临床开发设计的 ClinTech 体系,三个环节各有 AI 工具落地:
第一,入组前患者筛选。许多后期试验失败源于入组人群过于宽泛、异质,真实疗效被稀释。Cardinal 模型先在实验室里学习哪些癌细胞对新药有响应,再与数千例真实患者肿瘤比对,找出生物学特征最相似的患者群体——在首例患者入组前就预测谁最可能获益、为什么。一次分析中,这个方法识别出一个稳定区分”预测响应”与”耐药”肿瘤的特定基因突变——等于在流程里顺带发现了一个潜在生物标志物。这个案例的方法论价值在于:把实验室数据与真实患者数据连接起来,AI 模型就能产出两类可交付结果——更精准的入组人群定义,以及计划外的生物标志物假设,两者都能直接改变试验设计决策。
第二,试验中心选址。近 80% 的临床试验经历延误,入组是最常见原因。SiteFinder 工具基于超过 3 亿条真实世界患者记录与全球数十万试验点的情报,几小时内筛出高质量中心和研究者(传统要数月);它直接套用试验真实的入排标准,算出每个中心实际有多少合格患者,并优选业绩好、竞争少的中心。官方给出的成效:入组率提升 30% 到 60%,中心与国家可行性评估从数月压缩到数小时,研究启动时间最多缩短 3 个月。
第三,试验中决策。每份扫描、实验室测量、生物标志物与临床结局都在产生关于安全性和疗效的新证据。Recursion 持续把这些信号与纵向真实世界数据整合,对照疾病自然史与接受现有标准治疗的相似患者,来理解试验结果处于什么水平——这些真实世界证据帮助团队在早期临床信号出现时给出语境、修正开发决策,并为监管机构、医生与支付方构建更清晰的证据包。
具体落点是 ClinTech Biometrics 引擎:它把”每个试验配一名分析师”的手工流程替换为统一数据基础设施。剂量爬坡决策从通常的 7 到 10 个工作日缩短到 24 到 48 小时(约快 7 倍),每个评审周期的”数据到决策”时间下降 60% 到 80%。这套方法已在 Recursion 全管线应用。三个环节合起来,就是”选对患者、更快找到他们、在试验与真实世界双重语境下解读结果”——信号更清晰、决策更快也更自信。
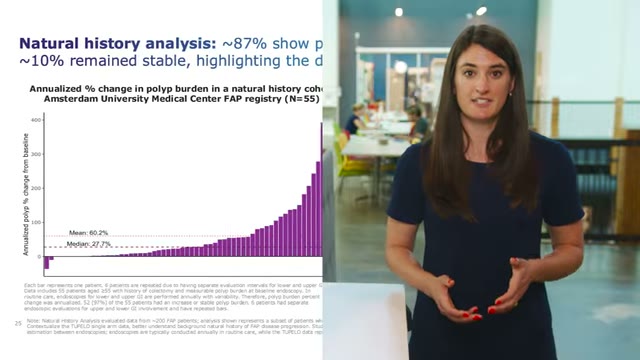
尾声:AI 智能体已进入全流程
视频结尾点题:这不是幻灯片上的设想,而是一套已把多个项目推进临床的生产系统。越来越多 AI 智能体与科学家并肩工作——大规模挖掘生物学地图、规划化学合成路线、搭建合适的试验中心网络。用 Recursion 的话说,这是一个”真正递归的系统”:发现新因果生物学洞见,以远低于行业的时间和成本设计类药分子,并用患者数据选出最可能获益的人群。他们把这套引擎的意义归结为一句话:不是做出一款更好的药,而是”改变药物被创造方式的复兴”——系统化、可重复地产出更好的药物,为还在等待的患者更快交付。
对 AI 工程师,这套系统最有参考价值的不是任何单一模型,而是三件事:把实验产线设计成模型友好的数据工厂(刻意随机化对抗捷径学习);让高维数据可复用、可被未来模型重挖;把”预测—合成—验证”做成一个不断回流的闭环,并用统一基础设施替换每试验一份的手工分析流程。
原文信息
- 原视频标题:From Data Factory to Better Drugs: Inside Recursion’s AI-Native Product Engine
- 频道:Recursion
- 讲者:Recursion 官方
- 发布日期:2026-08-17
- 视频时长:约 16 分钟
暂无评论,快来抢沙发~