Ray 加 PyTorch 分布式训练实验室:DDP 到 ZeRO 再到 FSDP 的选择路线
一句话结论
大模型微调绕不开分布式训练,但 DDP、ZeRO、FSDP 各自解决什么问题、什么时候用哪个,是这门动手实验室用一整场直播拆解清楚的核心问题。讲者把决策链讲得很直白:单卡放不下才需要分布式,显存仍不够再上 ZeRO 分级切分,模型大到极致用 FSDP,而 Ray Train 在底层负责把训练函数分发到多机、处理检查点同步、容错恢复和自动扩缩;再配上一条独立伸缩的数据准备管线,GPU 不用再等数据。
先回答「为什么需要分布式训练」
这是该实验室的第二个版本,讲者在开场说明:几个月前办过一场专注分布式训练核心概念的场次,这次在入门内容之上加深了对实际瓶颈和缓解手段的拆解。基础问题只有一个:模型和数据大到单卡(或单机)放不下时,必须把计算切分到多设备。
整场直播的信息密度围绕三条线展开:概念线(DDP 的同步机制、显存三件套的切分逻辑)、工程线(torchrun 的痛点、Ray Train 的解法、检查点陷阱)、架构线(数据管线与训练解耦、独立伸缩)。三条线相互独立又层层递进——概念不懂选错档位,工程不熟踩坑返工,架构不清 GPU 空转烧钱。
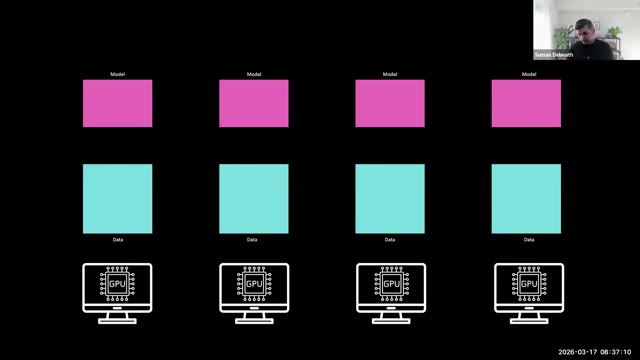
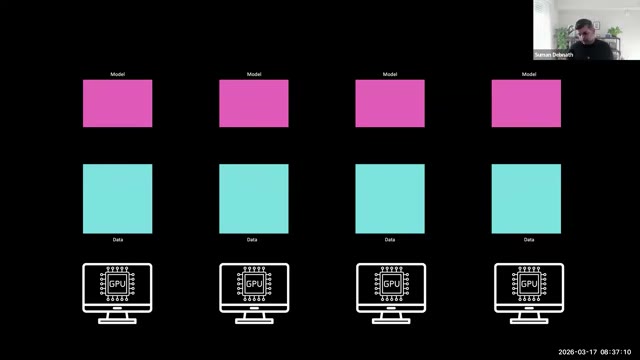
分布式数据并行(DDP)是起点。它的直觉是:四张 GPU 各持有一份相同的模型副本,分别吃四批不同的微批次数据。四张卡可以同机也可以跨机——跨机会引入网络延迟,但机制不变。这样训练大致能拿到四倍加速,不完全是四倍,因为梯度同步有开销。
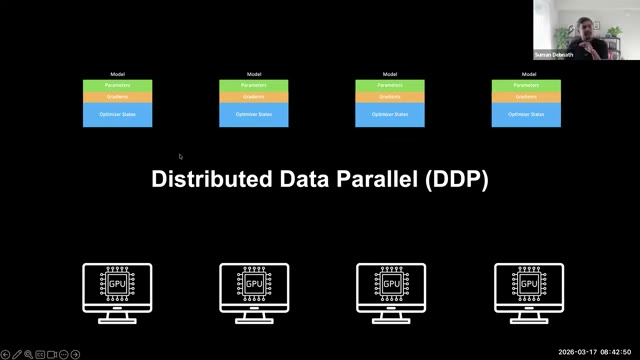
DDP 的关键机制在反向传播之后:前向传播各卡独立跑没问题,损失计算也没问题,但更新参数前必须先同步梯度——四张卡各算出四份不同的梯度,必须先汇总。这靠 NVIDIA GPU 的通信后端原语 all-reduce 完成:把所有卡的梯度归并。有观众问为什么只同步梯度不同步参数——因为参数在所有卡上是共享的,梯度归并后各卡可以独立更新各自的参数,不需要第二次同步。这正是 DDP 的精巧之处:一次通信解决一致性问题。
四倍加速的「大致」也值得展开:同步开销包括 all-reduce 的通信时间(跨机时受网络带宽限制)和各卡等待最慢者到齐的空转时间(straggler 效应)。卡数越多、模型越大,同步开销占比越高——这就是为什么 DDP 不是无限扩展的,也是后续 ZeRO、FSDP 等更复杂方案要同时解决的通信-显存权衡问题的起点。
DDP 的局限同样直白:每张卡都存完整模型参数、梯度和优化器状态,显存占用不随卡数下降。当模型大到单卡装不下完整副本时,就需要把这三样东西切分开——这正是 ZeRO 系列和 FSDP 的登场逻辑。
现场问答里的高频概念澄清
讲者在概念段密集回应了观众提问,几个澄清值得记录。
梯度累积发生在哪?它是一种优化技巧:不在全批次上一次反向,而是逐微批次保存梯度、做小规模前向重算激活,凑够后再统一更新。讲者写过专门博客讲这个机制,本场不展开。
四张卡吃的是同一批数据吗?不是。四份不同的微批次,这正是「数据并行」的含义——数据切分、模型复制。
数据预先放在每台机器本地吗?这是后面 Ray Data 部分要回答的问题,讲者先做了预告。
模型切分和数据切分是两件事吗?是。DDP/ZeRO/FSDP 讲的是模型状态(参数、梯度、优化器)怎么在卡间分布;数据并行讲的是训练样本怎么在卡间分片。两者正交:任何模型切分方案都配合数据分片使用,今天的主题就是数据并行家族——每张卡都吃不同的数据。
动手环境:L4 工作区与配套仓库
环境搭建延续 Anyscale 一贯的轻量风格:创建空白工作区,worker 节点选 L4 GPU 32G(T4 16G 也可以跑),节点数填 2,其余默认。这里有一个值得注意的开关:auto-scaling。启用后,提交作业时 Ray 会自动判断资源够不够、不够就自动加节点。演示里保持默认关闭。
工作区起来后打开网页版 VS Code,克隆配套仓库(vhol-ray-train,现场分享的 GitHub 链接),Notebook 已就位。讲者建议先跟完直播再动手,避免边听边操作的干扰。
现场互动细节也值得一提:讲者多次提醒观众用 Q&A 面板提问(不是聊天框),并承诺未答完的问题周末前逐一邮件回复——后台团队会标记哪些已答哪些未答。这场实验室的问答质量高,和这种运营纪律直接相关。幻灯片和 QR 码资源在结尾统一发放,不需要边听边抄链接。
理解集群拓扑是后面的基础:Ray 集群由一个 head node 加若干 worker node 组成。head node 只负责集群创建和管理,不跑训练;代码从 driver(通常就是 head node)提交,实际训练发生在 worker node。两节点的实验环境里,训练就分布在这两个 worker 上执行。
资源匹配的细节也在这时讲清:worker 节点类型在创建工作区时选定(L4 或 T4 GPU),ScalingConfig 里声明的 GPU 数量必须与实际可用资源对得上,资源不足时任务排队等待——启用 auto-scaling 则会自动加节点补足。这是「声明式资源」的基本纪律:训练代码只说「我要几张卡」,不说「去哪台机器拿卡」,调度全部交给框架。
从单卡代码到分布式代码:三处改动
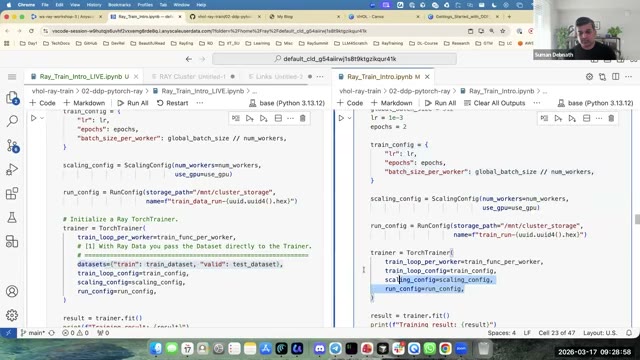
实验室的核心演示是把一份标准单卡 PyTorch 训练代码改造成 Ray Train 分布式版本,改动集中在三处。
第一处是数据加载:保留原生 PyTorch DataLoader,外面套一层 Ray Train 的 prepare_data_loader。这一层包装解决「每张卡拿到不同微批次」的分片问题,不需要自己写分发逻辑。改造的侵入性极低——原代码里 DataLoader 对象照常构造,只在传入训练循环前多包一层,其余数据增强、collate 等逻辑全部保留。对已有单卡代码库做分布式改造的团队,这意味着代码 diff 控制在几行以内。
第二处改动预备知识是理解「训练函数」概念:Ray Train 拓展了 PyTorch 的训练函数(train loop per worker),每个 GPU 工作进程都会执行同一份函数,框架负责让它们各拿各的数据分片、各自的 rank 编号。你在函数里写的还是标准训练循环,只是它会在 N 张卡上同时各跑一份。
第二处是模型准备:调用 prepare_model。默认套 DDP;如果要用 FSDP 或其他切分技术,在这里指定即可。这一行代码让模型按 ScalingConfig 的定义分布到所有 GPU。
第三处在 epoch 循环里:加数据 shuffle。分布式训练可以在加载时洗牌,也可以在每个 epoch 内洗牌,后者资源开销更友好。
损失函数和优化器完全不变。讲者反复强调这个设计哲学:训练函数内部保持标准 PyTorch 写法,分布式能力由框架注入,改造点到为止。
配置侧由三个对象组成。TrainingConfig 装学习率、epoch 数、批大小等超参。ScalingConfig 声明工作进程数和是否用 GPU。RunConfig 定义共享存储(演示用 NFS/EFS,S3 也行)和训练运行名,供管理区分多次训练。三个对象的分工边界清晰:训练逻辑相关的进 TrainingConfig,资源声明进 ScalingConfig,运维属性(存储、重试、检查点保留策略)进 RunConfig——后续团队协作时,改超参不动资源、改资源不动存储,互不踩脚。
全局批大小除以工作进程数等于每卡本地批大小——两个 GPU、全局批 512 时每卡 256。这个除法是数据并行的核心算术:全局批决定收敛行为(学习率缩放策略往往跟着全局批走),本地批决定单卡显存占用,两者通过卡数解耦。调整卡数时保持全局批不变,训练语义就不变——这也是弹性扩缩容(卡数变化恢复)能成立的前提。全局批大小除以工作进程数等于每卡本地批大小——两个 GPU、全局批 512 时每卡 256。执行 trainer.fit 后,框架按 ScalingConfig 起工作进程,把训练函数分发下去。
检查点的正确写法:一个 if 语句的差别
实验室里最细的工程点在检查点环节。每张卡的训练循环都会执行,但检查点只应从 0 号全局秩(rank 0)保存——否则同一份模型被重复写多次。DDP 场景下所有卡的模型副本相同,从哪张卡存都一样,选 rank 0 只是约定;但存一次就够,八张卡各存一份既是八倍存储浪费,也会让「哪份是权威」变得模糊。讲者现场还展示了模型产物(model artifacts)的保存路径约定:检查点和指标写入 RunConfig 指定的后端存储(S3 或共享存储),训练结束后的最终权重供下游推理直接加载。torch.save 先把检查点存到 0 号卡所在节点的本地目录,再用 ray.train.report 上传到共享存储。
关键陷阱:report 是阻塞调用,会等待所有工作进程的检查点到齐。如果把它放进只有 rank 0 执行的 if 块里,其他秩永远不参与,训练直接挂起。正确写法是本地保存在 if 内、上报调用在 if 外。讲者现场演示了错误版本的后果:训练就卡在那里不动了。
分布式检查点还支持卡数变化恢复——4 卡存的检查点,8 卡续训时自动对半切分重排,反过来从 10 卡掉到 8 卡也能续。
恢复逻辑写在训练函数开头:先探测共享存储里有没有检查点,有就从对应 epoch 继续,没有才从零开始。这个 if 判断就是「容错训练」的全部显式代码——其余的同步、上报、存储都由框架接手。对于跑几天几夜的大模型微调任务,这个机制决定了故障后是损失几分钟还是几天。
检查点配置是可选项:默认框架会自动管理;要自定义保留几个检查点、记录哪些指标,在 RunConfig 里加 CheckpointConfig 即可,演示代码里没展开。
用 Ray Data 解耦数据管线与训练
后半场讲进阶结构:把数据加载和预处理从训练函数里拿出来,交给 Ray Data,训练侧只管消费。这个改造解决一个真实瓶颈——训练 GPU 在等数据准备时空转。
架构上数据管线和训练完全解耦:数据准备放在独立的 CPU 节点上做(比如图像 embedding 这类需要 GPU 的转换,也可以配小 GPU,和训练 GPU 完全隔离),两边各自伸缩。这条架构线解决的是「GPU 饥饿」问题:训练卡等数据时空转,每一秒都是白烧的 GPU 时费用。预取机制保证数据块永远在训练 worker 门口排队,GPU 算完一批立即取下一批,中间没有等待间隙。讲者说他们在客户场景里看到的主流做法,就是数据加载与准备全部隔离在 CPU 节点、训练独占 GPU 节点,互不抢资源。
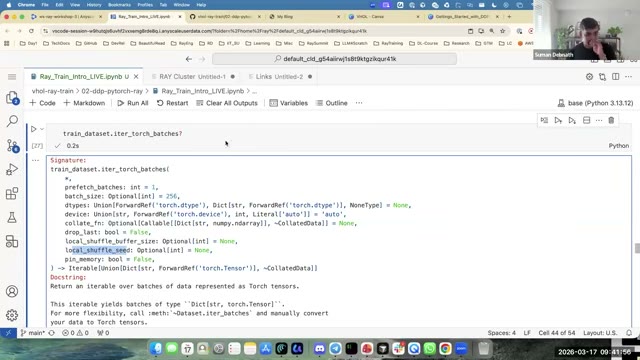
代码改动很小。训练函数外,用 ray.data.read_parquet(也有 read_csv、read_images 等一族 API)读共享存储数据,用 map 做预处理转换。训练函数内把 PyTorch DataLoader 整个拿掉,换成两个 Ray 调用。预取深度(prefetch)是这里的关键旋钮:预取太浅 GPU 会间歇性挨饿,太深则对象存储内存吃紧——讲者建议从默认值起步,用 Dashboard 的 GPU 利用率曲线反推调优。训练函数内,把 PyTorch DataLoader 换成 ray.train.get_data_shard 加 iter_torch_batches:前者取本工作进程的分片,后者把流式数据转成批次张量,并且可以配置 prefetch——预取深度保证 GPU 前一个批次算完,下一个批次已经在门口。这个函数就是「让 GPU 永远忙」的幕后机制。
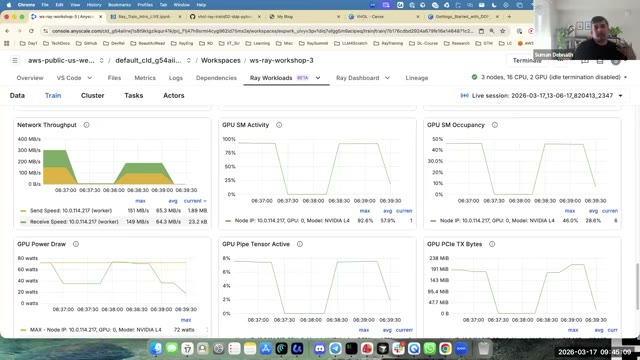
跑起来后 Dashboard 里能看到明显分工:Ray Data 在一组 worker 上读数据、做转换、写对象存储;Ray Train 在另一组 GPU worker 上训练。同一集群的两种负载各占所需资源,这就是「解耦数据管线」的具体形态。
有观众问数据集太大撑爆对象存储怎么办——讲者确认 Ray 对象存储支持溢写(spill)到后端存储,且可配置内存上限;注意对象存储是 Ray 的内存构造,不是 S3 那种外部对象存储。
另一个架构级问答:集群里混布不同规格 GPU 时怎么办?Ray 对集群成员和每台节点的加速器类型了如指掌,训练启动时可以显式指定用哪种 CPU/GPU 实例类型起 worker——比如数据预处理用 CPU 节点加小 GPU,训练用大 GPU,各取所需。
数据不本地化的网络延迟代价。 有观众问:把数据准备挪出 GPU 节点,网络延迟有多敏感?讲者的回答分三层。第一,跨节点确有网络吞吐上限,但 CPU 节点便宜,可以多加几个,让数据永远在 GPU 门口排队等着被取——用冗余换延迟。第二,GPU 节点自带的 CPU 也能做数据加载(不推荐,会抢训练资源)。第三,也是最有说服力的:他给出了实测基准。ResNet 模型、16 块 A100、纯 GPU 节点用 PyTorch DataLoader 供数,跑完 1800 秒;换成 Ray Data 加 10 个 CPU 节点做数据预处理和加载、同样的 A100 训练,训练运行时间缩短近 70%。当然多加了 CPU 资源、成本有增加,但 A100 的计费时长砍掉了七成——总有效成本反而下降。这个数字是「解耦数据管线」最硬的价值证据。
shuffle 发生在哪。 观众追问洗牌位置。讲者演示了两处:一是数据集加载分发到多 GPU 时的全局洗牌(资源开销大,通常避开);二是每个 worker 内部、iter_torch_batches 迭代时的本地洗牌——参数一开即用。分布式训练的 shuffle 策略是性能调优的常见抓手,知道「有两处可洗、各有什么代价」就掌握了主动权。
失败恢复的分工。 Dashboard 里能看到每次训练的 worker 数、GPU 状态,失败后 Ray 自动起新 actor 或新 worker 续跑——这部分不需要写代码。想加更复杂的重试逻辑可以自己 augment,但基础容错是框架自带的。「从 10 卡掉到 8 卡怎么续训」这个 torchrun 时代最棘手的问题,在 Ray Train 里是默认行为。
torchrun 对比 Ray Train:不只是省几行命令
现场问答里最值得展开的是这个对比。用 torchrun 做分布式训练,需要把代码复制到所有机器、逐台 SSH 过去启动,还要自己处理可观测性、故障恢复——比如从 10 卡掉到 8 卡后如何续训,这些在 torchrun 路径下「都非常棘手」。
Ray Train 的方案是把训练函数交给框架:指定 ScalingConfig 里的工作进程数和 GPU 需求,Ray 负责找资源、起集群、分发任务,失败后自动重试(重试次数可配置)。自动伸缩开启后,提交作业时资源不够,框架自动加节点——伸缩决策不需要人工介入。训练函数本身仍是标准 PyTorch 写法,全局批大小除以工作进程数就是每卡的本地批大小。前面讲的检查点同步、卡数变化恢复、异构资源调度,都是 torchrun 需要自己造轮子的部分。
什么时候用哪一档
把全场的决策逻辑串成一条线:模型能装进单卡,本地训练即可;装不下但要多卡加速,DDP 够用;参数、梯度、优化器状态加起来显存吃紧,按需选 ZeRO-1(只切优化器状态)、ZeRO-2(加切梯度)、ZeRO-3(全切);模型大到 ZeRO-3 也吃力,FSDP 是更深度的切分方案——本质上仍是数据并行,但把模型本身也切到多卡,适用于参数、梯度、优化器状态无法同时完整放进所有 GPU 的场景。ZeRO 的分档逻辑值得记住底数:Adam 类优化器的状态约占参数量两倍,加上梯度和参数本身,混合精度下总显存需求可达参数量的十余倍——这就是为什么几十 B 参数的模型微调动辄需要多卡切分。讲者提到 Anyscale 频道还有专门的 FSDP 场次可深入。
另有观众问 Ray Data 和 PySpark 怎么选:PySpark 强在纯文本、无需 GPU 的分布式数据处理;Ray Data 天生多模态,对 GPU 处理原生友好——视频、图像这类需要加速器参与的数据准备,是 Ray Data 的主场。
延伸练习也值得记录:讲者留了一个 Qwen-3 文本转语音模型用 FSDP 微调的作业,想巩固 FSDP 知识的观众可以拿它练手——文本转语音模型参数量大,正好落在 FSDP 的适用区间。
决策链的另一个隐含前提是成本视角:DDP 每卡持有全量模型,卡数增加只加速不减显存;ZeRO 和 FSDP 用通信换显存,能训更大的模型但步速变慢。「快」和「大」在分布式训练里是两个独立维度,先明确自己的约束是哪一个,再选档位就不会走弯路。
配套 GitHub 仓库和幻灯片全部公开,注册 Anyscale 后在 Workspace 里点模板即可复现。讲者建议的跟跑路径:先看直播回放理解概念分工,再开工作区克隆仓库跑 Notebook,最后拿自己的数据集替换示例数据——三步走完,这套分布式训练骨架就是自己的了。
原文信息
- 原视频标题:Live Virtual Hands On Lab: Distributed Training at Scale with Ray and PyTorch
- 频道:Anyscale
- 讲者:Anyscale 动手实验室讲师(直播中主讲分布式训练与 Ray Train)
- 发布日期:2026-03-17
- 视频时长:约 81 分钟
暂无评论,快来抢沙发~