Qwen3-TTS如何用500万小时的声音训练出最像人的语音合成
你正在开车,手机收到一条长消息。
你说「读给我听」,然后一个声音开始朗读。
这个声音不是那种机械的、一字一顿的机器人腔调,而是像真人在跟你聊天一样,有停顿、有语气、有情感。
更神奇的是,这个声音可以是你自己的声音。
只需要3秒钟的录音,AI就能学会你说话的方式,然后用你的声音读出任何内容。
这就是阿里通义团队刚刚发布的Qwen3-TTS实现的事情。
为什么语音合成这么难?

在深入技术细节之前,我们先聊聊为什么让机器「说话」这件事这么难。
TTS(Text-to-Speech):文本转语音技术,就是让计算机把文字变成声音。听起来简单,但要做到自然、流畅、有感情,难度堪比让机器人学会跳芭蕾。
人类说话是一件极其复杂的事情。
同样一句「今天天气真好」,你可以用开心的语气说,可以用讽刺的语气说,可以用疲惫的语气说。
每种语气背后,是声带振动频率的微妙变化、气息控制的精确调节、嘴唇舌头的协调运动。
传统的语音合成方法,就像是用乐高积木搭建一座城堡。
你有很多预制的语音片段,然后把它们拼接起来。
结果呢?听起来总是有点「假」,就像那些电话客服的自动语音,你一听就知道是机器。
而Qwen3-TTS采用了一种完全不同的思路:不是拼接,而是生成。
核心创新:把声音变成「语言」

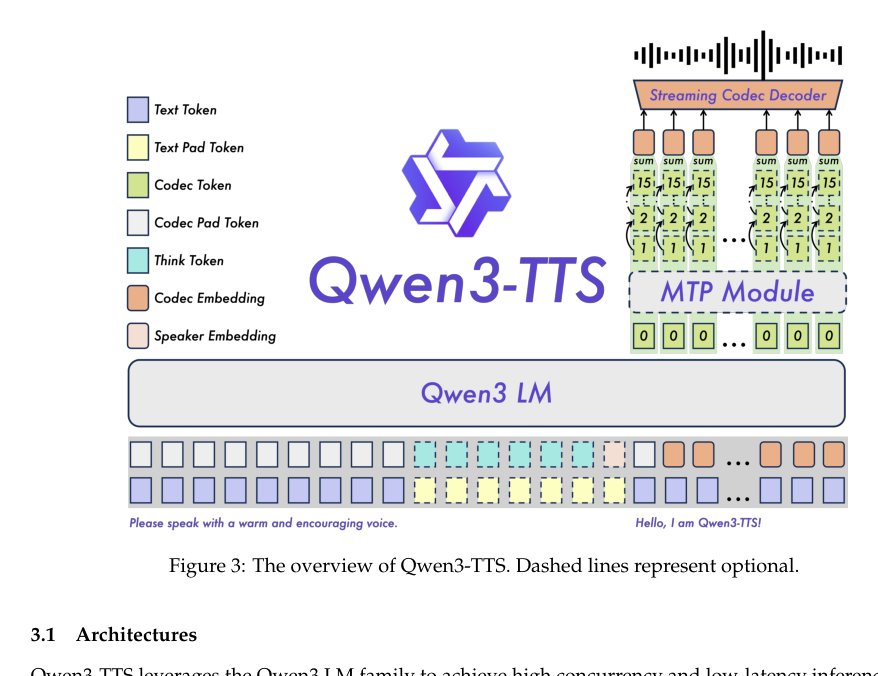
Qwen3-TTS最核心的创新,是把语音合成问题转化成了一个语言模型问题。
语言模型(Language Model):一种能够理解和生成文本的AI模型。比如ChatGPT就是一个语言模型,它能根据你说的话,预测下一个最合适的词是什么。
这个思路听起来有点绕,让我用一个类比来解释。
想象你在学一门外语。
传统方法是背单词、背句型,然后机械地组合。
但真正学会一门语言的人,是在大量听和说的过程中,自然而然地掌握了语言的「感觉」。
Qwen3-TTS做的事情类似。
它不是学习「这个字应该发什么音」,而是学习「声音的语言」。
具体怎么做呢?
首先,它把连续的声音波形转换成离散的「语音token」。
Token:可以理解为语言的最小单位。在文本中,token可能是一个词或一个字。在语音中,token是一小段声音的编码表示。
这就像是给声音编了一套「密码」。
原本连续的声波,变成了一串数字序列。
然后,语言模型就可以像处理文字一样处理这些「声音密码」了。
两种Tokenizer:速度与质量的平衡

Qwen3-TTS设计了两种不同的语音编码器(Tokenizer),分别针对不同的使用场景。
Tokenizer(分词器/编码器):把原始数据转换成模型能理解的格式的工具。在语音领域,就是把声波转换成数字序列。
第一种:Qwen-TTS-Tokenizer-25Hz
这个编码器每秒产生25个token,采用单码本设计。
码本(Codebook):可以理解为一本「声音字典」。每个token对应字典里的一个条目,代表一种特定的声音模式。
它的特点是语义信息丰富。
什么意思呢?就是它编码出来的token,不仅包含「这个声音听起来像什么」,还包含「这个声音在说什么」。
这种设计的好处是,生成的语音更加稳定、更少出错。
但缺点是,解码(把token变回声音)需要用到扩散模型,速度相对较慢。
扩散模型(Diffusion Model):一种生成模型,通过逐步去除噪声来生成高质量内容。就像雕塑家从一块大理石中慢慢雕刻出作品一样。
第二种:Qwen-TTS-Tokenizer-12Hz
这个编码器每秒只产生12.5个token,但采用16层多码本设计。
想象一下,如果单码本是一本普通字典,那多码本就是一套百科全书。
第一层码本负责记录语义信息(说的是什么),后面的层负责记录声学细节(听起来像什么)。
这种设计的最大优势是超低延迟。
因为解码器只需要一个轻量级的卷积网络,不需要复杂的扩散模型。
延迟(Latency):从输入到输出的时间间隔。在语音合成中,就是从你输入文字到听到声音的等待时间。
实测数据显示,12Hz版本的首包延迟只有97毫秒。
这意味着什么?你几乎感觉不到任何等待,文字输入的同时声音就开始播放了。

500万小时的声音训练

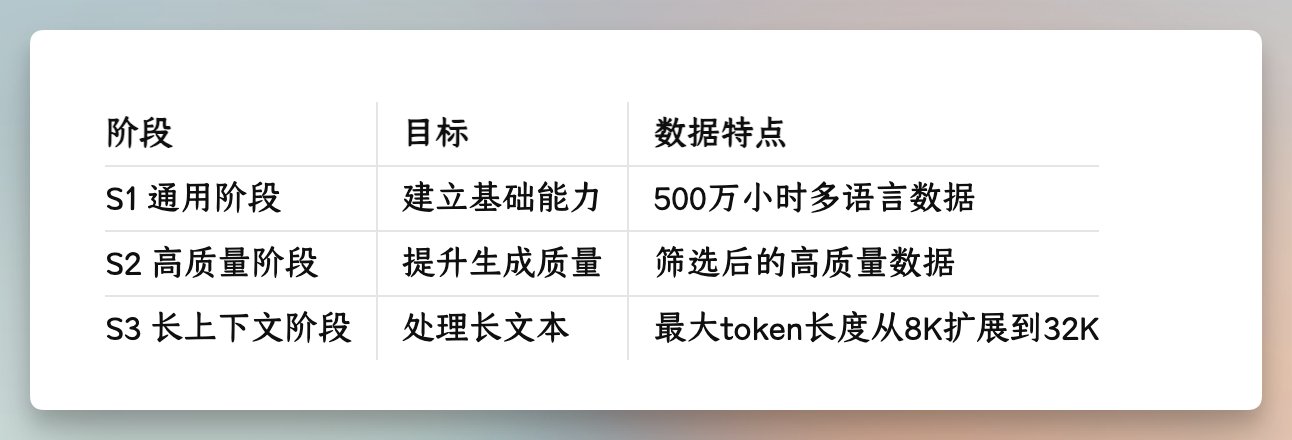
Qwen3-TTS的训练数据量是惊人的:超过500万小时的语音数据,覆盖10种语言。
这是什么概念?如果一个人每天听8小时,需要听1700多年才能听完这些数据。
训练过程分为三个阶段:
后训练(Post-training):在预训练完成后,针对特定目标进行的额外训练。通常用于让模型更符合人类偏好。
后训练用到了一个叫DPO的技术。
DPO(Direct Preference Optimization):直接偏好优化,一种让模型学习人类偏好的方法。简单说,就是给模型看两个输出,告诉它哪个更好,让它学会生成更好的那种。
通过DPO,Qwen3-TTS学会了什么样的语音听起来更自然、更舒服。
3秒克隆你的声音

Qwen3-TTS最吸引人的功能之一,是3秒声音克隆。
只需要3秒钟的参考音频,模型就能学会一个人的声音特征,然后用这个声音说出任何内容。
这是怎么做到的?
模型内部有一个「说话人编码器」(Speaker Encoder),它能从参考音频中提取出说话人的声音特征,比如音色、语调习惯、说话节奏等。
然后,这些特征会被注入到生成过程中,让输出的语音带上这个人的「声音指纹」。
实验数据显示,在Seed-TTS测试集上,Qwen3-TTS的声音克隆效果超过了所有竞争对手:

WER(Word Error Rate):词错误率,衡量语音识别或合成准确性的指标。数值越低越好。
用自然语言「设计」声音

除了克隆现有声音,Qwen3-TTS还支持一个更酷的功能:用自然语言描述来创造全新的声音。
比如,你可以告诉模型:「我想要一个温柔的女声,语速稍慢,带点南方口音。」然后模型就会生成符合这个描述的声音。
这个功能背后的技术叫做「指令跟随」(Instruction Following)。
指令跟随(Instruction Following):模型理解并执行自然语言指令的能力。就像一个听话的助手,你说什么它就做什么。
Qwen3-TTS在这方面的表现也很出色。
在InstructTTSEval基准测试中,它在「声音设计」任务上达到了开源模型的最佳水平:

APS(Attribute Perception and Synthesis):属性感知与合成准确率,衡量模型是否正确理解并生成了指定的声音属性。
跨语言的声音保持

一个有趣的挑战是:如果我用中文录了一段参考音频,然后让模型用英文说话,它能保持我的声音特征吗?
这就是「跨语言语音合成」问题。
跨语言语音合成(Cross-lingual TTS):用一种语言的参考音频,生成另一种语言的语音,同时保持说话人的声音特征。
Qwen3-TTS在这方面表现惊艳。
特别是在中文到韩语的转换中,错误率比之前最好的模型降低了66%:

这意味着什么?你可以用自己的声音,流利地「说」任何语言。虽然你可能不会说韩语,但AI可以用你的声音说韩语。
10分钟长文本的稳定生成

长文本语音合成是另一个技术难点。
传统的自回归模型在生成长序列时,容易出现「漂移」问题。
就像一个人说话说久了会跑调一样,模型生成的语音也会逐渐变得不稳定,出现重复、遗漏或者韵律断裂。
Qwen3-TTS通过特殊的训练策略解决了这个问题。
在S3阶段,团队专门增加了长语音数据的比例,并把最大token长度扩展到32K。
实测结果显示,Qwen3-TTS可以稳定生成超过10分钟的连续语音,而且质量不下降:

这说明长文本生成确实是一个很难的问题。而Qwen3-TTS的表现几乎和短文本一样稳定。
实时流式输出

在实际应用中,用户不想等模型把整段话都生成完才开始播放。
他们希望输入文字的同时就能听到声音。
这就需要「流式输出」能力。
流式输出(Streaming Output):边生成边输出,不需要等待全部完成。就像水龙头的水流,而不是一桶水一次性倒出来。
Qwen3-TTS的12Hz版本在这方面做到了极致。
首包延迟只有97毫秒,这意味着用户几乎感觉不到任何等待。
为什么12Hz版本能做到这么快?
关键在于它的解码器设计。
25Hz版本需要用扩散模型来解码,而扩散模型需要「看到未来」才能工作(技术上叫lookahead)。
12Hz版本用的是纯因果卷积网络,只需要看到当前和过去的信息就能解码。
因果(Causal):在时间序列处理中,因果意味着只依赖过去和当前的信息,不依赖未来的信息。这对实时处理至关重要。
模型家族一览

Qwen3-TTS不是一个模型,而是一个模型家族。
根据不同的需求,你可以选择不同的版本:

所有模型都以Apache 2.0协议开源,这意味着你可以免费使用,甚至用于商业目的。
这项技术意味着什么?

让我们跳出技术细节,想想这项技术的更大意义。
首先,它让语音交互变得更自然。
现在的语音助手,比如Siri、小爱同学,说话还是有明显的「机器味」。
Qwen3-TTS这样的技术,可以让AI的声音变得和真人一样自然。
这不仅仅是听起来更舒服的问题,而是会改变我们和机器交互的方式。
其次,它让内容创作变得更容易。
想象一下,你写了一篇文章,想把它变成播客。
以前你需要自己录音,或者花钱请配音演员。
现在,你可以用AI生成高质量的语音,而且可以选择任何你喜欢的声音风格。
第三,它让语言障碍变得更小。
跨语言语音合成意味着,你可以用自己的声音「说」任何语言。
这对于国际交流、教育、娱乐都有巨大的潜力。
当然,这项技术也带来了一些值得思考的问题。
比如,如果AI可以完美模仿任何人的声音,如何防止被滥用?如何区分真人声音和AI生成的声音?这些问题,需要技术界和社会共同面对。
写在最后

Qwen3-TTS代表了语音合成技术的一个重要里程碑。
它不仅在各项指标上达到了最先进水平,更重要的是,它展示了一种新的技术路线:把语音合成问题转化为语言模型问题
这种思路的威力在于,它可以充分利用大语言模型领域的所有进展。
随着语言模型变得越来越强大,语音合成的质量也会水涨船高。
从更宏观的角度看,Qwen3-TTS是通向AGI(通用人工智能)道路上的一块重要拼图。
一个真正智能的AI,不仅要能理解和生成文字,还要能理解和生成声音。Qwen3-TTS让我们离这个目标又近了一步。
技术的进步总是让人既兴奋又敬畏。当AI学会了像人一样说话,我们离科幻电影里的未来,又近了一点。
原文信息
- 作者:向阳乔木(@vista8)
- 原文发布日期:2026-01-23 原文地址: