PrismML 发布 Ternary Bonsai 2 27B:一款 5.9 GB 的 Apache 2.0 模型,保留了 Qwen3.8 27B 98.2% 的性能
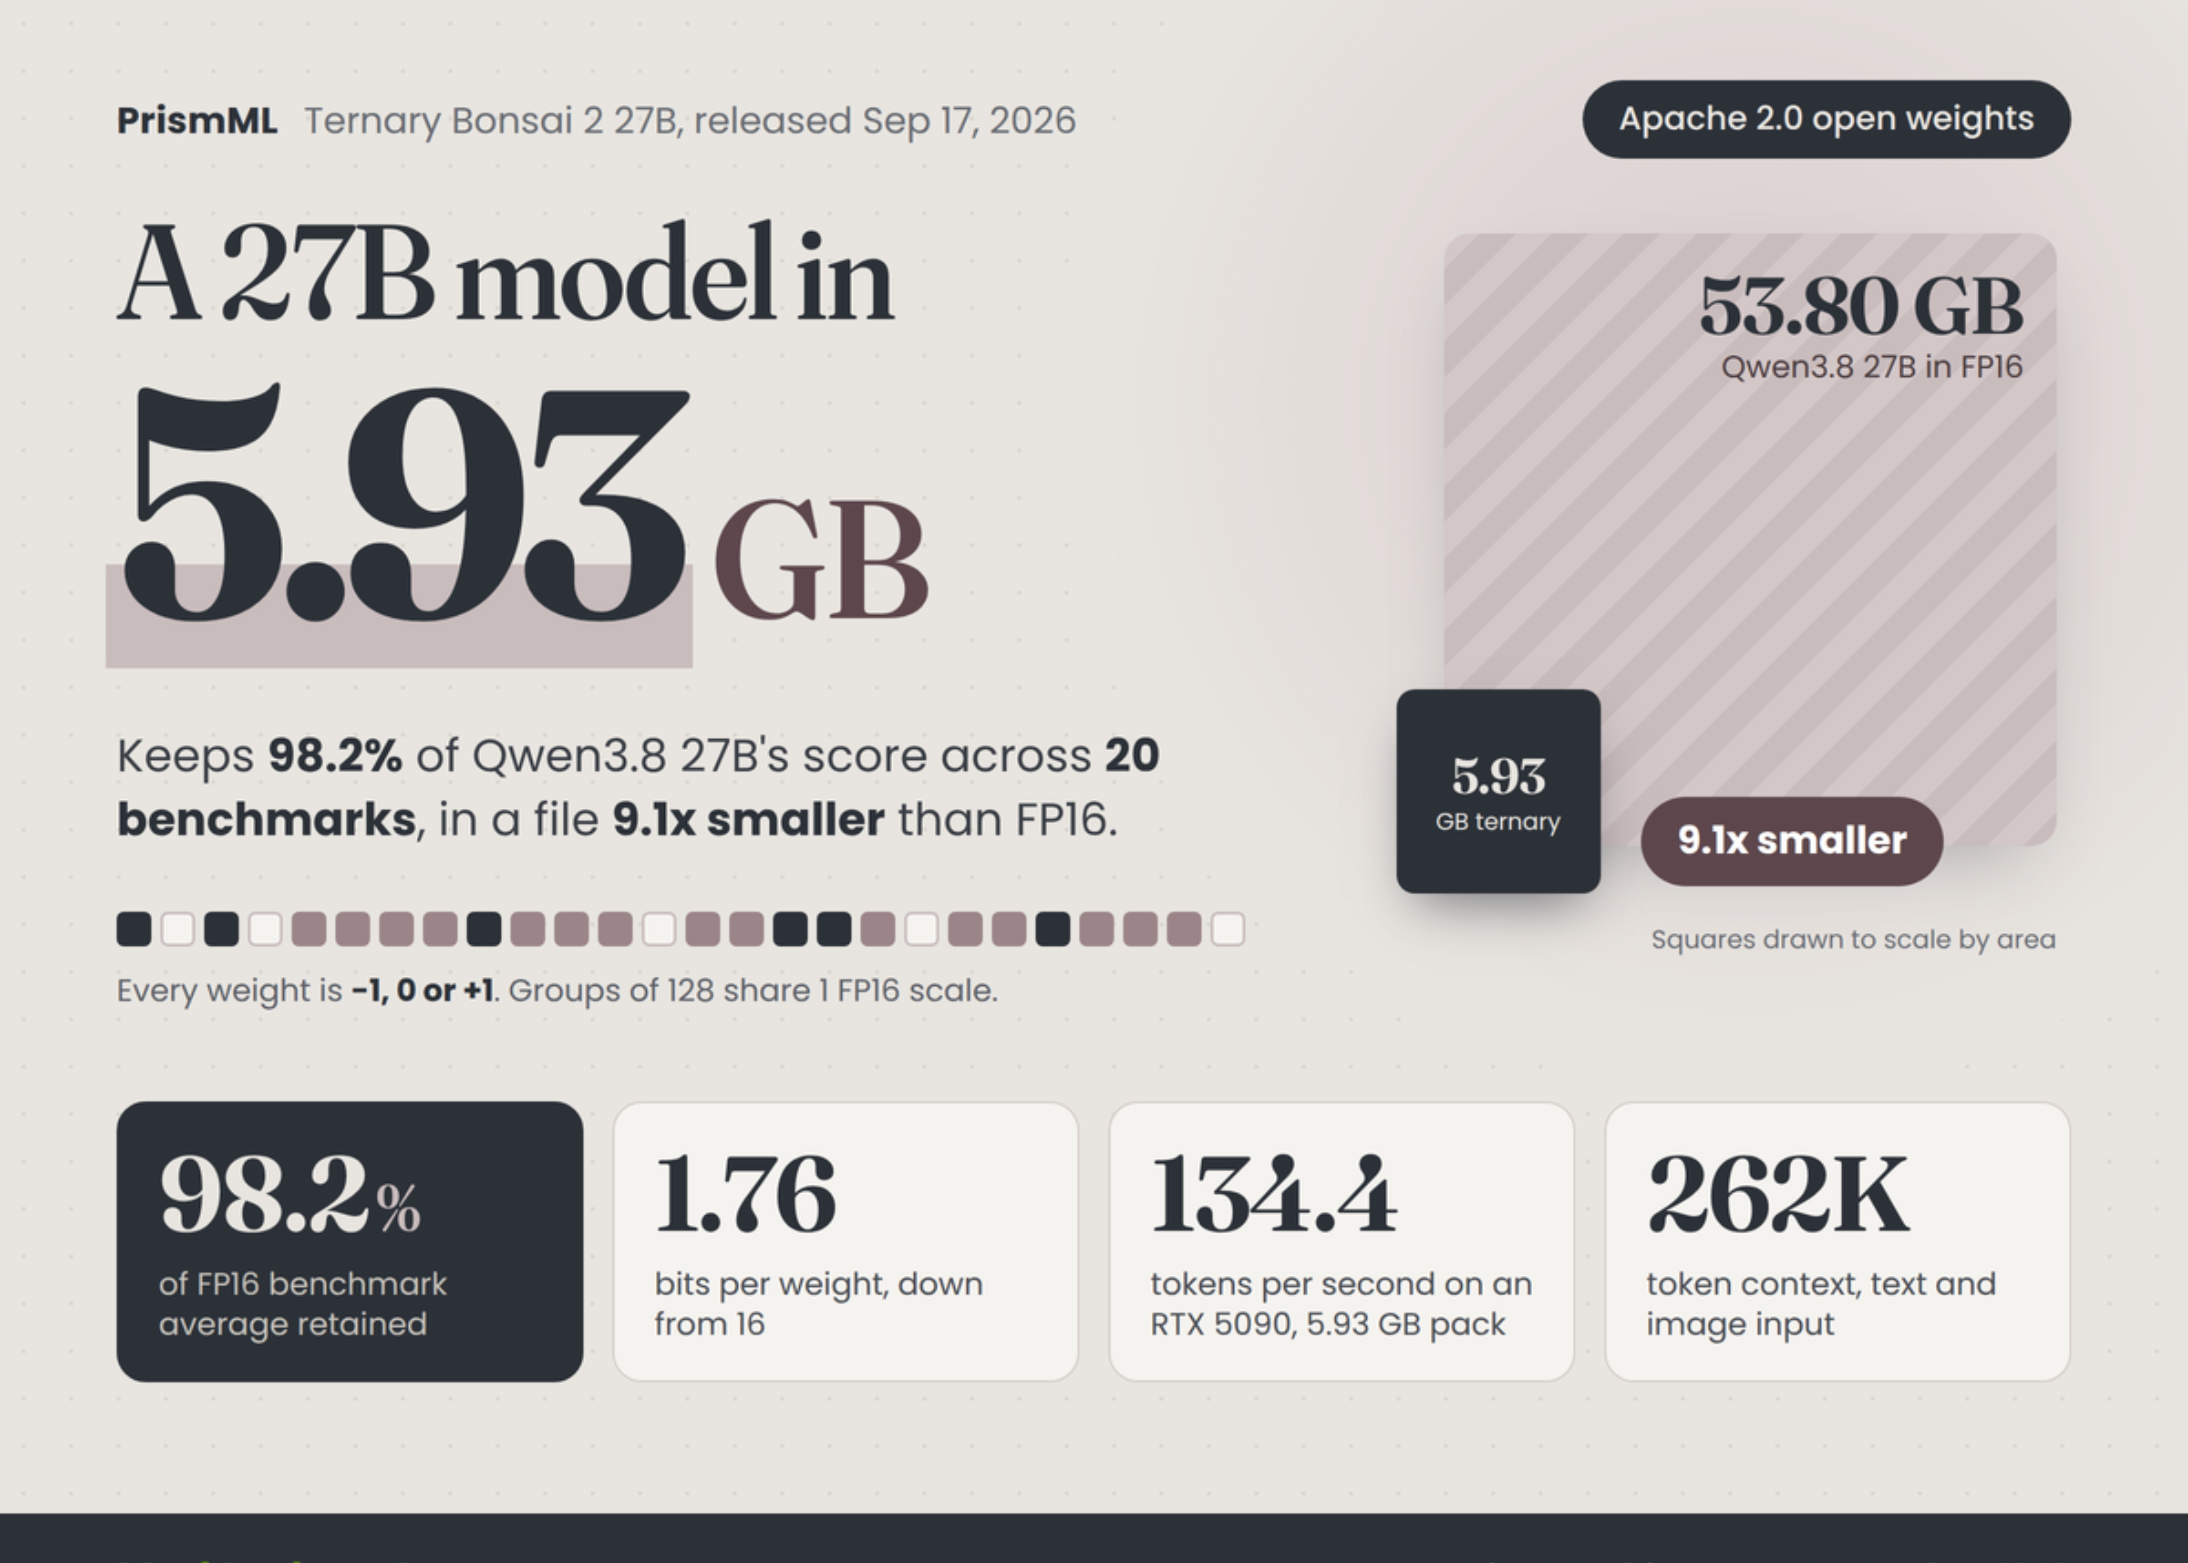
📌 One-Sentence Summary PrismML 推出 Ternary Bonsai 2 27B,一款紧凑的 5.93 GB 模型,在 20 项基准测试中保留了 Qwen3.8 27B 98.2% 的性能,使消费者硬件能够高效部署,且质量损失最小。
📝 Summary Ternary Bonsai 2 27B 是 Qwen3.8 27B 的量化版本,使用三元权重格式将模型大小从 53.80 GB 减小到 5.93 GB。尽管压缩显著,但模型保持了高保真度,在一系列基准测试中得分 83.9/85.4。架构保持不变,量化主要影响语言主干,同时保留了视觉塔和归一化层。该模型针对现代 GPU 和 Apple 芯片的快速推理进行了优化,并采用了特定的打包方案来平衡内存使用和计算效率。
💡 Main Points 高压缩,损失极小 该模型实现了 9.1 倍的大小减小(从 53.80 GB 到 5.93 GB),同时在 20 项基准测试中保留了 98.2% 的原始 Qwen3.8 27B 性能。这表明三元量化在保留模型能力方面非常有效。高效的硬件利用 紧凑的尺寸允许模型在消费者级硬件上运行,例如 16 GB 笔记本或单块 24 GB GPU。提供的基准测试显示了在各种平台上的强劲性能,包括 RTX 5090(142.5 tokens/s)和 M5 Max(46.8 tokens/s),使其适合边缘或本地部署。
专门的打包和旋转 白皮书描述了两种专门的 GGUF 打包方式(PTQ1_0 和 PQ2_0),旨在实现高效的内存访问和计算。此外,在量化过程中使用旋转基(Hadamard 旋转)有助于减轻通常与二进制或三元格式相关的精度损失。任务间保留率不均 虽然整体保留率很高,但模型在特定任务上的表现各不相同。例如,视觉任务保留了 96.3%,知识/推理保留了 96.9%,而长时序代理基准(如 SWE-bench)则下降到约 75%。这表明量化是稳健的,但可能在某些领域存在特定弱点。
💬 Key Quotes 该模型保持了 Qwen3.8 27B 的架构不变。它拥有 27.36 亿个参数。这分为 24.35 亿个语言主干、2.54 亿个嵌入和 LM 头,以及 0.47 亿个视觉塔。
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 4 min
Word Count: 953
Tags: AI 与智能应用 , 模型发布 , Apple 芯片 , AI 硬件与芯片 , 模型训练与推理
内容翔实,正好需要,先收藏再看。
楼主辛苦了,内容很有参考价值。
这篇文章分析得很透彻,收藏了!
这个观点很中肯,深有同感。
实话,说的不明不白
实话,说的不明不白
看完了,收获满满,期待更多更新。
讲解得很细致,新手也能看懂。
看标题就点进来了,内容果然没让人失望。
思路清晰,干货满满。
这篇文章分析得很透彻,收藏了!
内容翔实,正好需要,先收藏再看。