Prime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播提速 3.11 倍
📌 One-Sentence Summary
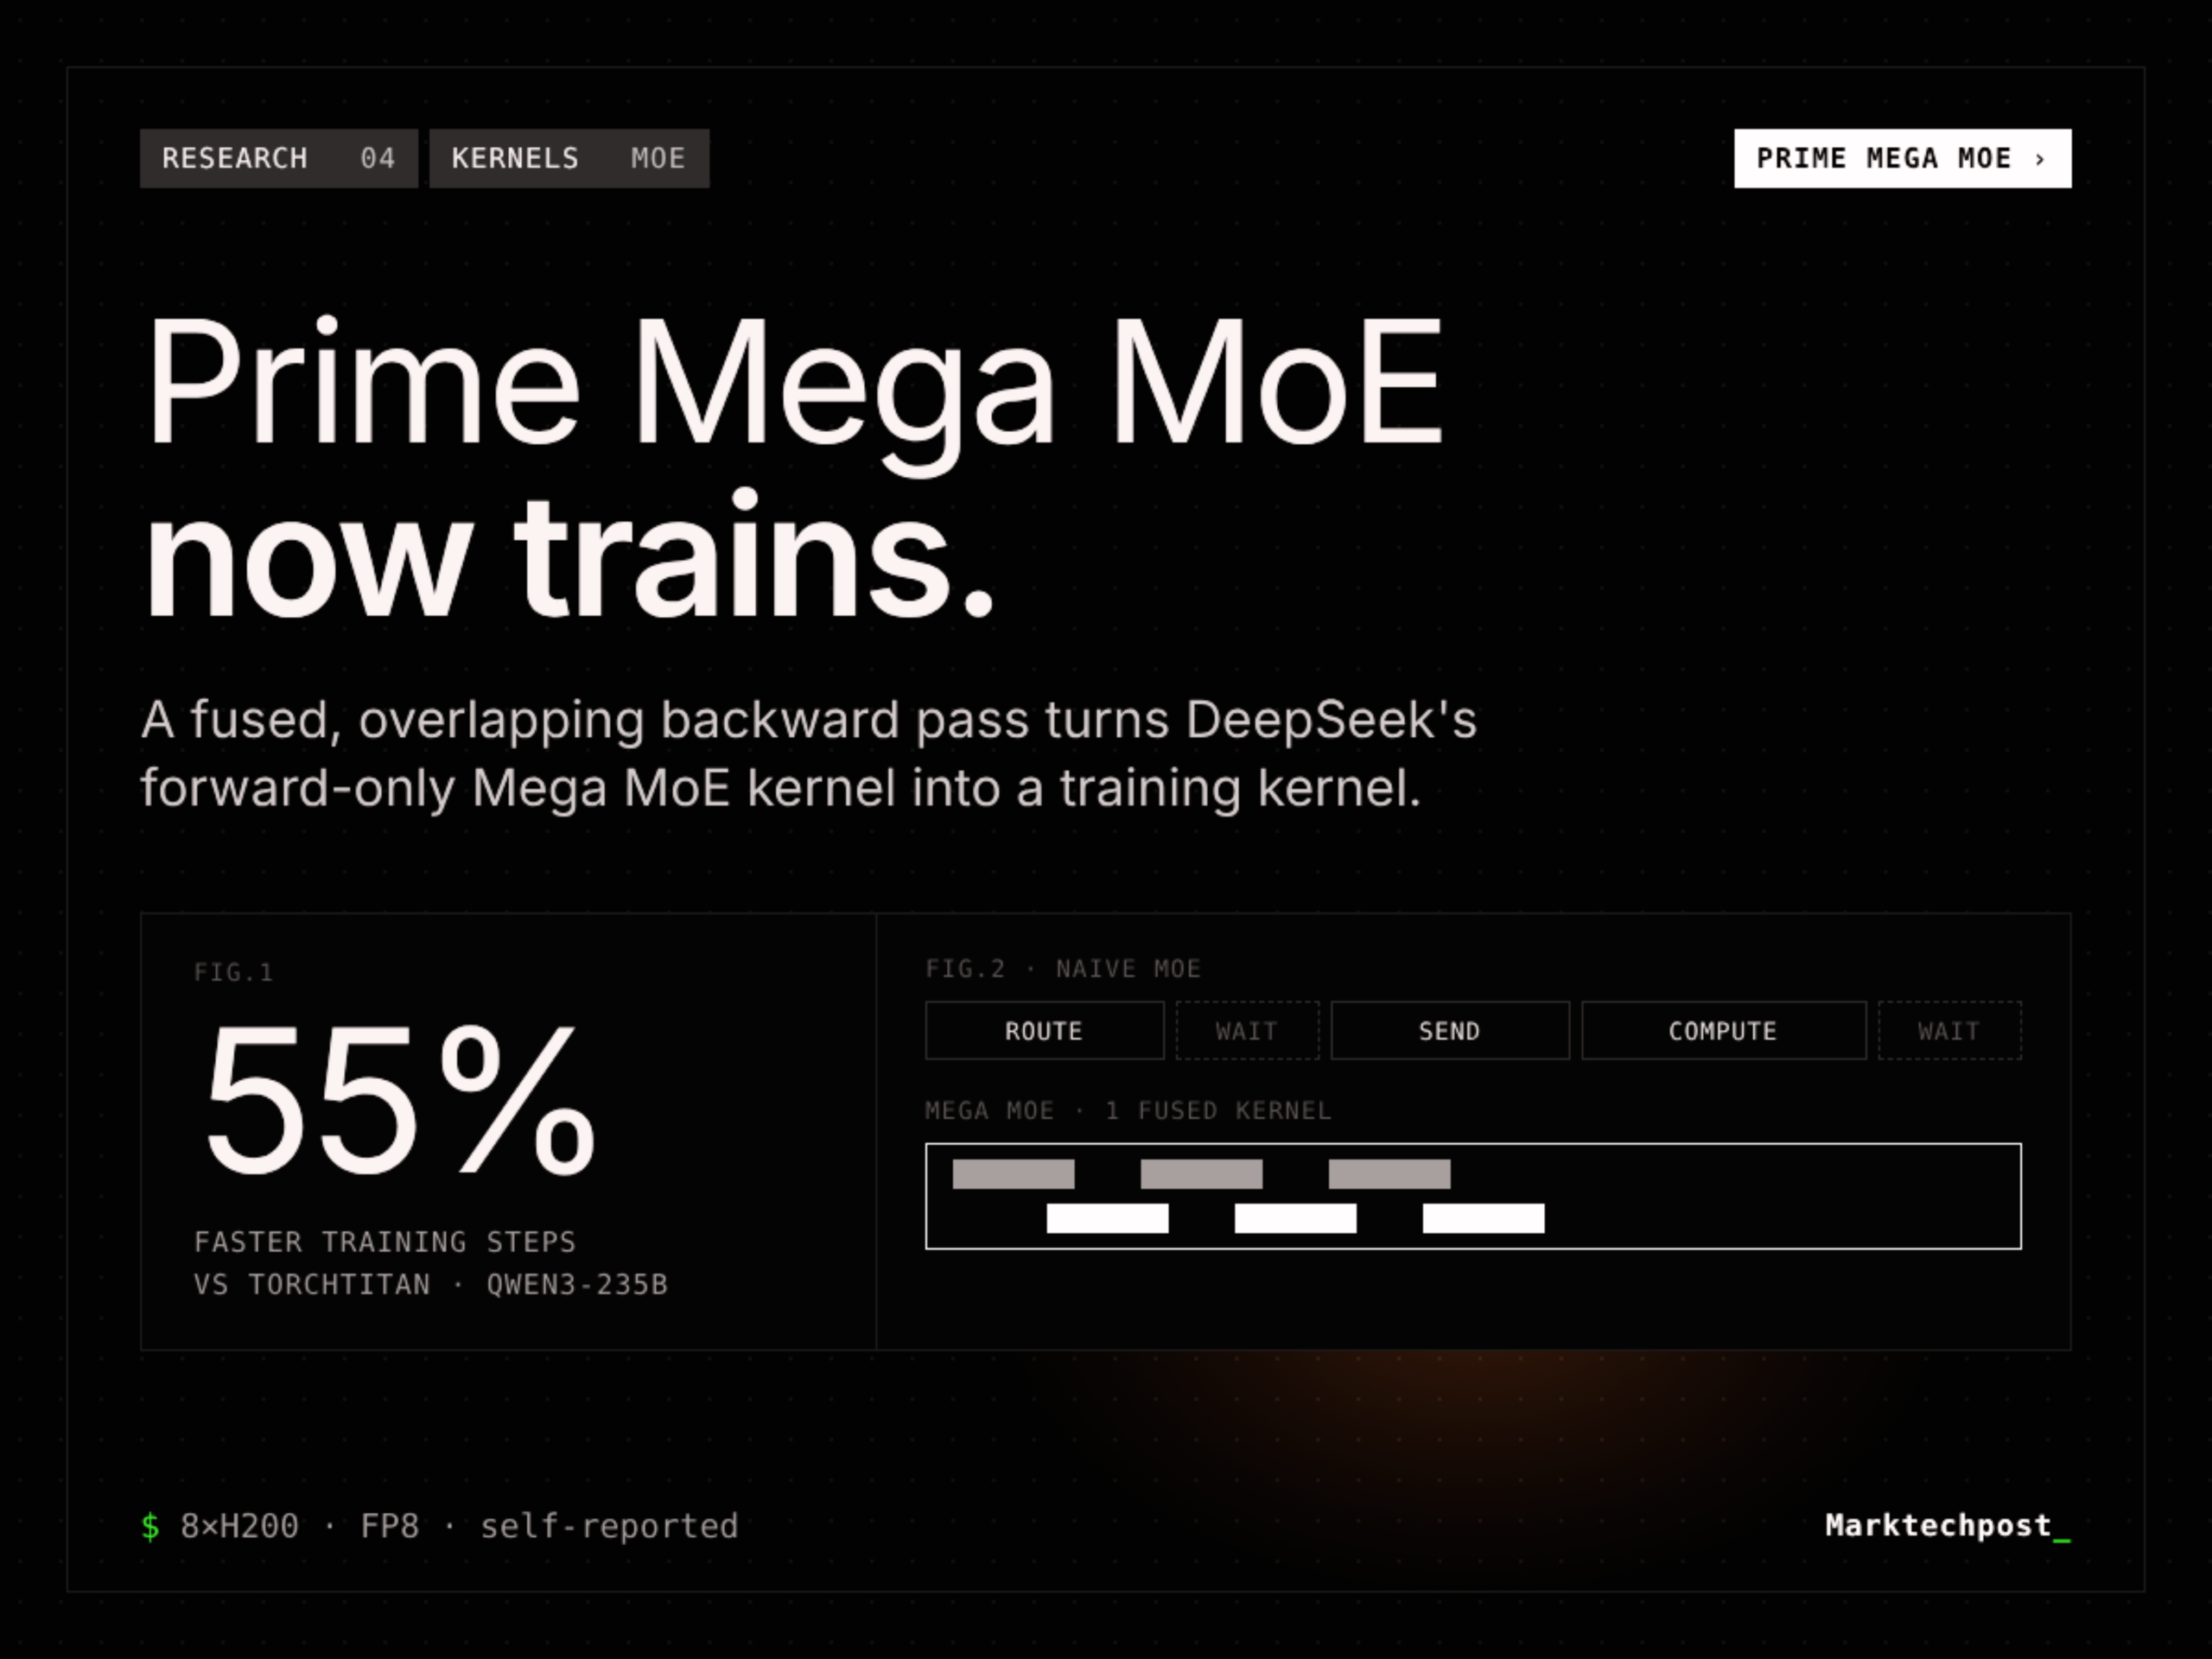
Prime Intellect 发布了 Prime Mega MoE,这是对 DeepSeek 融合 MoE 内核的训练扩展版本,新增了重叠反向传播,相比 TorchTitan 可将训练速度提升最高 55%。
📝 Summary
Prime Intellect 推出了 Prime Mega MoE,这是一个基于 DeepSeek MoE 库构建的优化内核。原版内核仅聚焦于前向传播,而新版本加入了快速的重叠反向传播,使其可用于完整的模型训练。在 Qwen3 MoE 模型上的测试显示,相比 prime-rl 基线提速 32-34%,相比 TorchTitan 提升最高 55%。它支持 NVIDIA Hopper 和 Blackwell 架构,并兼容 BF16 和 MXFP8 等数据类型。
💡 Main Points
在 DeepSeek 融合内核基础上新增重叠反向传播
DeepSeek 的原版内核仅处理前向传播;Prime Intellect 加入了快速反向传播,使其可用于完整的训练工作流。
相比 TorchTitan 取得显著性能提升
在训练 Qwen3 MoE 模型时,该内核的每步速度比 TorchTitan 快最高 55%,比内部基线快 34%。
硬件与数据类型灵活性
该内核面向 NVIDIA Hopper(块级 FP8)和 Blackwell(MXFP8)GPU 设计,支持 BF16 和 MXFP8 精度。
💬 Key Quotes
Prime Intellect 加入了一个快速的重叠反向传播。这使得融合内核不仅可用于推理,还可用于训练。
相比 TorchTitan,提升达到 55%。
标题中的「最高 3.11 倍」仅指前向传播。
📊 Article Meta
AI Screening: 86
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 4 min
Word Count: 985
Tags:
AI 与智能应用 , 混合专家模型 , 性能优化 , 赛车运动 , AI 硬件与芯片
路过
这个观点很中肯,深有同感。
路过
看标题就点进来了,内容果然没让人失望。
这篇文章分析得很透彻,收藏了!
刚好最近在找这方面的资料,太及时了。
这个观点很中肯,深有同感。
这个比较实用,已转发给同事。
这个比较实用,已转发给同事。
不错不错,已加入书签。
看完了,收获满满,期待更多更新。
不错不错,已加入书签。