破解 AI 的“随机”数需要多少次猜测?
📌 One-Sentence Summary
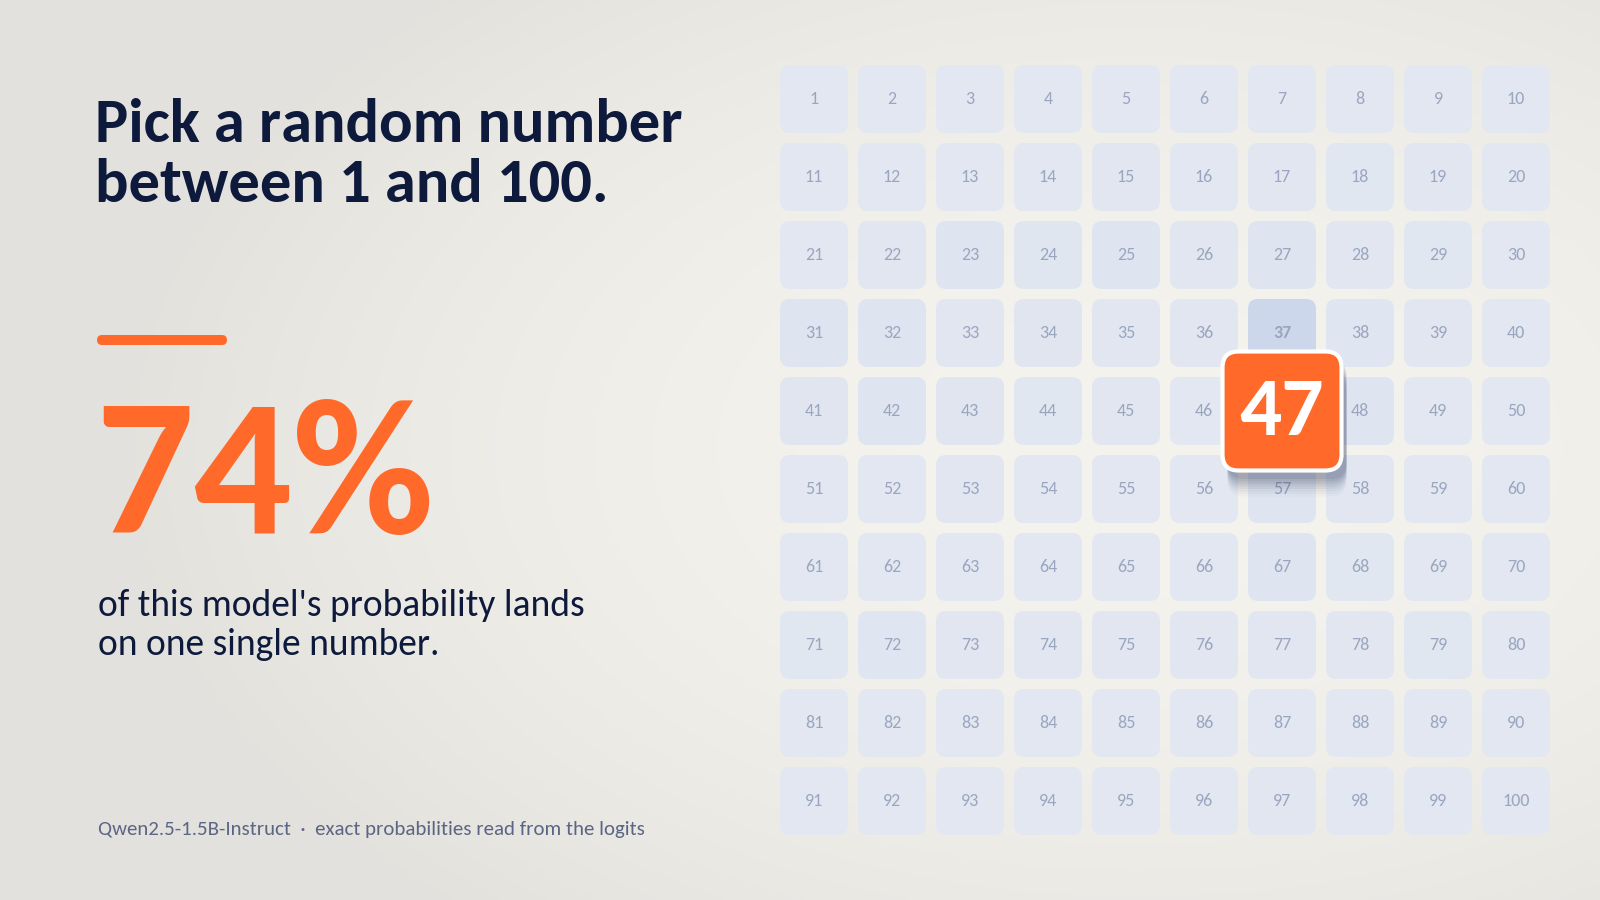
本研究量化了语言模型对‘随机’数选择的预测性,发现虽然基础模型有一些偏差,但经过指令微调的版本显著收窄了输出分布,其中有一个模型需要不到两次猜测就能锁定其最爱数字。
📝 Summary
文章调查了语言模型在收到‘挑一个随机数’提示时生成的数字的随机性。通过测量熵和预期猜测次数,研究揭示出,指令微调模型比其基础版要可预测得多。此外,分析还跟踪了在后训练不同阶段答案分布的变化,显示分布收窄发生在微调的早期阶段。
💡 Main Points
指令微调模型比基础模型显著不随机。
数据表明,指令微调模型(例如 Qwen2.5-1.5B-Instruct)的熵明显降低,预期猜测次数也随之增高,远超其基础版本。这说明微调过程引入了对特定输出的强偏好,使得‘随机’数生成对安全应用来说不可靠。
分布收窄发生在初始微调阶段。
通过分析 OLMo 2 模型在不同检查点的表现,研究发现,熵的最大降幅出现在基础模型到第一个微调版本(SFT)之间。后续阶段(DPO 和 RLVR)并没有显著逆转这一趋势,这暗示初始训练数据或方法是导致多样性降低的主要原因。
提示格式会影响模型的随机性。
实验对比了两种提示格式:原始文本提示和模型的专用对话模板。结果并不一致,对于一些模型,对话模板能提升随机性,而对于其他模型则降低。这表明模型的行为对提示的具体措辞和上下文非常敏感。
💬 Key Quotes
一个公平的选择会产生 6.64 位元,也就是 100 的二对数。把 2 乘方到熵上可以获得一个具体数字:该模型平均来说,相当于在这么多数字中公平选择。
📊 Article Meta
AI Screening: 85
Source: Towards Data Science
Author: Utkarsh Mangal
Category: 人工智能
Language: 英文
Read Time: 16 min
Word Count: 3966
Tags:
AI 与智能应用 , 机器学习 , 模型评测与基准 , 模型训练与推理 , 后训练
看完了,收获满满,期待更多更新。