Owkin K Pro多模态发现:自然语言驱动 PubMed文献+组学数据+可视化全流程
一句话结论
这支演示集中展示 K Pro 的多模态发现能力:数据分析任务全程用自然语言驱动——输入提示词,K Pro 自动调用文献库与组学工具,生成从文献聚合、跨癌种表达分析、单细胞定位、空间转录组到双靶点配对排序的完整结果。核心卖点是”消除编程门槛”:几条直白的提示词,产出带文献引用、带可视化、可直接决策的研究产出。对任何想用 AI 智能体替代数据分析师重复劳动的团队,这是一份完整的能力清单。

从文献到数据:第一步锁定候选适应症
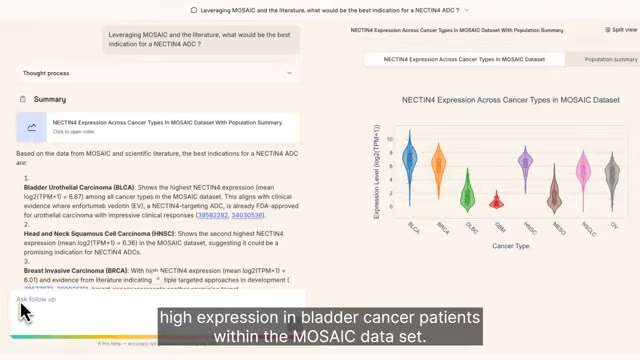
演示任务是给 nectin-4 ADC 选最优适应症。K Pro 先并行检索两路信息:PubMed 生物医学文献和 Owkin 数据网络中的多模态组学数据。两边的结果自动综合成泛癌种表达分析,每条结论都附带来源文献引用。
第一轮输出:膀胱癌是领先的可验证适应症——既有 FDA 批准试验支持,又在 MOSAIC 数据集中表现出高表达。文献证据与自有数据互为印证,两条证据线在同一份分析里自动对比完成。
单细胞层面:靶点在哪种细胞里表达
第二条提示词把分辨率推到单细胞层面:nectin-4 在各种细胞类型中的表达分布,以及它在 MOSAIC 全部适应症间的异质性。结果显示 nectin-4 在膀胱恶性细胞和上皮细胞中高表达——这直接决定了药物的作用人群。

空间转录组:从”有没有”到”在哪里”
第三步用 MOSAIC 的空间转录组数据看 nectin-4 的空间表达及其与肿瘤微环境的交互。在这一位患者的切片上,nectin-4 在恶性区域持续高表达——据此可以判断该患者是 nectin-4 靶向治疗的优秀候选者。空间信息把”表达量”升级成”表达位置+微环境关系”,这正是空间组学技术对精准医疗的贡献。

双靶点配对:AI 排序出最优组合
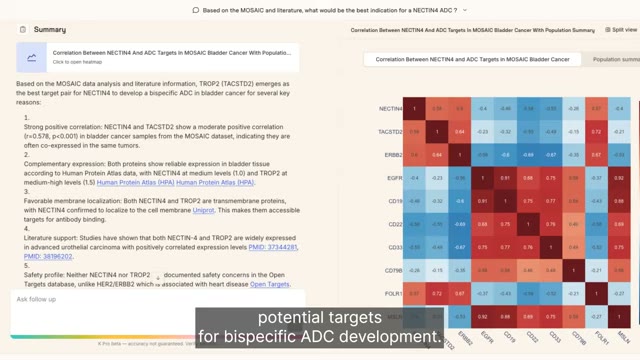
最后一个问题最具工程味:为开发双特异性 ADC,哪些靶点适合与 nectin-4 配对?K Pro 调用 MOSAIC 多模态数据、外部知识库和文献三类数据源,对候选靶点评估排序,输出 TROP-2 为最优配对。演示者总结:K Pro 能把复杂提问高效转化为可执行洞察,通常只需要几条提示词。
编程门槛消失后的分工变化
演示开场一句话点题:这些分析”通常需要生物信息学专业能力”。K Pro 自动生成的可视化(跨癌种表达图、单细胞分布图、空间转录组切片图)正是生信工程师的日常产出。当这类图表可以由自然语言驱动生成,团队分工的重心就从”会跑分析”转向”会问问题、会判断结果可信度”——演示里双数据源交叉验证(文献引用+MOSAIC 数据)就是判断可信度的关键动作,这一步仍然需要人的专业判断。
能力清单的普适价值
抛开制药场景,这条演示定义了一个数据分析智能体的四项核心能力:多源检索与综合(文献+数据库)、逐级下钻(癌种→细胞→空间)、可视化自动生成、候选排序与推荐。任何领域的数据分析团队都可以用这四项能力检验自己的 AI 工具是否完整。
原文信息
- 原视频标题:Conversation with K | Discovery and Multimodal Capabilities
- 频道:Owkin
- 讲者:Owkin 官方演示
- 发布日期:2026-05-18
- 视频时长:约 3 分钟
暂无评论,快来抢沙发~