OpenRouter 服务端联网工具 web_search 与 web_fetch:一次声明全模型通用,四搜索引擎加五抓取引擎含定价
一句话结论

在 OpenRouter 上给模型加联网能力,过去要按各家供应商的私有格式分别配置搜索工具,换模型就得重写一遍。现在两个服务端工具 openrouter:web_search 和 openrouter:web_fetch 统一了这个过程:请求里声明一次,任何支持工具调用的模型都能用;模型自己决定何时搜索、搜什么、搜几次,OpenRouter 在服务端执行并把结果直接返回给模型,客户端零实现。本文按配置方法、搜索与抓取引擎选择、成本控制参数、旧插件迁移展开。
换模型不换工具
每家模型供应商都有自带搜索工具,但结构各不相同:切换模型或供应商,就得重写工具定义、配置和结果解析,而且各家的可用行为不一致——比如严格执行屏蔽域名列表这类能力不一定有保障。
新服务端工具给了一条统一路径:指定一次工具类型,工具定义、调用方式和结果格式在所有支持工具调用的模型上完全一致。如果还想让搜索行为本身也一致,可以指定 Exa 或 Parallel 作为引擎,这样无论请求路由到 GPT-5.5、Claude 还是 Kimi,返回给模型的搜索结果都是同一来源。
最小配置只需在请求体里声明两个工具:
{
  "model": "openai/gpt-5.5",
  "messages": [{ "role": "user", "content": "What happened in tech news today?" }],
  "tools": [
    { "type": "openrouter:web_search" },
    { "type": "openrouter:web_fetch" }
  ]
}
也可以先在聊天室界面点工具图标试用,再按 API 文件接入生产。

Web Search:四种引擎按需选择
搜索工具支持四种引擎:
| 引擎 | 工作方式 | 定价 |
|---|---|---|
| Auto(默认) | 供应商有原生搜索就用原生,否则用 Exa | 视情况 |
| Native | 供应商自带搜索(OpenAI、Anthropic、Google、xAI、Perplexity) | 按供应商计费 |
| Exa | 搜索转给 Exa,从 OpenRouter 余额扣费 | 0.005 美元/次,含最多 10 条结果,超出每条 0.001 美元 |
| Parallel | 搜索转给 Parallel,从 OpenRouter 余额扣费 | 0.005 美元/次,含最多 10 条结果,超出每条 0.001 美元 |
各引擎强项不同:原生搜索与供应商模型集成最紧;Exa 和 Parallel 支持可配置的结果上下文尺寸(search_context_size),原生引擎会忽略这个参数。多数引擎支持域名过滤(allowed_domains、excluded_domains)。
API 级配置示例:
{
  "type": "openrouter:web_search",
  "parameters": {
    "engine": "exa",
    "max_results": 5,
    "search_context_size": "high",
    "allowed_domains": ["arxiv.org", "nature.com"]
  }
}
智能体循环里的并行搜索
模型需要跨来源对比信息时,可以在单个请求里发起多次搜索。比如”比较三大云 GPU 供应商的定价”这类问题,模型可能先分头搜三家,各自用不同查询词,最后汇总成答案。
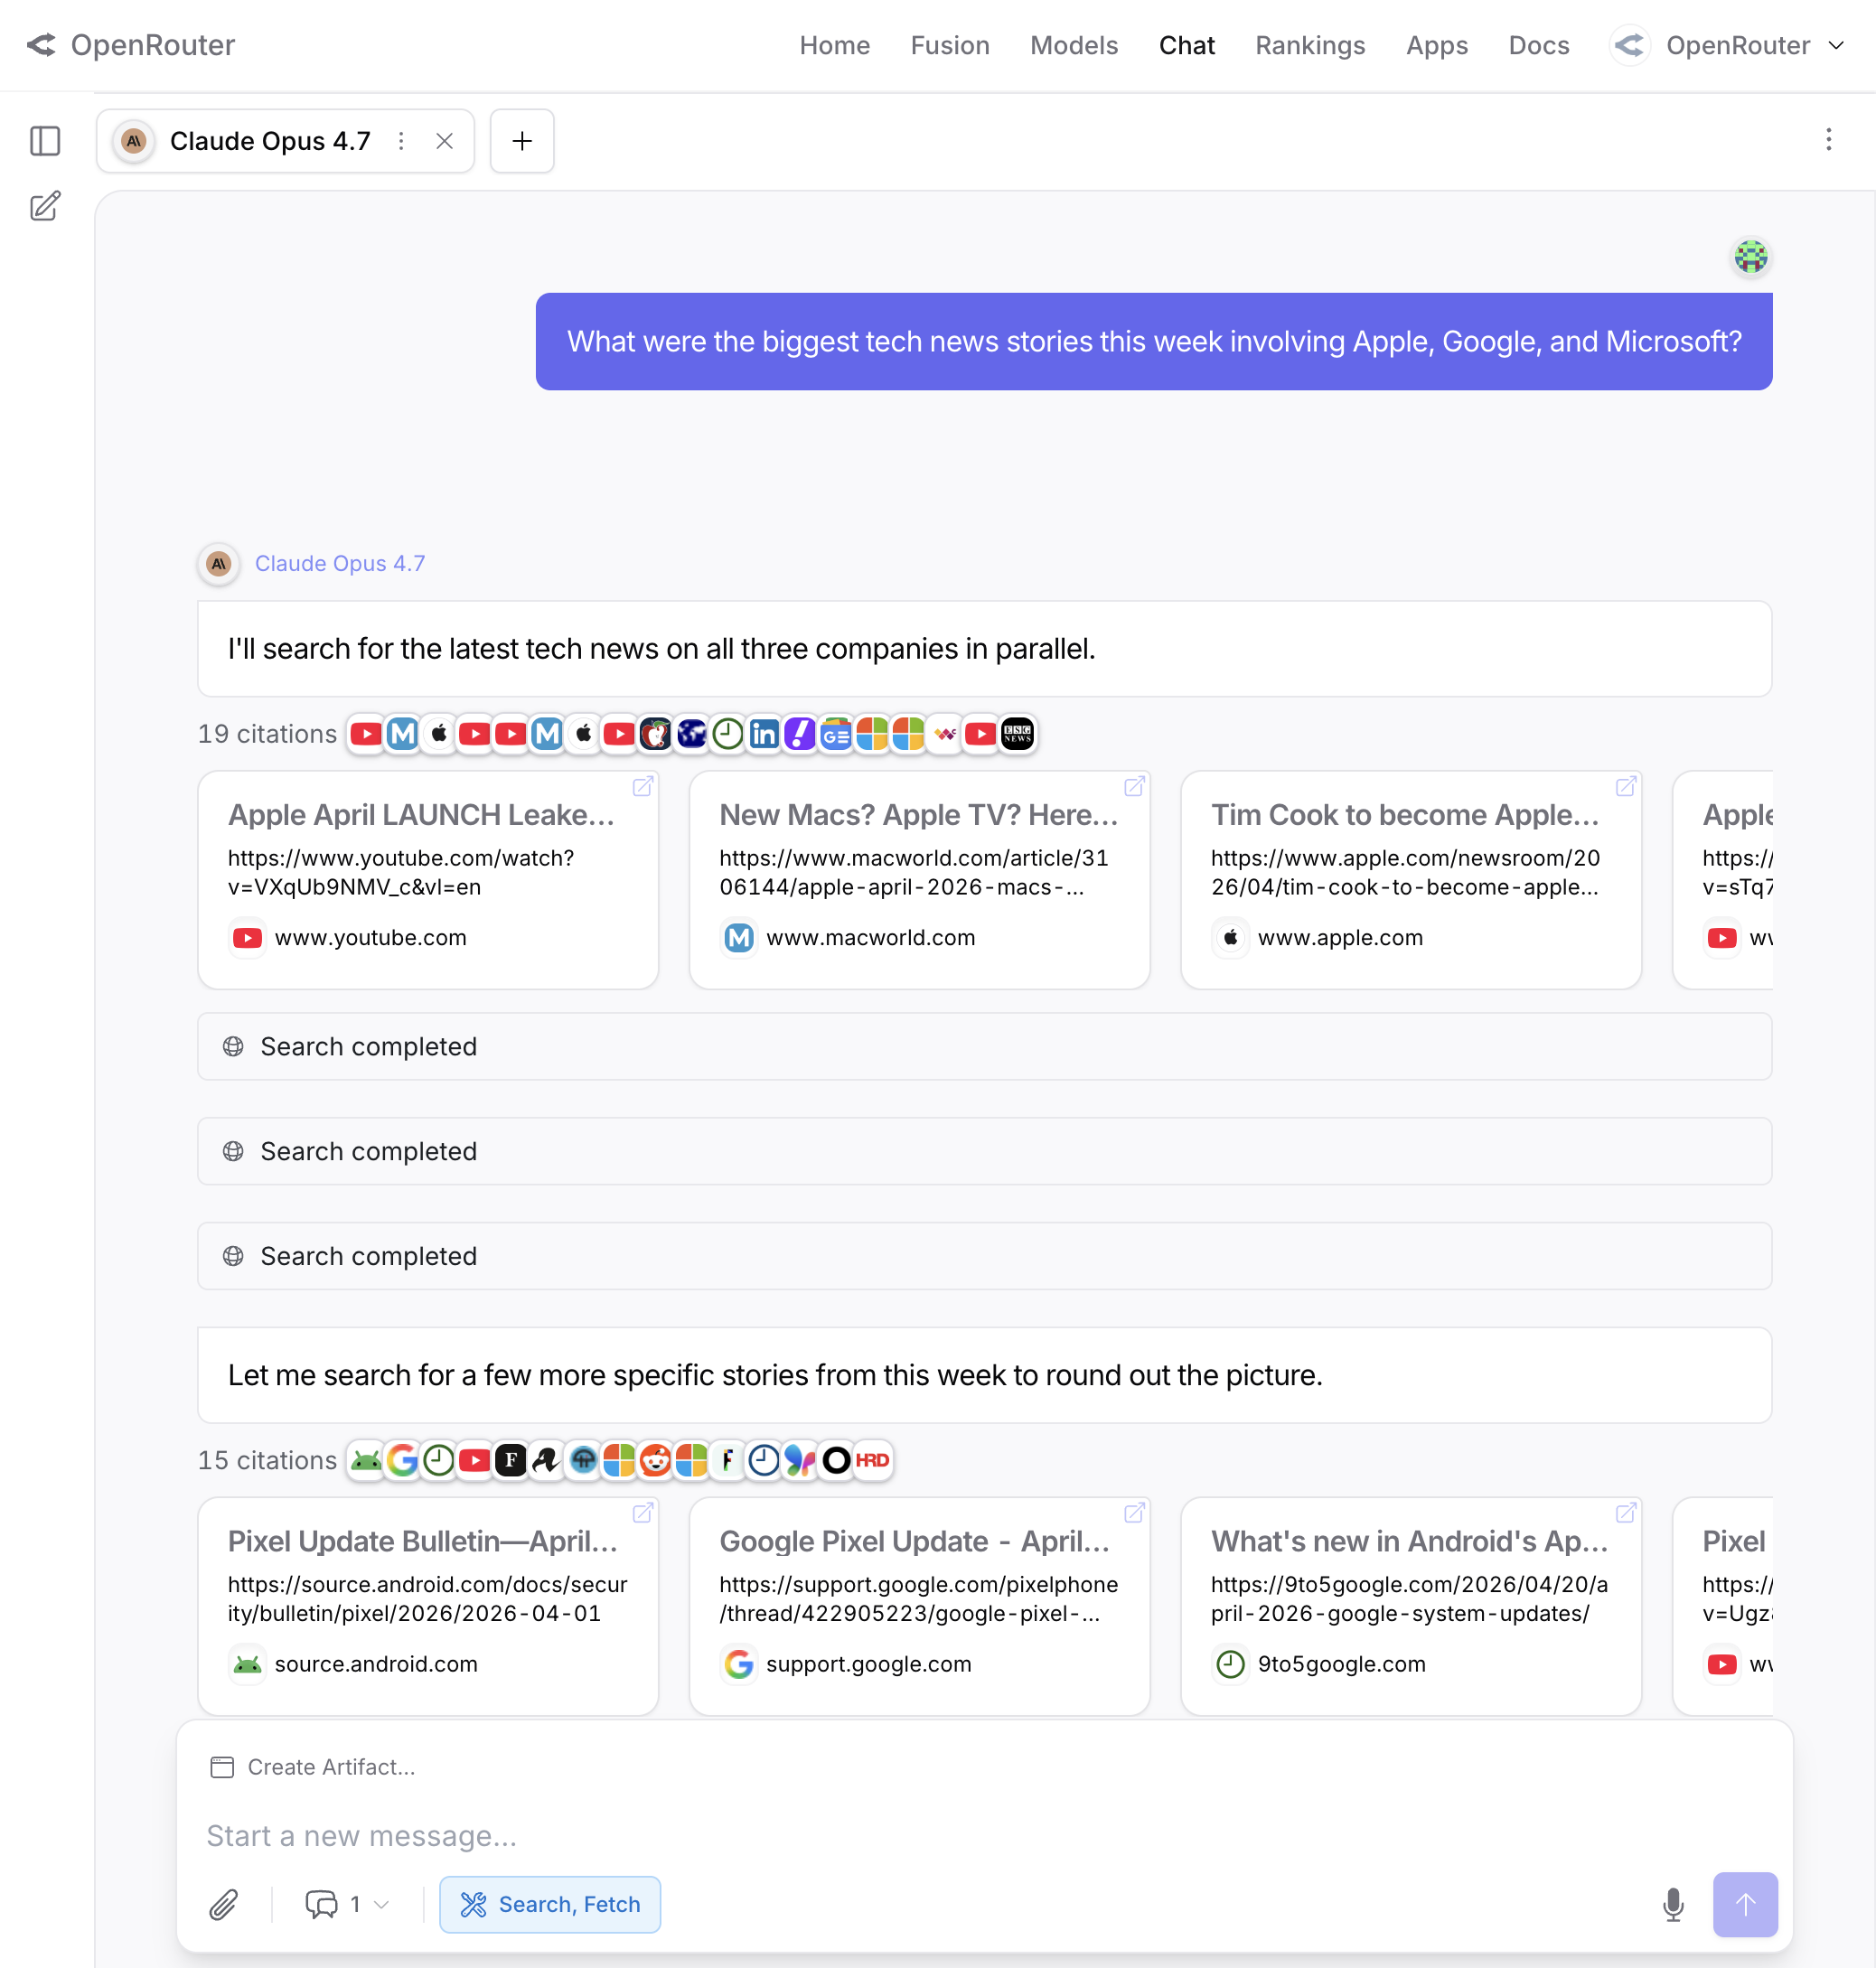
用 max_total_results 给整次请求的累计结果数封顶,成本和上下文占用就可控:
{
  "type": "openrouter:web_search",
  "parameters": {
    "max_results": 5,
    "max_total_results": 15
  }
}
达到上限后,模型会收到”已达限额”的提示,不再继续发起搜索。
Web Fetch:五种引擎抓取全文
抓取工具让模型从任意 URL 取回完整页面内容,支持五种引擎:
| 引擎 | 工作方式 | 定价 |
|---|---|---|
| Auto(默认) | 供应商支持就用原生,否则用 Exa | 视情况 |
| Native | 供应商自带抓取 | 按供应商计费 |
| OpenRouter | OpenRouter 直接 HTTP 抓取 | 免费 |
| Exa | 内容提取并输出干净 Markdown | 0.001 美元/次 |
| Parallel | 通过 Parallel 的 extract API 做高质量内容提取 | 0.001 美元/次 |
指定 Exa、Parallel 或 OpenRouter 作为引擎,能保证抓取行为在所有模型上一致,包括用 allowed_domains 和 blocked_domains 限制模型可抓取的 URL 范围。原生供应商能力参差不齐,需要这些参数被严格遵守时,选这三种之一。
用 max_content_tokens 限制模型收到的内容量,防止大页面撑爆上下文窗口:
{
  "type": "openrouter:web_fetch",
  "parameters": {
    "engine": "openrouter",
    "max_content_tokens": 50000,
    "allowed_domains": ["docs.example.com", "api.example.com"],
    "blocked_domains": ["internal.example.com"]
  }
}
从旧搜索插件迁移
过去模型只能通过 web 搜索插件联网,每次请求固定执行一次搜索,模型自己决定不了搜索时机和关键词。
迁移只需把请求体里的插件换成工具:
插件写法(旧):
"plugins": [{ "id": "web" }]
服务端工具写法(新):
"tools": [{ "type": "openrouter:web_search" }]
换成服务端工具后,搜索时机和次数都由模型决定。唯一限制:服务端工具要求模型支持工具调用,当前模型不支持的话要么换成支持的模型,要么继续用插件。官方提供了带完整细节的迁移指南。
接入自己的智能体项目时,建议先用免费的 OpenRouter 引擎测试 web_fetch 抓取效果,再按需选择 Exa 或 Parallel 换取干净 Markdown 输出;搜索侧配置好 max_total_results 上限后再上生产,模型联网的成本就从不可控变成可预估。
原文信息
- 作者:David Bai(OpenRouter)
- 发布时间:2026-05-07
- 原文标题:Consistent Web Search and Fetch Across Every Model
原文地址:
暂无评论,快来抢沙发~