NVIDIA 发布 Nemotron 3 Diarization:一个可实时追踪 8 个说话人的 100M 参数开源权重模型
📌 One-Sentence Summary
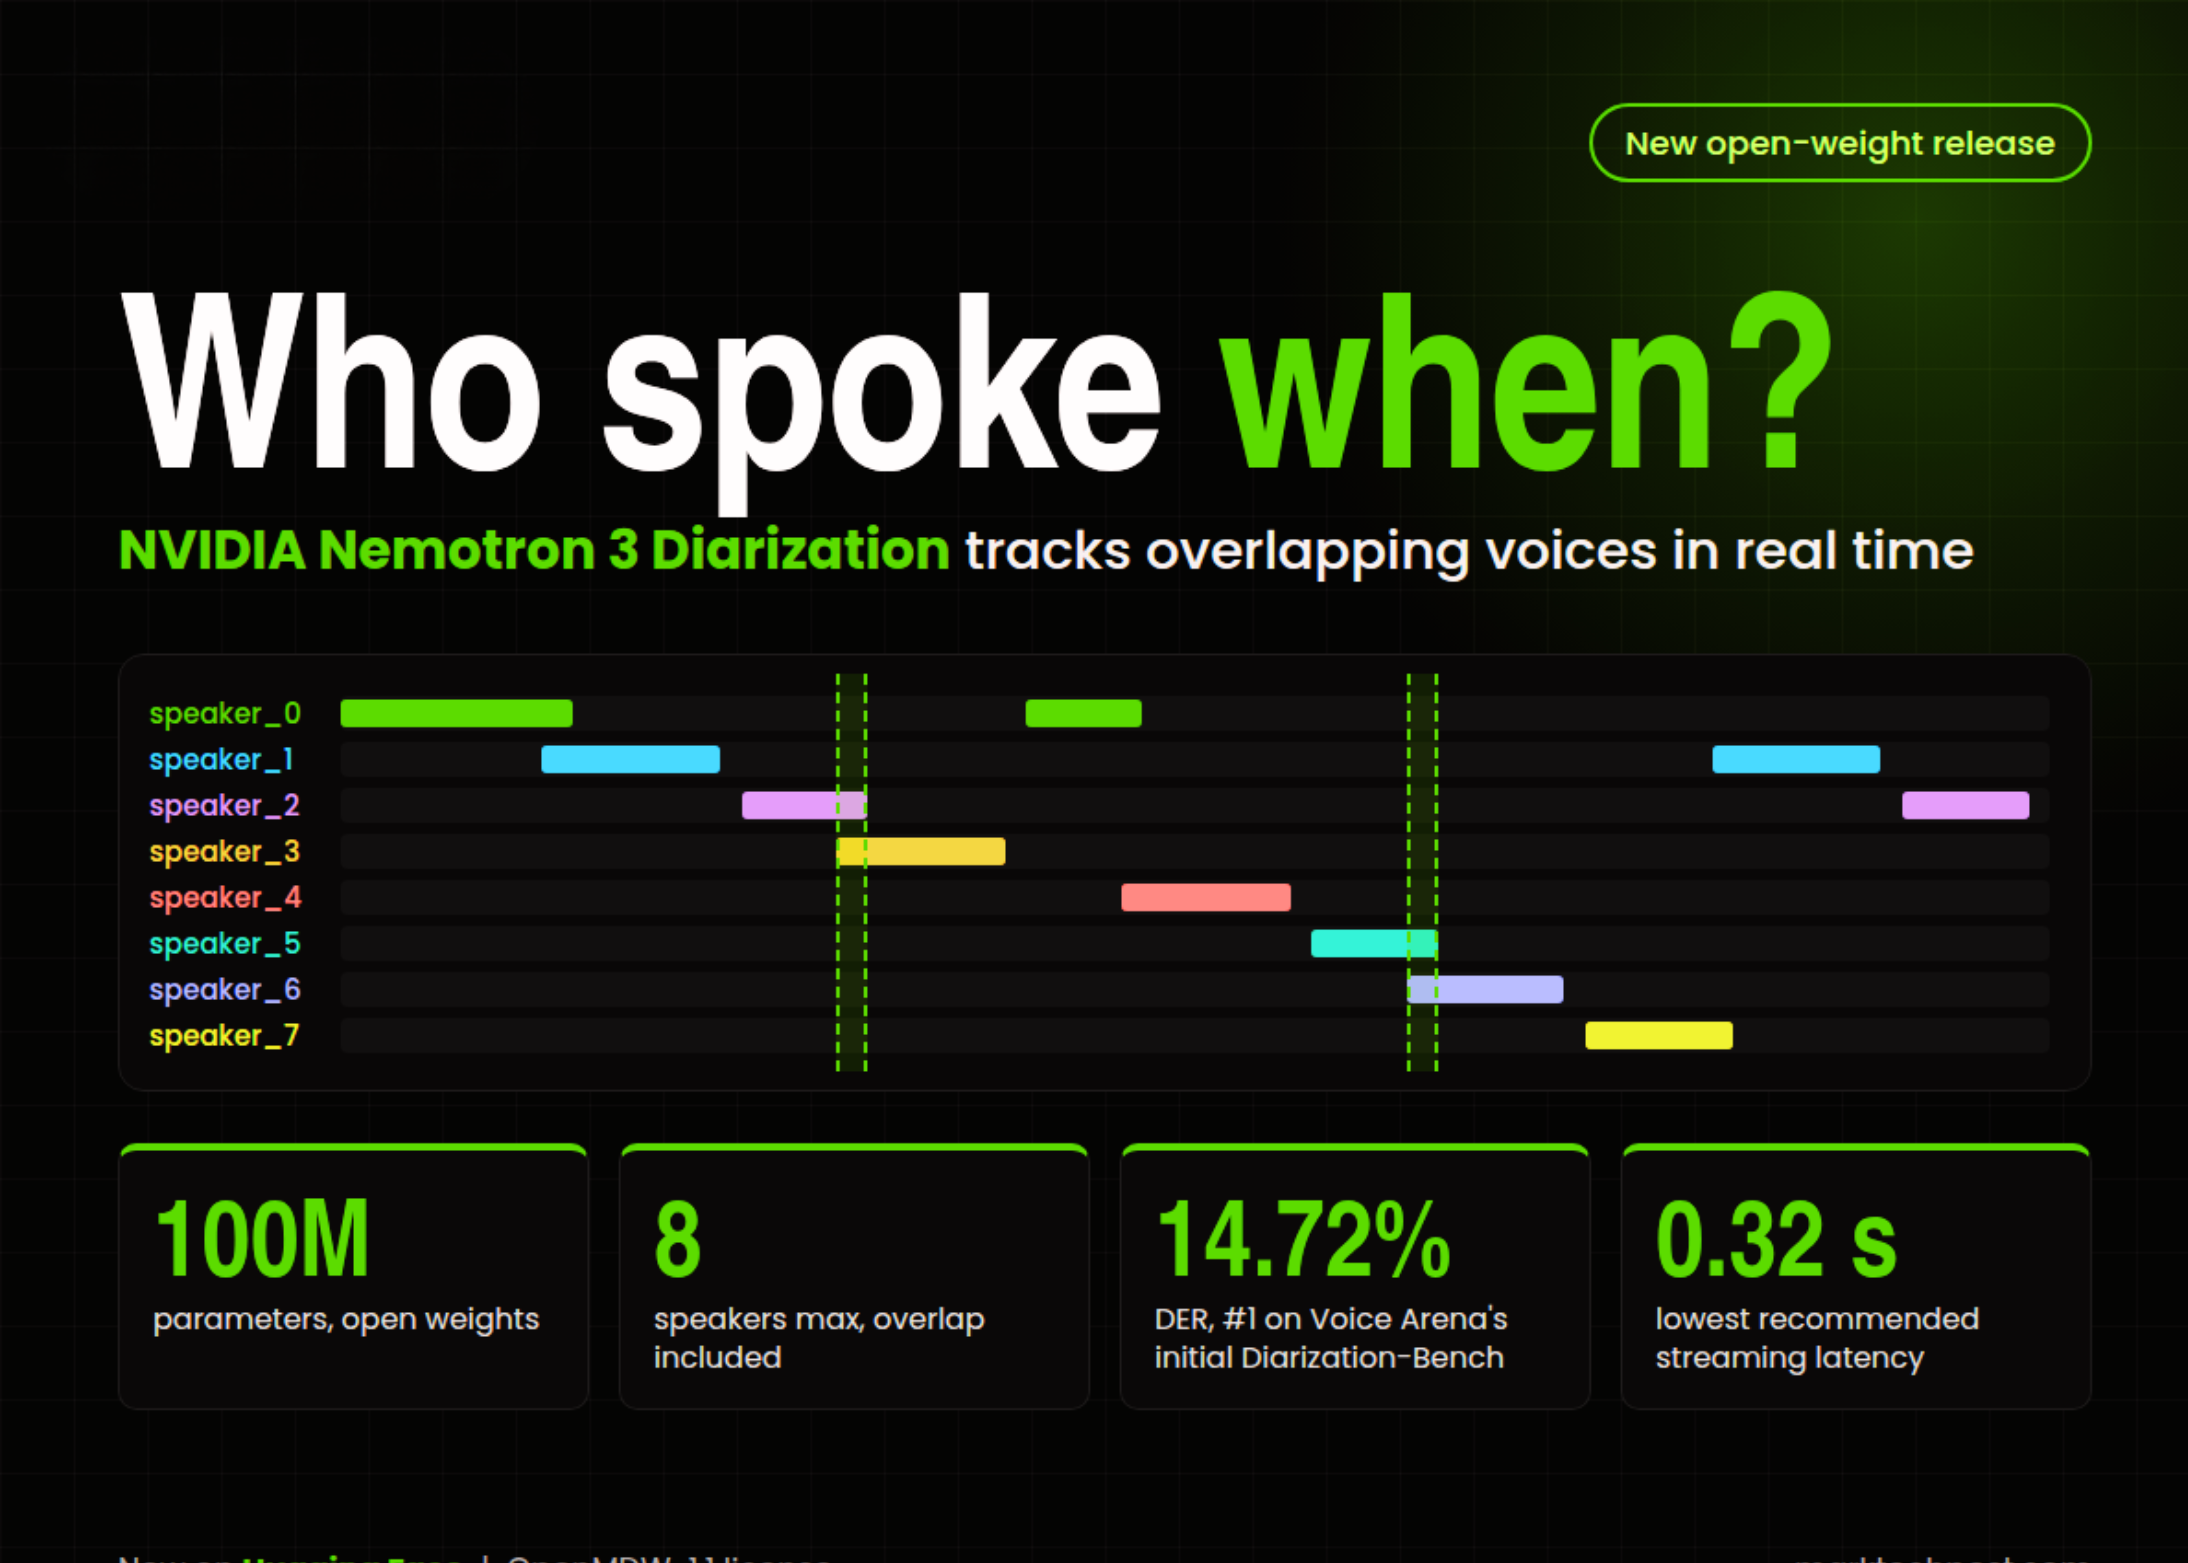
NVIDIA 发布了 Nemotron 3 Diarization,这是一个拥有 100M 参数的开源权重模型,能够在离线和实时流模式下追踪最多 8 个重叠的说话人。
📝 Summary
NVIDIA 推出了 Nemotron 3 Diarization,这是一个旨在解决对话中「谁在何时说话」问题的开源权重模型。该 100M 参数模型在之前的 Streaming Sortformer 基础上进行了改进,将说话人容量翻倍至 8 人,并能处理重叠语音。它采用了带有 RoPE 的 31 层 Transformer 编码器,并提供四种延迟运行点,范围从 30.4s(离线)到 0.32s(超低延迟)。该模型在 Voice Arena 的 Diarization-Bench 中排名第一,在 NVIDIA GPU 上表现出显著的 DER 降低和高吞吐量,基于 OpenMDW License 1.1 协议,使其非常适合部署在会议工具和语音智能体中。
💡 Main Points
扩展的说话人追踪与重叠处理
与之前的 Streaming Sortformer 相比,该模型将说话人上限从 4 人增加到 8 人,并使用 [T, 8] 张量输出,允许在声音重叠时多个通道同时激活。
适用于多种用例的灵活延迟配置
它提供四个运行点(离线、低、极低和超低延迟),允许开发者在说话人日志错误率(DER)和缓冲区延迟(从 30.4s 降低至 0.32s)之间进行权衡。
在 NVIDIA 硬件上的高性能与高效率
该模型在 Voice Arena 的 Diarization-Bench 中以 14.72% 的 DER 排名第一;在 RTX PRO 5000 GPU 上使用 torch.compile 时,可实现极高的吞吐量(高达 15,113× RTFx)。
鲁棒的训练数据策略
训练采用了 10,000 小时的真实对话和超过 82,000 小时的 21 种语言模拟多说话人混合数据,包括来自 David AI 的授权数据以降低 DER。
💬 Key Quotes
「这个 100M 参数的模型可以追踪最多 8 个说话人,包括声音重叠的情况。」
「同一个检查点可以同时处理离线录音和实时流。」
「在 Voice Arena 最初的 Diarization-Bench 结果中,该模型在 12 个系统和 17 种配置中排名第一。」
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1018
Tags:
AI 与智能应用 , AI 语音 , NVIDIA , LLM
这篇文章分析得很透彻,收藏了!
不错不错,已加入书签。
楼主辛苦了,内容很有参考价值。