NVIDIA 发布 Nemotron 3.5 Bolt E4B 4GB:面向本地语音智能体、游戏角色与机器人的开源小语言模型
📌 One-Sentence Summary
NVIDIA 推出 Nemotron 3.5 Bolt E4B 4GB,这是一款基于 Gemma 4 E4B 微调的轻量高性能语言模型,面向本地对话智能体,具备多轮工具调用能力,并可在 RTX 与 Jetson 硬件上高效运行。
📝 Summary
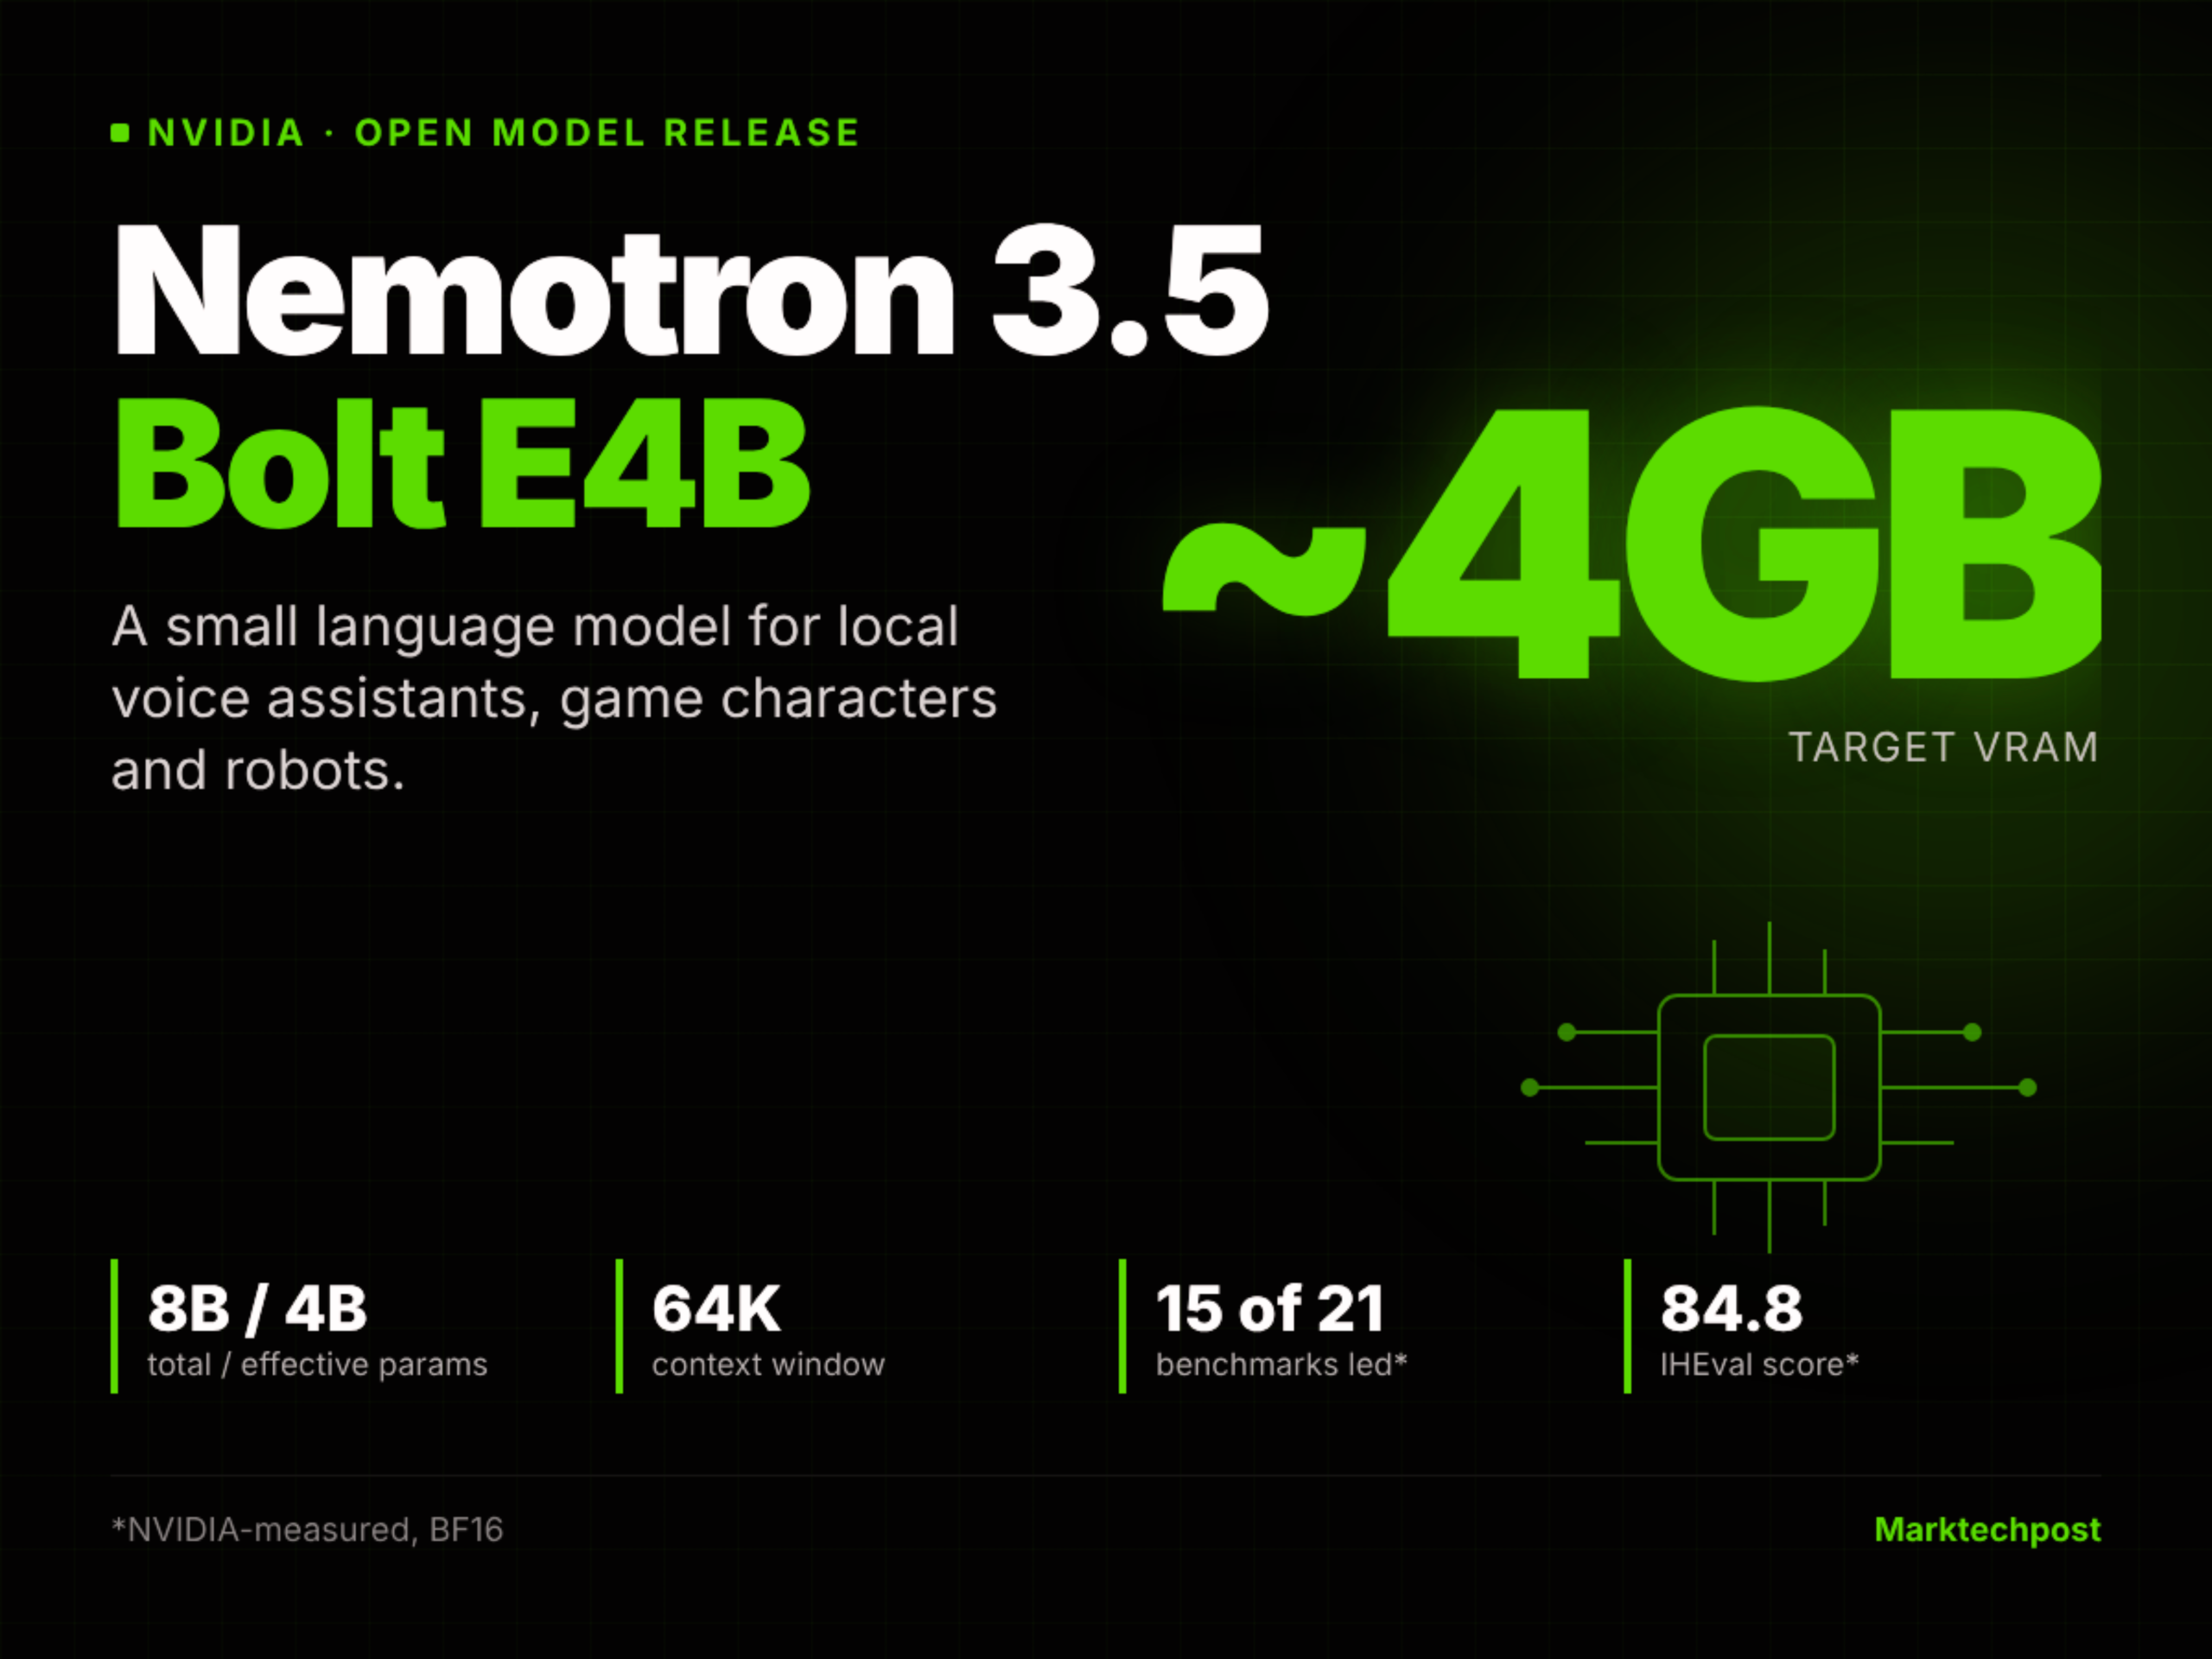
Nemotron 3.5 Bolt E4B 是 NVIDIA 推出的一款专用小语言模型,针对语音助手、游戏 NPC 和机器人交互界面的本地部署进行了优化。该模型基于 Gemma 4 E4B 构建,通过强化学习训练来增强工具调用能力,同时保持对话流畅度。模型支持 64K 上下文、异步工具执行和可配置推理,并提供了量化版本(Q4_K_M),可容纳于 4GB 显存之内,适用于边缘计算场景。
💡 Main Points
专为本地智能体打造
Nemotron 3.5 Bolt E4B 专门针对语音助手、游戏角色等本地低延迟应用进行了调优。其紧凑的体积(目标 4GB 显存)和优化的推理速度,使其适合 RTX GPU 和 Jetson 开发板等边缘设备。
仅使用强化学习
与许多将监督学习与强化学习相结合的微调方法不同,NVIDIA 仅通过强化学习训练 Bolt。这一策略在保留基础模型对话质量的同时,显著提升了其理解和执行工具调用的能力。
多轮工具调用
该模型在多轮交互中表现出色,能够记住上下文并执行复杂指令。它支持异步工具调用,并提供了处理长时间运行操作的指引,使其在真实智能体交互中表现稳健。
基准测试表现强劲
在 NVIDIA 的内部基准测试中,Bolt 在 21 个类别中的 15 个类别上优于 Gemma 4 E4B 及其他小模型,尤其在指令遵循(IHEval)和多挑战任务方面表现突出。在使用推测解码时,它还展现出相较基础模型的显著速度提升。
💬 Key Quotes
该模型基于 Google 的 Gemma 4 E4B,仅通过强化学习进行后训练。对开发者而言,这意味着在约 4GB 显存中实现智能体行为,从而为语音和视觉模型留出空间。
NVIDIA 完全跳过了监督微调。根据研究报告,SFT 改善了工具调用,但损害了 Gemma 的对话质量和简洁性。
在 NVIDIA 自有的测试框架中,Bolt 在 21 项智能体基准测试中领先 15 项。IHEval 84.8 是最亮眼的表现;Tau2-Bench 55.1 则是薄弱环节。
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1025
Tags:
AI 与智能应用 , 强化学习 , 模型训练与推理 , 性能优化 , 本地与端侧 AI
路过
收藏了,以后慢慢研究。
支持作者,持续关注中。
看完了,收获满满,期待更多更新。
有没有更详细的教程,期待后续。
点赞,必须点赞
看标题就点进来了,内容果然没让人失望。
作者写得真不错,学到了不少。
很有价值的分享,感谢整理。
楼主辛苦了,内容很有参考价值。
内容翔实,正好需要,先收藏再看。
楼主辛苦了,内容很有参考价值。