LLM 推理自动扩缩容实操:选对指标、调好窗口、算清冷启动账
一句话结论
LLM 服务的自动扩缩容不能照搬无状态 Web 服务那套:CPU 式指标会撒谎、冷启动按分钟计。用并发压力(inflight_requests)当默认信号,扩容窗口调短、缩容窗口调长,并在按下自动停止前先算清冷启动这笔账。
为什么传统自动扩缩容在 LLM 推理上失灵
专用推理按副本分钟计费,容量规划是两种失败模式的平衡:过量配置让 GPU 长期跑 15% 利用率干等峰值,几乎不划算;欠配置则是 LLM 服务非线性劣化——副本到并发上限不是”变慢一点”,而是开始排队,首 token 延迟(TTFT)能从 200ms 直接炸到 15 秒。
“加自动扩缩容”对无状态服务基本成立,但 LLM 服务打破它的两个前提:
- CPU 式指标谎报负载。 GPU 可以读出 60% 利用率,而引擎的请求队列已经堆积——利用率衡量的是算术强度,不是压力。按错误信号扩缩容,系统就在响应一个不描述真实问题的数字。
- 冷启动要几分钟。 新副本要先落位 GPU 节点、拉几十 GB 权重、载入显存、预热。流量尖峰来了再扩容已经来不及,所以好的自动扩缩器必须在前导信号上提前行动。
工作原理:控制循环与两个窗口
每个部署携带一份自动扩缩策略:副本上下界、一个或多个带目标的扩缩指标、计时窗口。控制循环是:观测指标 → 期望副本数(ceil(N × 观测值/目标值))→ 计时窗口阻尼 → 夹到边界内 → GPU 落位。

核心循环是比例式的:目标每副本 8 个在途请求、观测到 16 个,系统就想要两倍副本(只要在边界内)。两个计时窗口用来防振荡:
scale_up_window:压力持续多久才加副本。保持短——误扩容只损失几分钟副本费用,漏扩容损失的是用户可感的延迟。scale_down_window(默认 5 分钟):平静多久才减副本。保持比流量自然节奏更长——误缩容的代价是下一个峰值到来时恰好吃一次冷启动。
这种”上急下缓”的不对称权衡是调参核心:扩容窗口的错花的是美元,缩容窗口的错花的是延迟加美元(因为马上又得扩回去,来回都付冷启动)。

一条 PATCH 就能设置:
tg beta endpoints update "$DEPLOYMENT_ID" \
  --min-replicas 1 --max-replicas 6 \
  --scale-up-window 60s --scale-down-window 300s \
  --scaling-metric ttft --scaling-target 500 --scaling-percentile p95
三个边界规则要记牢:min == max 等于固定大小、扩缩容实际关闭;两者都设 0 是显式停止(状态 STOPPED、计费停止),可以用来暂停开发端点;只设边界不设指标时,平台默认用 inflight_requests 目标 8。
八个指标怎么选

按要保护什么分三类:
并发驱动(inflight_requests)是安全默认。 在途请求数是前导指标:需求超过服务能力时它先涨,延迟才可见地恶化。它不需要流式传输也不需要选分位,且直接对应引擎批处理请求的方式。目标 8 表示”每个副本同时处理约 8 个请求”——短提示、好批处理的聊天负载可以调高,prefill 更久的编程智能体长上下文流量应该调低。
SLO 驱动(ttft、e2e_latency)按承诺扩容。 如果你对用户的契约是”首 token 一秒内”,用 ttft p95 扩容正中靶心。但延迟是滞后信号——p95 破线时用户已经察觉,所以延迟指标通常要搭配诚实的 min_replicas 余量。注意 ttft、decoding_speed、throughput_per_replica 只在流式路径上产生数据:客户端不流式就别基于它们建策略。
效率驱动(gpu_utilization、token_utilization)成本优先。 保持副本忙碌、只在集群真正饱和时加容量。但利用率接近 100% 不给到达突发留余量,选它就要盯紧 p95 监控。
| 指标 | 衡量 | 适用场景 |
|---|---|---|
| inflight_requests | 每副本并发数 | 默认。稳健、前导、引擎无关 |
| ttft | 首 token 时间 | 对响应速度有延迟 SLO |
| e2e_latency | 完整请求延迟 | 对总完成时间有 SLO |
| gpu_utilization | GPU 忙碌百分比 | 成本优先、容忍延迟波动 |
| token_utilization | token 容量占用 | 接近引擎极限的批量/吞吐负载 |
| throughput_per_replica | 每副本 token/s | 持续生成型流水线 |
| decoding_speed | 单请求 token/s | 守护单用户生成速度 |
| cache_hit_rate | 前缀缓存命中率 | 缓存密集型服务模式 |
没有自动唤醒的缩容到零与冷启动预算
平台没有”缩到零后自动唤醒”:min_replicas: 0 只在与 max_replicas: 0 同时设置时合法,含义是显式停止。唤醒需要显式动作,打到停止部署上的请求返回错误而不是触发启动——开发/预发端点要按”自动停止+显式重启窗口”规划。
冷启动预算分四阶段:GPU 落位 → 权重下载 → 引擎加载 → 预热,事件流里每阶段都有时间戳。1×H100 暖集群上的实测:
| 场景 | 实测 |
|---|---|
| 目录基础模型(Qwen3.5-9B),创建 → 副本 READY | 86 秒(拉镜像约 30s → 启动约 30s → 就绪) |
| 自定义微调,全新 18GB 权重,创建 → READY | 145 秒 |
| 副本 READY → 经路由服务出首个 token | +26–40 秒 |
| 扩容 1→2 副本 | 约 2.5 分钟 |
| 从 STOPPED 重启(权重已在平台侧) | 约 1–2 分钟 |
这些窗口以分钟计,意味着自动停止只在两次使用之间的间隔远长于重启时间、且空闲后第一个用户愿意容忍显式启动(或先错后重试的流程)时才划算。开发和预发端点可以接受这个权衡;任何有 p95 SLO 或无人值守调用方的服务,通常保持 min_replicas: 1。
边界情况
尖峰比冷启动快怎么办? 请求在现有副本上排队(在途请求与引擎队列深度上升),延迟先以 TTFT 恶化、随后是错误/超时风险,同时新副本还在起。如果流量能在 90 秒内涨 10 倍而冷启动要 4 分钟,仅有的防线是 min_replicas 余量或保持富余容量的高目标策略——这本质是容量形状问题,最好在上线前回答。
扩缩容会打架发布吗? 不会。发布(rollout)进行中,平台把两边部署的扩缩边界钉住,否则发布中的副本数会被中途缩容决定撤销。发布完成或中止后边界自动恢复。
扩缩容与流量切分如何互动? 流量切分权重按”就绪副本”计(容量 = 权重 × 就绪副本),扩容的部署自动按比例吸收更多流量,无需改路由。
副本数像锯齿怎么办? 典型症状是缩容窗口短于流量自然节奏:突发流量 + 1 分钟缩容窗口 = 每个波谷缩一次、每个波峰冷启动一次。把 scale_down_window 加宽到锯齿变平,用少量副本分钟换掉反复冷启动。
同一负载三种策略对照实验
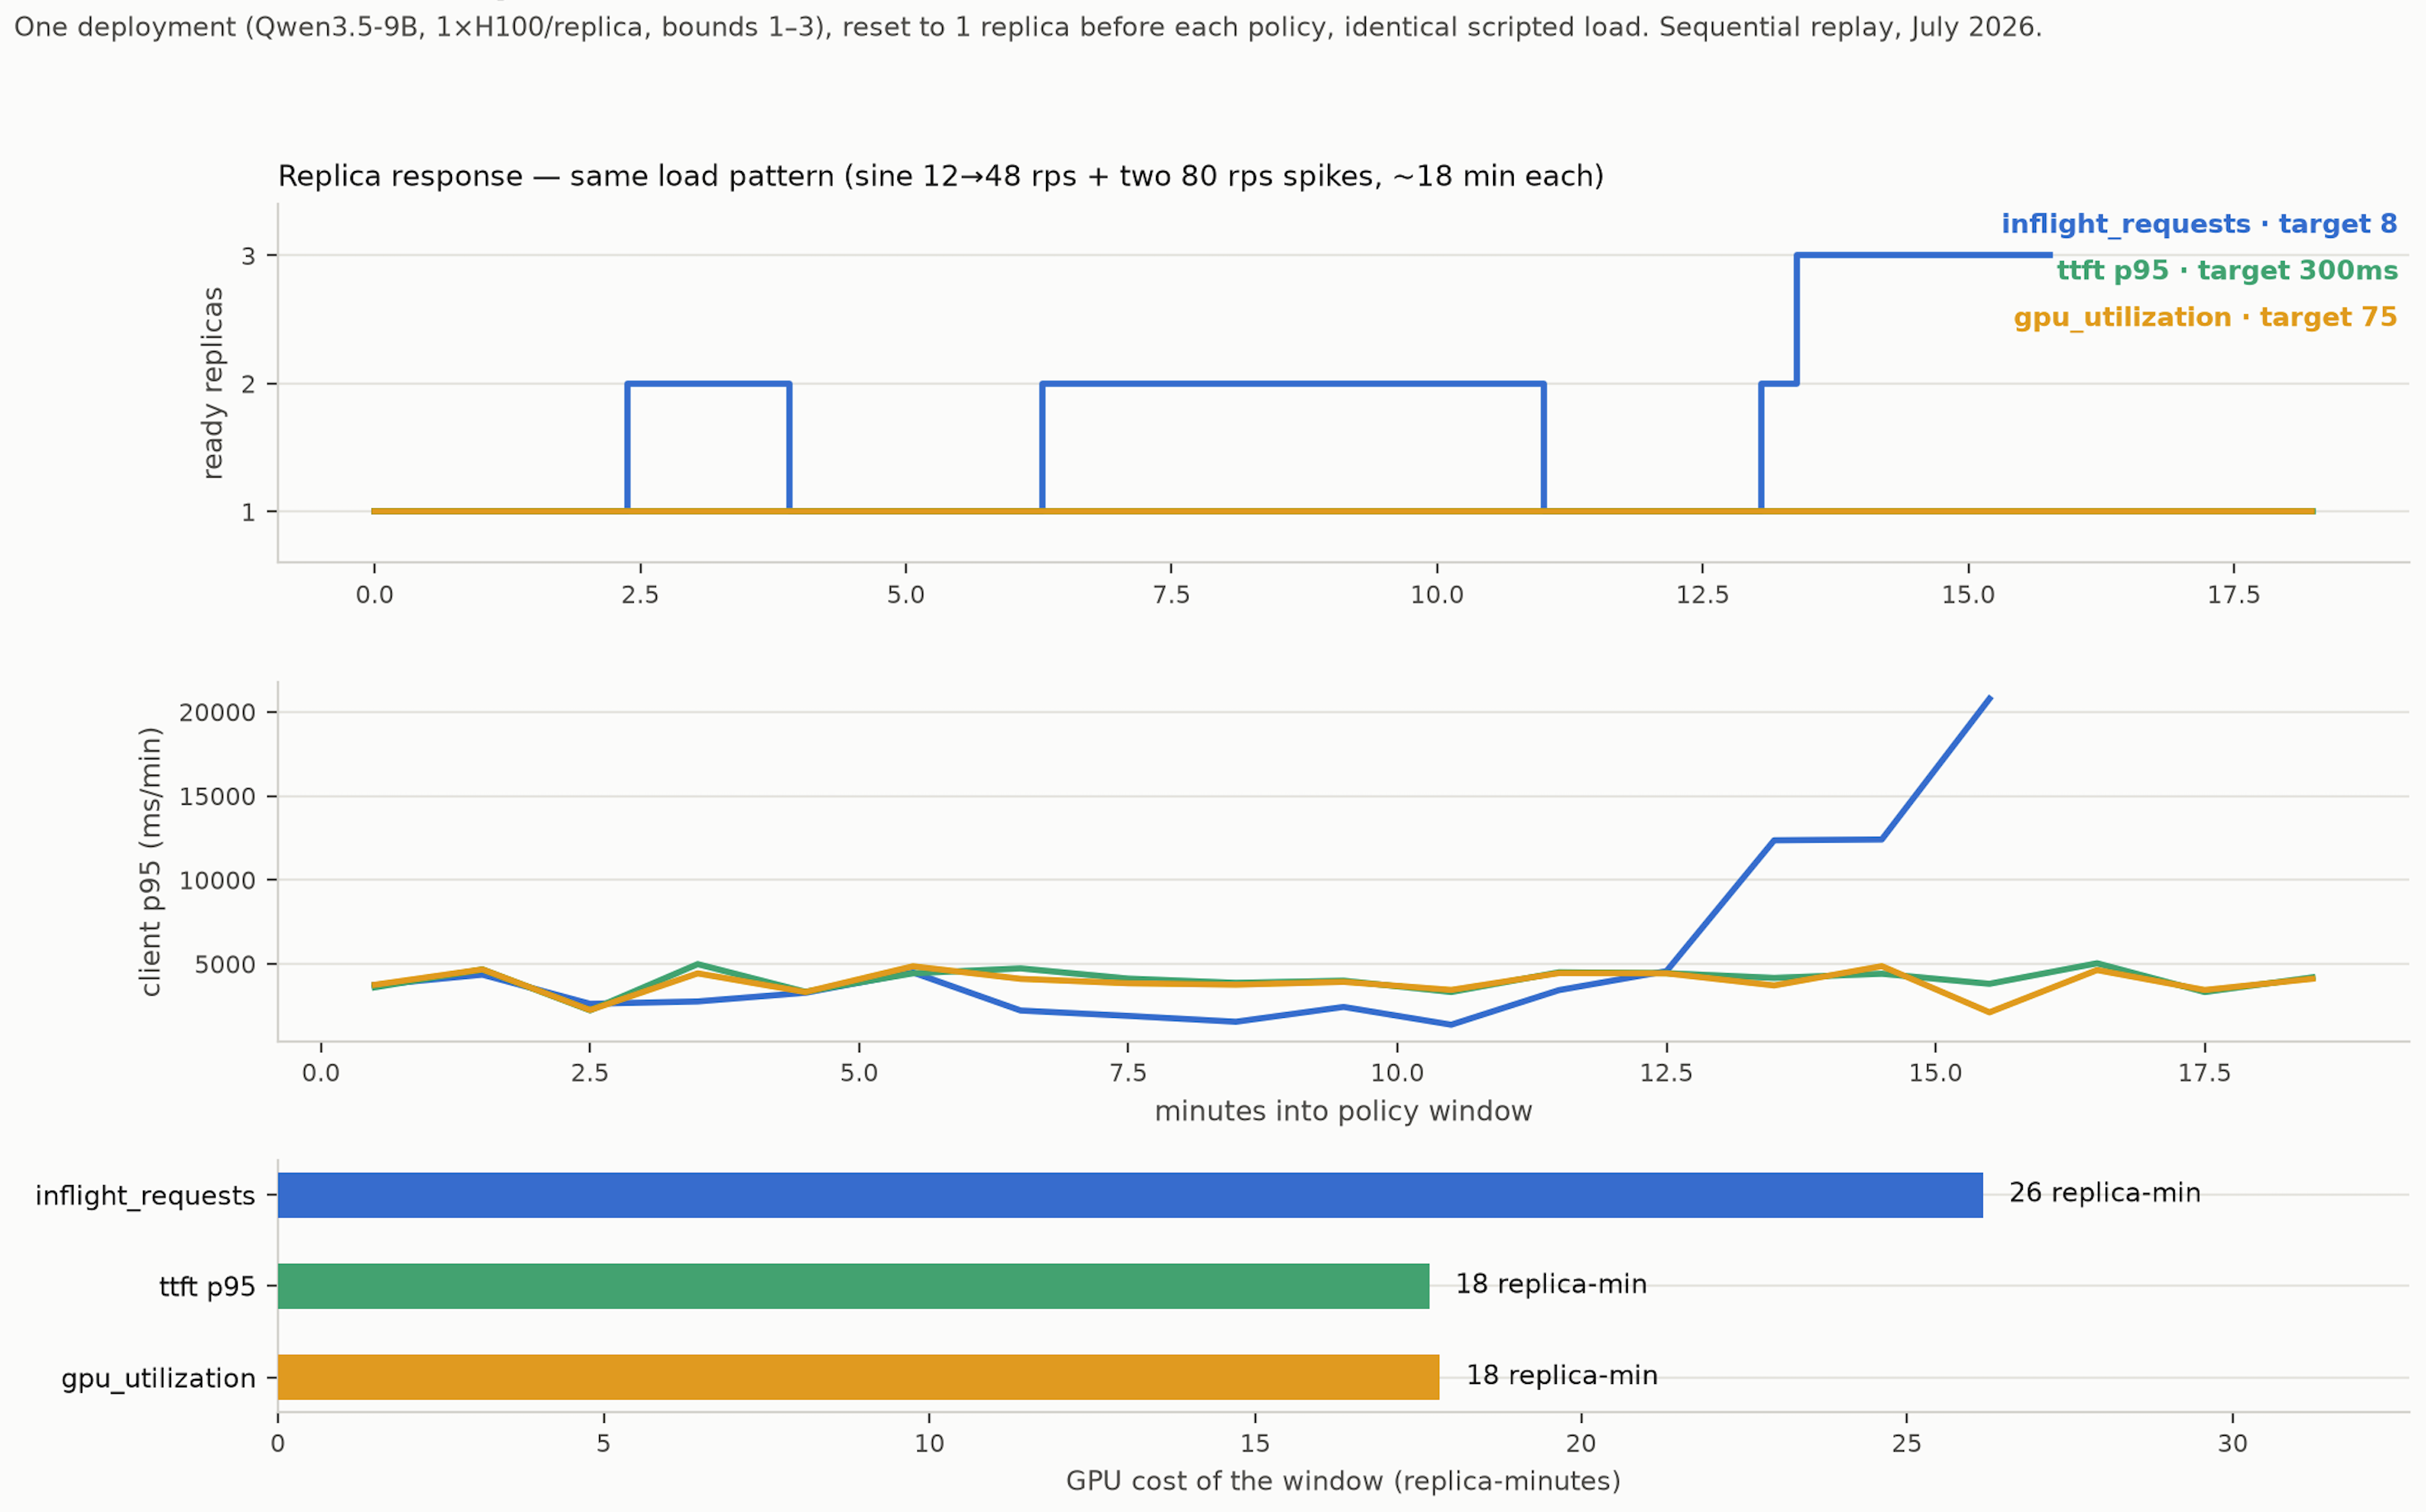
在 Qwen3.5-9B 部署上(每副本 1×H100,边界 1–3),每轮前重置为恰好 1 副本,同一段脚本负载重放三次:约 12–48 RPS 正弦波加两个 80 RPS 尖峰。三种策略分别是 inflight_requests 目标 8、ttft p95 目标 300ms、gpu_utilization 目标 75%。
| 策略 | 扩了吗 | 副本分钟 | 请求数(错误) | 实际发生了什么 |
|---|---|---|---|---|
| inflight_requests (8) | 1→2→3 | 26 | 40.6k(536) | 对每个波都有反应;多出的容量明显压低了中段 p95 |
| ttft p95 (300ms) | 从未 | 18 | 46.4k(6) | 引擎侧 TTFT 全程低于目标;未见扩容 |
| gpu_utilization (75%) | 从未 | 18 | 46.5k(2) | 利用率从未越过 75%;未见扩容 |
三条教训:
- 只有并发信号触发了扩容。 客户端 p95 在此负载下跑到 3–5 秒、明显饱和,但
ttft策略从未扩容——引擎的持续批处理把队列压力吸收进了总延迟而非首 token 延迟;gpu_utilization也没扩,因为短促突发请求让 GPU 到不了 75% 的线。两个策略读着健康信号,系统实际已经饱和。直接反映队列压力的inflight_requests是唯一看到问题的,这就是它是默认值的原因。 - 容量兑现承诺。 在途策略保持 2 副本的时间段(约第 6–11 分钟),同负载下它的 p95 明显低于单副本策略。
- 选策略前先知道副本的饱和点。 一个副本在 12–48 RPS 下以 3–5 秒 p95 撑住没倒,但如果你有 500ms SLO,这就是不可行配置。
上手路径
- 设真实边界(
min= 基础负载所需,max= 预算容忍上限),用默认inflight_requests目标 8。 - 在指标 API 里看一周真实流量:副本数、队列压力、p95。
- 然后才调:延迟 SLO → 加
ttft策略(需流式);成本压力 → 试利用率指标并诚实监控 p95;出现锯齿 → 加宽缩容窗口。
原文信息
- 作者:Together AI
- 发布时间:2026-07-31 原文地址:https://www.together.ai/blog/autoscaling-endpoints-for-llm-inference
原文信息
- 作者Together AI
- 发布时间2026-07-31
- 原文链接www.together.ai/blog/autoscaling-endpoints-for-llm-inference
原文链接:https://www.jxxy.net/ai/articles/together-llm-autoscaling-guide/