LLM 评估完整指南 - MachineLearningMastery.com
📌 One-Sentence Summary
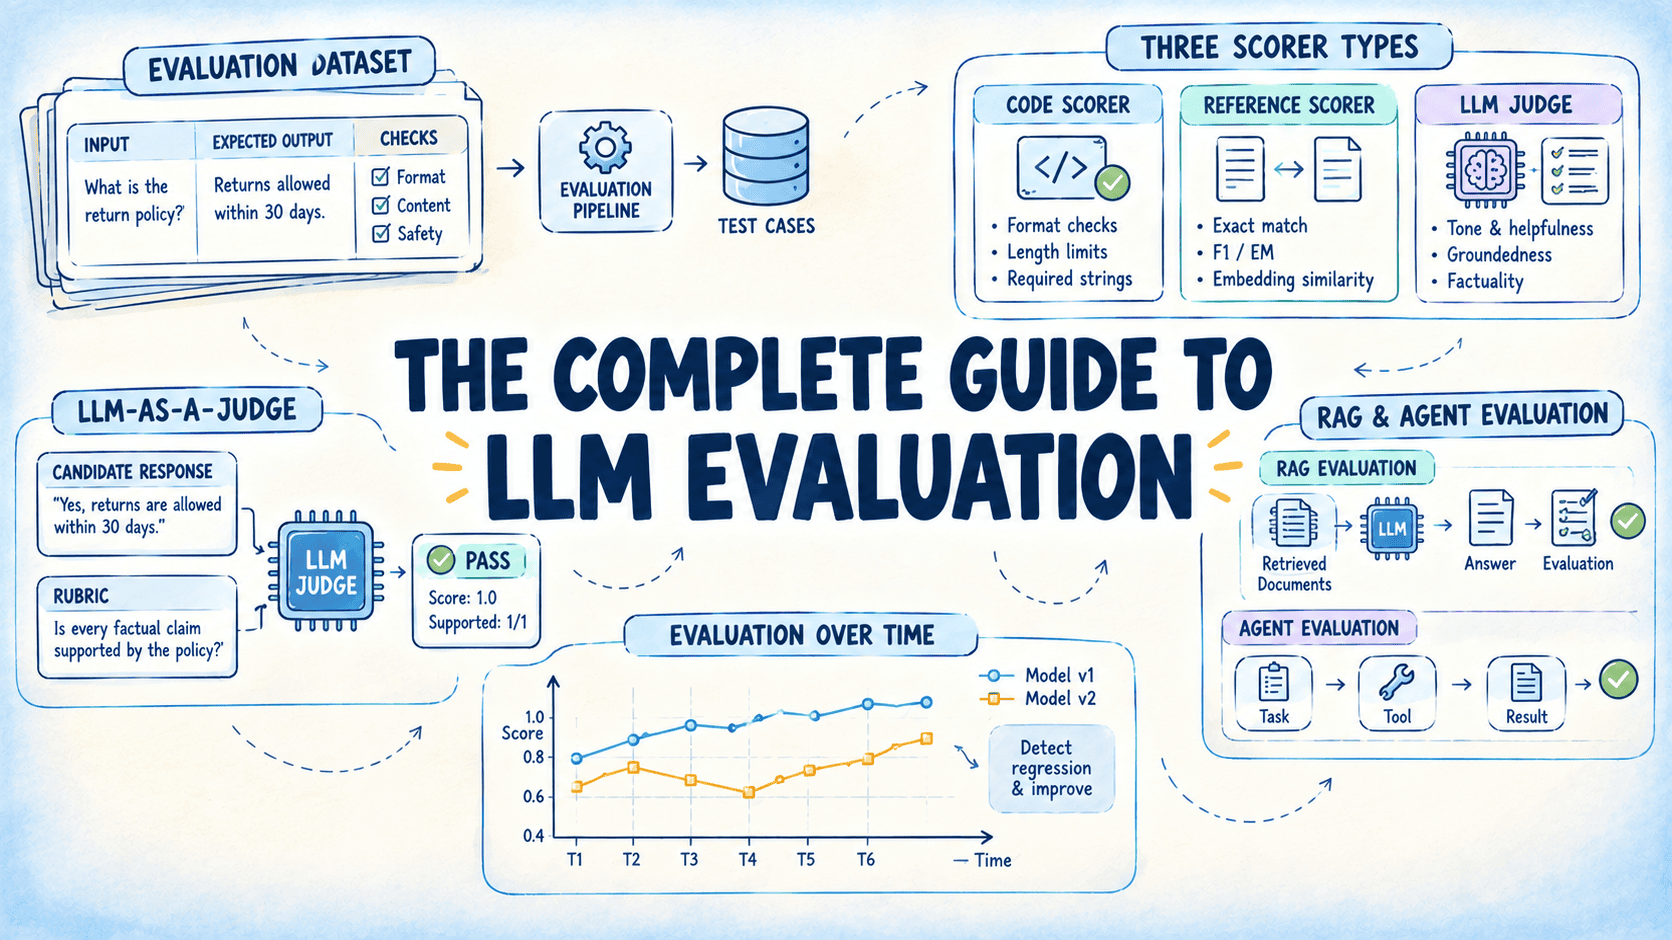
本指南全面介绍如何系统评估 LLM 应用,涵盖代码评分器、LLM-as-judge 框架、RAG 与智能体评估技术,以及离线和在线测试策略。
📝 Summary
本文系统介绍了评估 LLM 应用的方法,涵盖三类评分器(代码评分器、基于参考答案的评分器和 LLM 评审器)、LLM-as-judge 的详细方法(包括评分标准设计、QAG、G-Eval 和成对比较)、偏差缓解策略、针对检索器与生成器组件的 RAG 系统评估、通过任务完成情况和诊断分数进行智能体评估,以及在发布周期中实施离线和在线评估。指南强调,应将结构化评估作为 LLM 输出的回归测试,并介绍了用于校准、可靠性保障和质量监控的实用技巧。
💡 Main Points
三类评分器满足不同的评估需求
代码评分器可执行 JSON 有效性等确定性检查;基于参考答案的评分器使用 F1 等指标与已知答案进行比较;LLM 评审器则通过基于评分标准的提示词,评估语气和实用性等主观指标。
LLM-as-judge 框架需要结构化评分标准和校准
有效的评审器应使用包含四个部分的提示词(评估标准定义、输入内容、评估流程和严格的输出格式),将 temperature 设为 0 以保持一致性,并使用 Cohen's kappa 对照人工标注进行校准,避免一致性仅达到随机水平。
RAG 系统需要在组件层面进行评估
应分别评估检索器(上下文精确率和召回率)与生成器(忠实度、答案相关性);实时流量可采用无参考指标,离线指标则需要预期答案。
智能体评估应从任务完成情况入手
首先确认用户目标是否达成,再通过工具正确性、参数正确性和执行轨迹分数诊断失败原因,从而找出具体的故障点。
离线评估和在线评估相辅相成
离线评估使用带版本管理的黄金测试集(25-50 个案例),在每个 PR 上运行,并设定书面的发布标准;在线评估则对实时流量进行抽样,使用无参考检查来发现表现漂移和意外输入。
💬 Key Quotes
「LLM 评估能在用户发现问题之前捕捉到这些故障。你需要构建测试用例,依据书面标准为每个输出评分,并比较每次变更前后的分数。」
「用评估来指导迭代,用测试来保障发布。」
「每项评估都包含三个部分:输入数据集、为输出评分的评分器,以及随时间记录的分数。」
「凡是能用规则判断的地方,都应优先使用代码评分器。它们无需成本,而且每次都会返回相同结果。只有在规则无法表达评估标准时,才加入评审器。」
「最重要的缓解措施是对照人工标注进行校准。你可以亲自标注 30 至 50 个输出,让评审器评估同一批内容,然后进行比较。」
「kappa 为 0 表示一致性仅达到随机水平,1 表示完全一致。通常,超过约 0.6 的值会被视为具有较高一致性。」
📊 Article Meta
AI Screening: 88
Source: Hacker News - Newest: "LLM"
Author: eigenBasis
Category: 人工智能
Language: 英文
Read Time: 11 min
Word Count: 2704
Tags:
AI 与智能应用 , 模型训练与推理 , AI 工程 , 测试与质量 , 提示工程
收藏了,以后慢慢研究。
这个比较实用,已转发给同事。
支持作者,持续关注中。
这个观点很中肯,深有同感。
不错不错,已加入书签。
实话,说的不明不白
思路清晰,干货满满。
赞同,实践出真知。
点赞,必须点赞
这个观点很中肯,深有同感。
楼主辛苦了,内容很有参考价值。
点赞,必须点赞