LLM 基准刷分的统计分析
📌 One-Sentence Summary
一项统计分析为 Epoch 能力指数加入了一个基准刷分系数,发现 Google 的模型在早于其发布的基准上得分高出约 1.4 个 ECI 点,这一效应虽小却持续存在,且通过了大多数稳健性检验。
📝 Summary
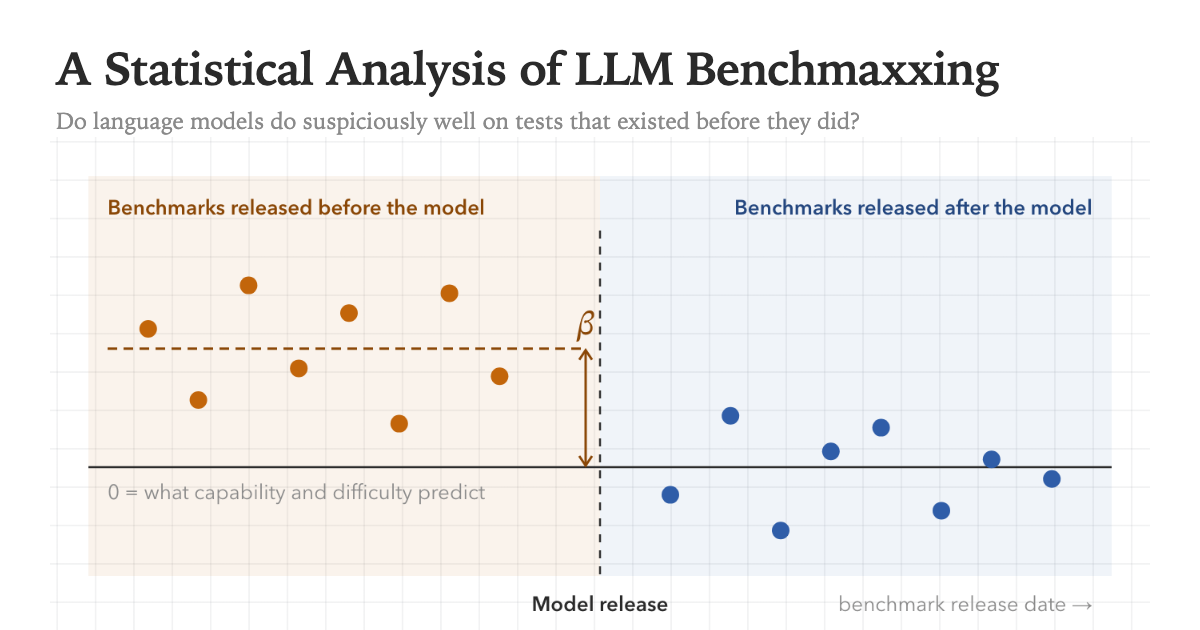
这篇文章检验了一个流行的指控:实验室在刷基准,即让模型过度拟合公开排行榜。作者的关键洞察是,在模型发布之后才推出的基准构成了天然的对照组:模型不可能针对其构建时尚不存在的基准进行调优。在 Epoch 能力指数的基础上——该指数同时估计每个模型的能力和每个基准的难度——作者加入了一个参数,即基准刷分系数 beta,它仅对早于模型发布的基准生效,并在实验室层面进行拟合。Google DeepMind 显示出最大的正系数,约为 1.41 个 ECI 点,而 OpenAI 的系数为负,Anthropic 的系数接近于零。该效应很小,低于 Epoch 对单个模型自身的不确定性,只有在跨数十个模型汇总数十个基准时才会显现。如果 Google 的全部 beta 都来自基准刷分,其 35 个模型平均将损失 1.3 个 ECI 点,发布表上的得分每个基准将下降 3 到 5 分。作者针对十五项质疑对拟合进行了压力测试;该模式在大多数质疑下依然成立,但替代解读包括随基准年龄变化的平滑曲线,以及在新近的智能体基准上的特定弱点。一项双胞胎分析比较了来自不同实验室、能力相当的模型,指向同一方向,但仍处于噪声范围内。
💡 Main Points
在模型发布之后才推出的基准,可作为检测基准刷分的天然对照组。
模型不可能针对其发布时尚不存在的基准进行调优,因此真实的能力差距应当在较旧和较新的基准上同等显现;在较旧基准上系统性占优,便是针对它们调优的证据。
在 Epoch 能力指数中加入单个实验室层面的基准刷分系数,会为 Google DeepMind 带来虽小却持续存在的正效应。
该系数对 Google 约为 1.41 个 ECI 点,对 OpenAI 为负,对 Anthropic 接近于零;它小于 Epoch 对任何单个模型的不确定性,只有在跨数十个模型汇总数十个基准后才会显现。
如果 Google 的全部系数都来自基准刷分,实际影响将是温和的。
Google 的 35 个模型平均将损失约 1.3 个 ECI 点,Gemini 4.0 Argon 将从第 4 名降至第 6 名,Gemini 3.8 Flash 将从第 20 名降至第 29 名,发布表上的得分每个基准将下降约 3 到 5 分,例如 DeepSWE v1.1 从 73.7 降至 69.3。
该结果通过了大多数稳健性检验,但仍存在替代解释。
随基准年龄变化的平滑曲线比在发布日期处的阶跃拟合得更好,且 Google 的模型在新近的智能体基准上比同行低约 3 个 ECI 点,这解释了它们在较新基准上的大部分下降,以及系数领先优势的约三分之一。
一项比较来自不同实验室、能力相当模型的双胞胎分析指向同一方向,但无法将效应与噪声区分开。
在 83 对能力相差 2 个 ECI 点以内、发布时间相隔 6 到 9 个月的 Google 与其他实验室配对中,Google 在较旧基准减去较新基准上的优势超出对照组 2.7 和 2.2 分,但标准误分别为 3.8 和 1.7,两者均未超过距零 1.3 个标准误。
💬 Key Quotes
主要前提很简单:模型不可能针对其发布时尚不存在的基准进行刷分。
基本上,β 是一个模型似乎拥有的能力加成,但仅限于早于它的基准上。
这一切都不能证明任何实验室在刷基准。这是一个拟合观测数据的统计模型,正的 β 与不止一种解释相容。
第二点是,尽管信号确实存在,但它并不很强:1.41 个 ECI 点,低于 Epoch 对任何单个模型得分给出的不确定性。
双胞胎分析与 β 指向同一方向;仅凭它们自身,无法将其与噪声区分开。
📊 Article Meta
AI Screening: 86
Source: Hacker News - Newest: "LLM"
Author: bhu8
Category: 人工智能
Language: 英文
Read Time: 13 min
Word Count: 3205
Tags:
AI 与智能应用 , 模型训练与推理 , 数据科学 , 模型发布 , 大语言模型 (LLM)
支持作者,持续关注中。
思路清晰,干货满满。
有没有更详细的教程,期待后续。
看完了,收获满满,期待更多更新。
赞同,实践出真知。
实话,说的不明不白
看标题就点进来了,内容果然没让人失望。
作者写得真不错,学到了不少。
思路清晰,干货满满。
有没有更详细的教程,期待后续。
刚好最近在找这方面的资料,太及时了。
赞同,实践出真知。