利用 Docling 将混乱文档转换为结构化数据
📌 One-Sentence Summary
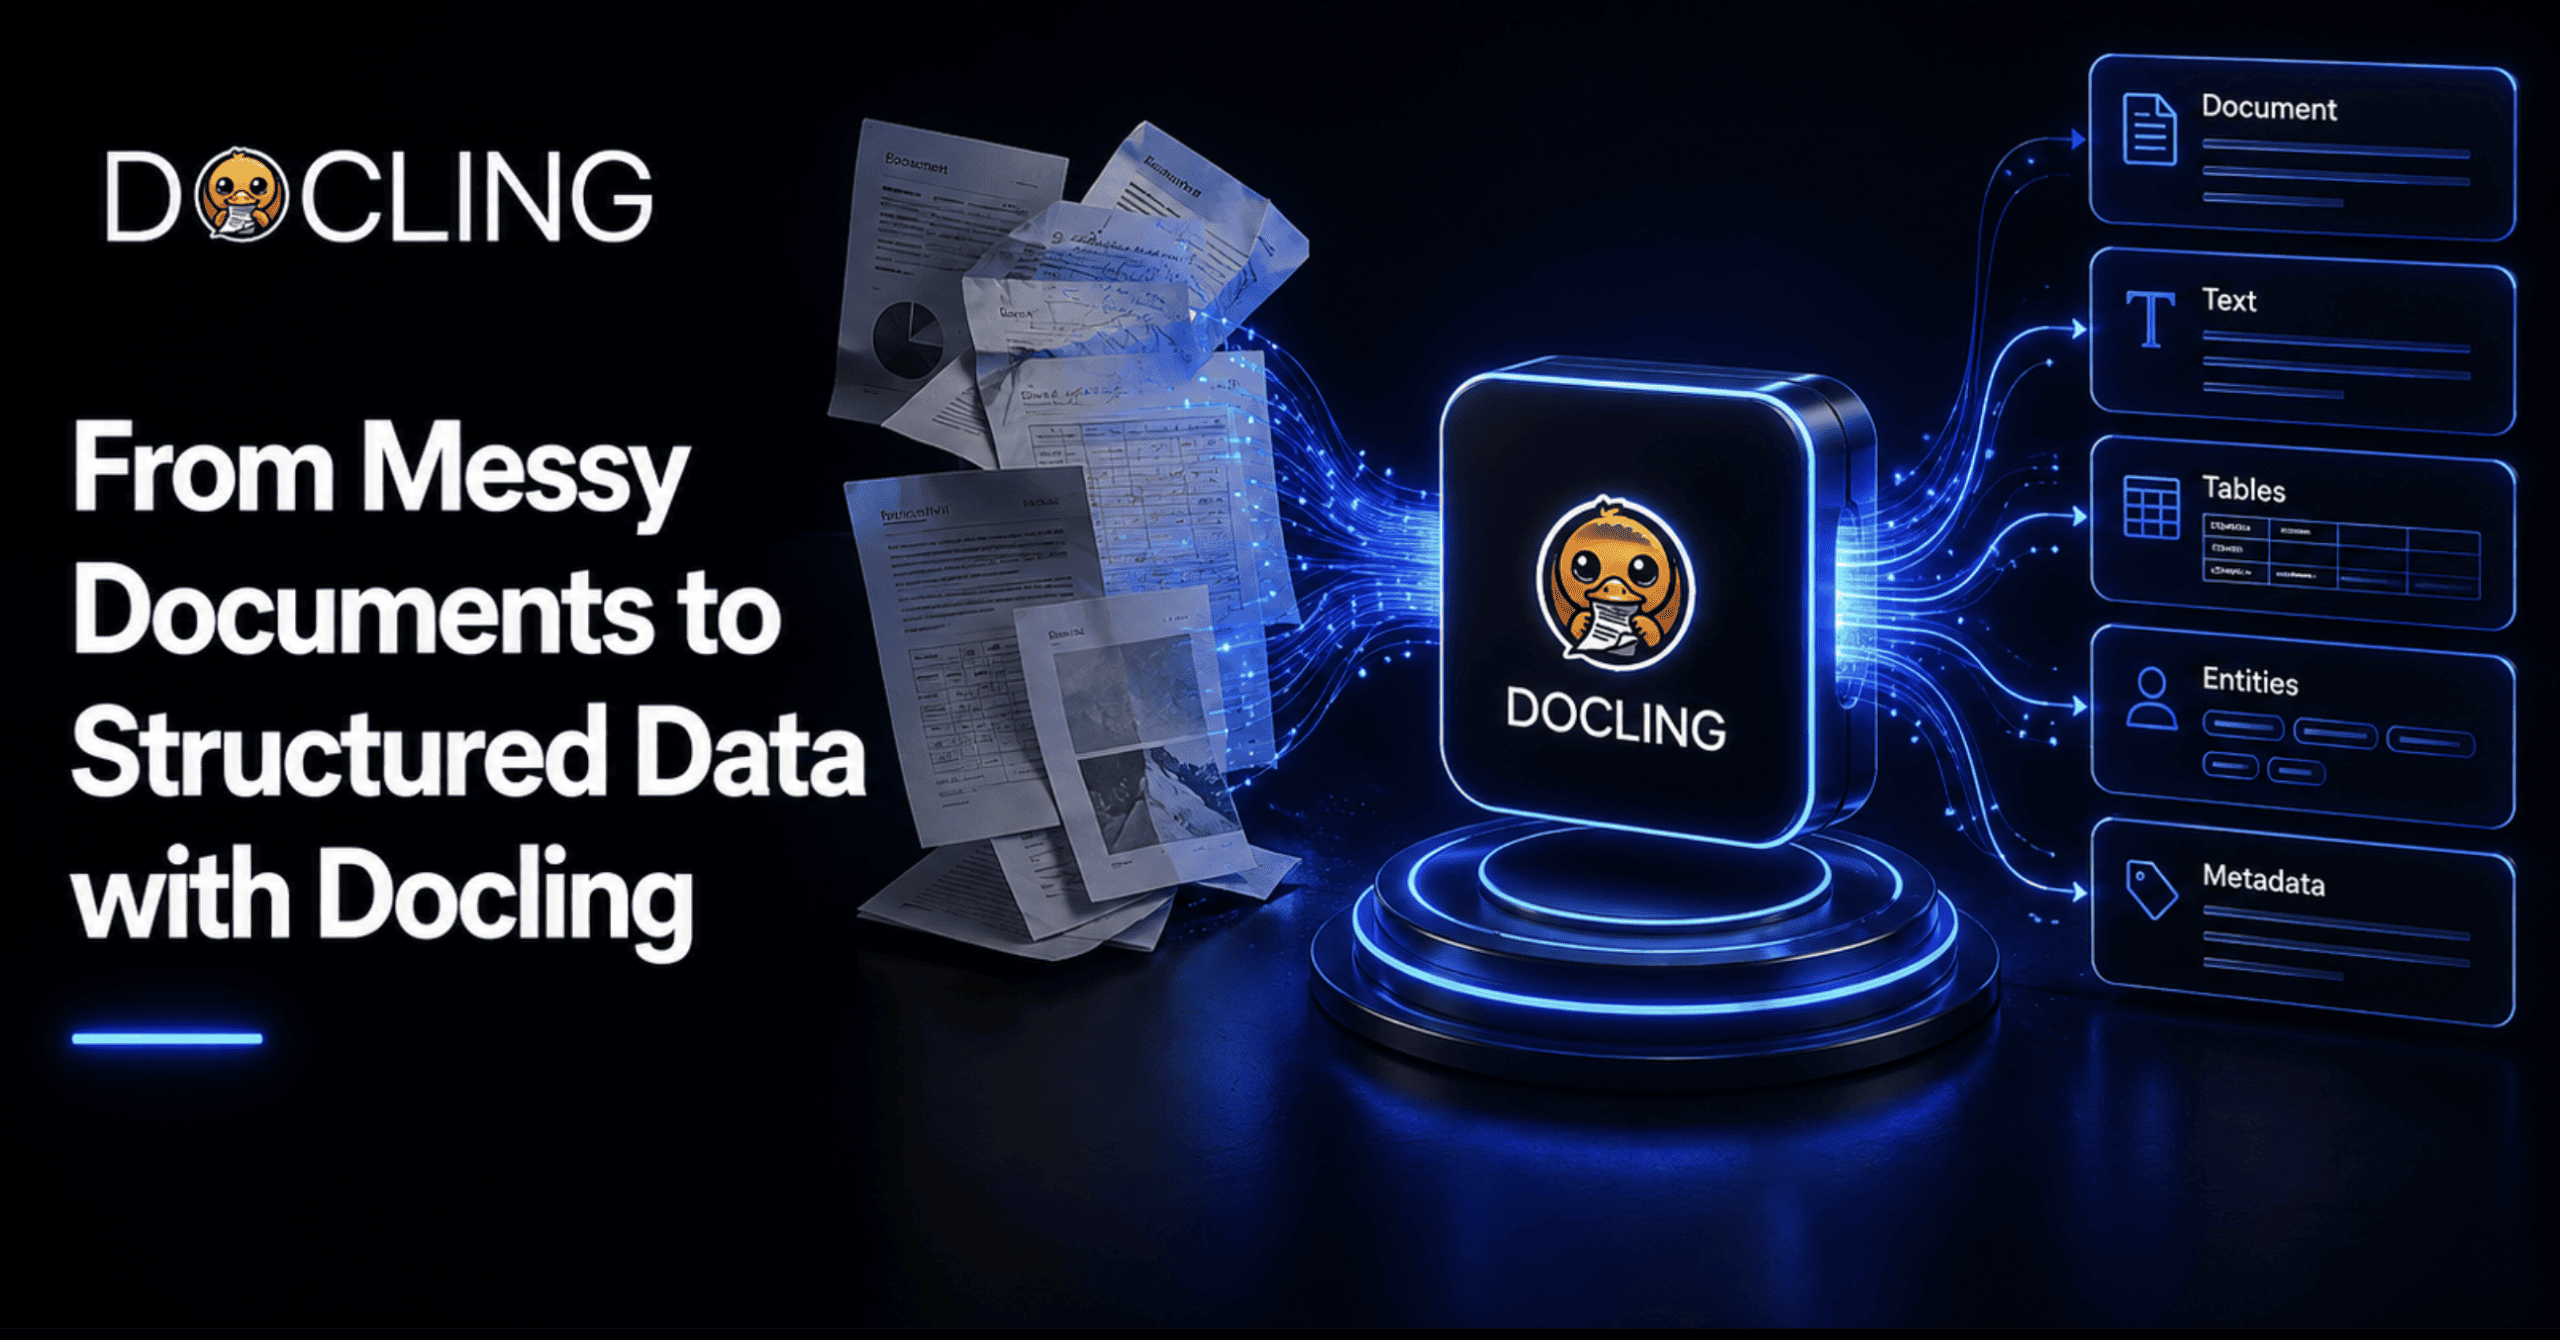
本文介绍了由 IBM Research 开发的开源工具包 Docling,它可以将 PDF 和图像等复杂文档转换为适用于 AI 和 RAG 流水线的结构化表示形式。
📝 Summary
本文深入探讨了 Docling,这是一个基于 Python 的库,旨在解决“杂乱文档”问题。与会将文本扁平化并打乱多列布局的基础提取器不同,Docling 能够识别表格、标题和公式等结构化元素,同时保持阅读顺序。内容涵盖了安装方法、核心的 'Documentling' 数据结构、导出到多种格式(Markdown、JSON、HTML),以及如何通过 OCR 处理扫描内容。最后,文章演示了如何使用 HybridChunker 为检索增强生成(RAG)创建上下文感知的分块,它遵循文档的层级结构,而非简单的字符计数。
💡 Main Points
Docling 超越了扁平文本提取,实现了结构理解
标准的提取器经常打乱多列布局或表格结构;Docling 则识别表格、说明和标题等组件,以保持逻辑阅读顺序。
Documentling 数据模型提供了统一的表示
通过将各种输入转换为一致的树状结构(正文、家具、分组),它允许下游 AI 系统跨格式可靠地处理内容。
混合分块对于有效的 RAG 流水线至关重要
HybridChunker 不按字符数拆分,而是利用文档结构来确保分块在上下文上保持完整并尊重标题级别。
内置的 OCR 和表格检测可处理复杂布局
该工具可以通过集成的 OCR 处理扫描文档,并在无需手动解析的情况下重建复杂的多级表头和单元格。
💬 Key Quotes
Docling 接收任何格式的文档,并将其转换为人类和 AI 系统都能可靠处理的统一结构化表示形式。
它不仅仅是从页面上提取字符;它是在识别每部分内容是什么类型——是说明、列表项还是表格单元格——并保留这些部分之间的关系。
HybridChunker 的设计初衷专门为了为了避免朴素的字符计数拆分器将句子切成两半。
📊 Article Meta
AI Screening: 86
Source: KDnuggets
Author: Shittu Olumide
Category: 软件编程
Language: 英文
Read Time: 13 min
Word Count: 3197
Tags:
Python , AI , 文档解析 , RAG , 开源
整理得太全面了,省了我不少时间。
实话,说的不明不白
思路清晰,干货满满。
作者写得真不错,学到了不少。
点赞,必须点赞
有没有更详细的教程,期待后续。
思路清晰,干货满满。
实测过类似工具,作者说的基本属实。
思路清晰,干货满满。
点赞,必须点赞
作者写得真不错,学到了不少。
实测过类似工具,作者说的基本属实。