机器人策略评测扩展到上千并行仿真:Ray Serve 推理解耦与 N-to-M 架构实操
一句话结论
Anayscale 技术团队成员 Ian Judah 在这场 56 分钟的演讲里回答了一个每个机器人团队迟早要面对的问题:怎么知道一个机器人策略已经准备好离开开发环境、上真实硬件?答案是大规模并行仿真评测——但当成百上千次仿真同时跑起来,评测本身就变成了一个分布式计算工作负载。演讲给出完整参考架构:策略部署为 Ray Serve 推理服务、仿真器作为 Ray Actor 各占一 GPU、两侧按 N-to-M 关系独立扩缩,用 40 步动作分块(action chunking)摊平网络往返边界,并以 Unitree G1 人形机器人为例全程实操。
为什么评测是机器人落地的真正门槛
开场放了两段对比强烈的视频。第一段是波士顿动力 Atlas 登台表演——机器人在公众面前第一次登台,流畅完成一串打磨过的行为,全场喝彩。第二段是一段机器人当众失误的集锦。讲者的用意不是嘲笑任何团队,也不打算从视频反推具体故障原因,而是指出一个行业共识:视频里看到的是 polished 的成品行为,看不到的是背后的开发循环——数据采集、策略训练、失败实验、回归测试、硬件测试、以及可能数以百万计的仿真交互。观众为 Atlas 鼓掌的那一分钟,背后是工程团队数年的迭代沉淀。
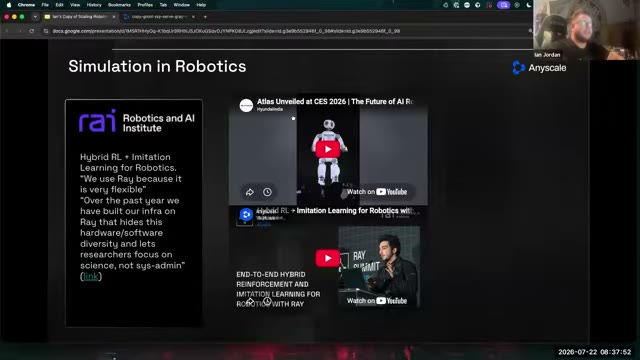
当软件开始控制物理系统,任何错误输出都不再只是一个糟糕的预测——它可能撞倒真人、损坏设备、摧毁公众信任。物理世界的失败成本与数字世界完全不在一个量级,这决定了机器人团队必须在上真机之前把策略的行为边界摸清楚。所以策略从虚拟环境迁移到物理世界之前,必须回答:它在不同物体、不同初始位置、不同光照、不同指令、不同传感器观测、不同随机种子下表现如何?一次成功的 rollout 令人鼓舞,但它不能刻画一个完整的策略。仿真给出了安全、可重复的回答途径;而当评测规模从一次扩展到成百上千次,仿真本身就成为分布式计算问题——这正是 Ray 的领地,也是本次演讲的主线。
讲者还点出一个容易被忽略的背景:机器人正加速进入为人类设计的环境(工厂、仓储、公共场所),仿真基础设施的投入强度直接决定迭代速度。先进机器人团队无一例外重度依赖仿真,而一旦仿真进入学习闭环,集成就变成分布式系统问题——这是本次演讲选择在 Anyscale 场合讲这个题目的原因:这类团队普遍用 Ray 解决它。
演讲结构也随之展开:先讲为什么要解耦(三个结构性理由),再自顶向下实操(连接集群、部署策略、打包观测、扇出仿真),收尾归纳三条结论并开放问答——演示约占二十分钟,节奏紧凑。
讲者的背景也值得一提:作为 Anyscale 技术团队成员,他的工作聚焦在支撑这类大规模仿真工作负载的基础设施侧,见过多个机器人团队从单机评测撞墙后迁移过来的完整路径。这场演讲浓缩的正是这些迁移里反复出现的共性答案。
仿真在机器人工作流里的三大用途与评测的特殊地位
仿真在机器人工作流里有三大用途:策略训练(RL 或大规模合成数据)、合成数据生成(自动标注、长尾场景挖掘——故意生成物理世界里难以等到的罕见条件)、以及策略评测。讲者聚焦第三类。训练告诉你产出了一个 checkpoint,评测告诉你这个 checkpoint 是否更好、是否回退、在哪里失败、是否值得进入更昂贵的测试阶段。合在一起,仿真是学习循环的三根支柱,评测则是其中最容易被轻视、却最直接影响上线安全的一根。
这个划分对团队分工有直接意义。训练侧的产出物是模型权重,评测侧的产出物是「能不能上真机」的判断依据——两者用的仿真基础设施可以是同一套,但工作负载形态完全不同:训练是长时间连续作业,评测是短时间高并发批处理。用跑训练的思路搭评测管线,是第二个常见误区;评测天生就是扇出型的批量任务,架构选择应该围绕「并行度、收集、统计」三个词展开。
评测的规模要求远超直觉:多种子、多初始条件、多场景、多任务指令、多策略版本的组合展开后,rollout 数量轻松上千。单次仿真实验的心态管理不了这个量级——你需要的是把评测当批量计算作业来调度、执行、收集、统计的心态。讲者用「从单一工作负载到数千工作负载的转变」概括这次演讲要处理的本质变化,这个转变一旦完成,评测结果的置信度就从「感觉不错」升级为「有统计意义的判断」。
与训练的关系也值得厘清:训练产出 checkpoint,评测筛选 checkpoint。一个策略版本在评测里表现回退,就省下了真机测试的昂贵成本;评测发现策略在特定场景族失败,就反哺数据需求——补采或用神经渲染造长尾场景。评测因此不是开发流程的终点站,而是学习闭环里的信号源。讲者用「从单一工作负载到数千工作负载的转变」概括这次演讲要处理的本质变化。
为什么必须解耦:内存、运行时与扩缩三大冲突
把策略和仿真器塞进同一个进程或同一块 GPU,是新手最容易踩的坑。讲者给出三个结构性理由,每一个都来自真实团队的教训。第一是内存压力:仿真器需要渲染和物理引擎的内存,数十亿参数的 VLA(视觉-语言-动作)策略需要推理内存——两者叠加在一张卡上互相挤压,谁也跑不到设计性能。第二是运行时冲突:仿真器与推理引擎各自的依赖库、线程模型、GPU 上下文容易打架,排查这类冲突消耗的工程时间往往比写功能本身还多。第三也是最重要的:两侧需要独立扩缩。每次 rollout 都要一个仿真器,但不是每个 rollout 都需要自己的一份策略副本——那样计算和内存都贵得离谱。正确关系是 N-to-M:N 个仿真 worker 共享 M 个策略推理副本;仿真器等推理就加副本,推理有富余就加仿真器,瓶颈挪到哪里都不用改应用逻辑。
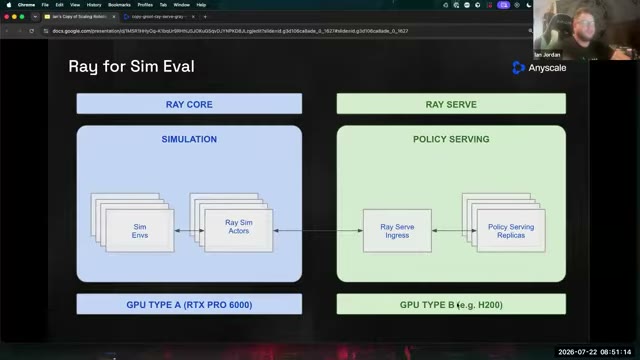
三个原则合起来就是 disaggregated(解耦式)架构的设计纲领:物理仿真侧管渲染与物理,策略推理侧管大模型前向,中间一条清晰的服务边界。这条边界带来的不只是性能,还有工程上的可替换性——两侧各自升级、各自部署、各自观测,互不拖累。规模小时这种解耦看似过度设计,规模上千后它就是唯一能跑的形态。演示的环境是 LimeSim 类仿真器加 Ray 集群的组合,但同样的骨架换任何物理引擎都成立——边界定了,引擎可换。
实操五步:从连接集群到并行 rollout
演示从 notebook 自顶向下搭建,共五步外加一个背景加载步骤(第零步只是装载凭证,从略)。第一步连接 Ray 集群:ray.init(address=“auto”) 附接到 Workspace 底层已运行的集群,输出立即报出家底——4 个 GPU、32 个 CPU、48 GB 共享对象存储内存。讲者提醒注意措辞的变化:你不再运行一个 notebook,你在调度一个集群的资源。Anyscale 的可观测性面板也能随时查看这些资源水位,观测手段与运行手段同在。
第二步把策略部署为 Ray Serve 服务:策略声明 GPU 需求、初始化时加载模型、暴露预测端点;max_ongoing_requests 控制单个副本接受的并发量——这个参数直接决定「多少仿真器同时敲策略的门」时排队多长;要扩推理容量就加副本,Ray Serve 管理副本生命周期与请求路由,仿真器侧的调用代码始终不变。部署完成后策略就是一个真实 HTTP 服务,模型只加载一次,全集群任何仿真器都能调用——这就是解耦的直接收益:昂贵的模型少加载几次,所有客户端共享。
第三步手动调一次策略:在交给仿真器之前,亲手走一遍那个将来要发生成千上万次的网络往返,看清边界上流动的到底是什么。这一步看似多余,实则是调试分布式系统的黄金习惯——边界上的数据契约先在单次调用里验证,再放大并发,出问题时才不至于在千百次 rollout 的日志里大海捞针。
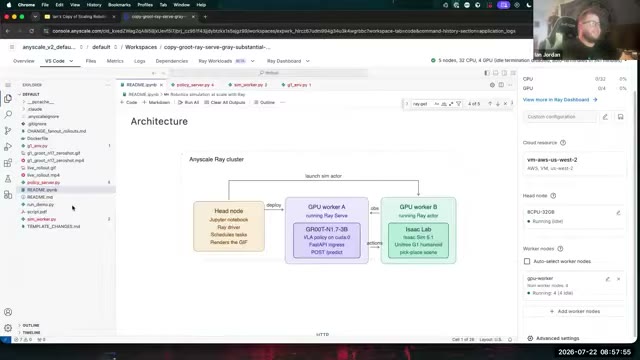
第四步是观测打包:以 Unitree G1 人形机器人为例,一次观测=三样东西——机器人自己视角的相机帧堆栈(egocentric,第一人称视角的连续画面)、关节状态(机械臂、手、腰、底盘高度、导航等全身自由度的位置读数)、加任务指令(自然语言描述的目标)。三者捆成一个张量送进策略,策略吐回覆盖全身自由度的动作。这一步的意义在于把「机器人的世界」翻译成「模型的张量」——边界两侧的数据契约在这里定型,后续上千次 rollout 复用的都是这一份契约;契约定错,后面的并行度再高也只是更快地产生错误结果。
第五步 N-to-M 全景:一侧是固定数量的策略副本(演示中是 1 个),另一侧是若干仿真器(演示中 3 个,各占一 GPU),全部共享另一块 GPU 上的那一个策略。瓶颈判定与扩容方向都由观测驱动:仿真器闲置等推理→加策略副本;推理有富余→加仿真器。两侧的数量关系随评测规模弹性变化,而代码侧对此完全无感。
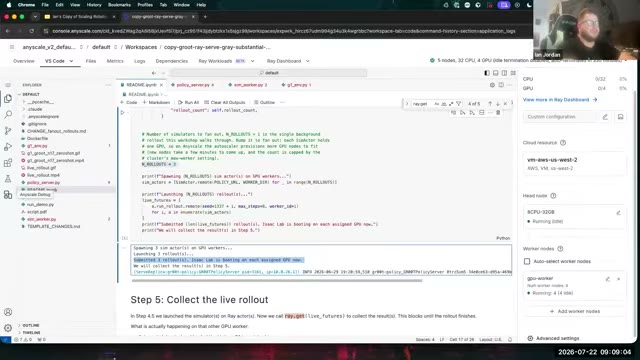
演示中每个仿真器由一个 Ray Actor 驱动——用 ray.remote 装饰的类、声明一个 GPU,与策略声明 GPU 的方式完全同构。要跑一千次评测,就把 rollout 数量交给 Ray Core 扇出,autoscaler 在需要时自动加节点;要评测另一个策略,改 model path 即可,循环、转换层、编排全部不动。这种「配置即扩缩」的体验,正是把分布式复杂性沉到基础设施层之后,应用层该有的样子。
40 步动作分块:摊平网络边界的工程艺术
整个架构里最精巧的一处设计。仿真器与策略之间隔着网络,如果每个物理步都跑一次推理往返,网络延迟将吞掉一切——每次往返的固定开销乘以每秒几十步的物理推进频率,计算资源大部分时间在等网络而不是在做推理。参考实现的选择:一次策略调用返回 40 步动作块(action chunk),仿真器执行若干物理步(比如 8 步)后再请求下一块。这个设计让网络往返次数摊薄近一个数量级,是整个 disaggregated 架构能实用的关键——讲者称之为对网络边界的 amortize(摊销)。
演示循环里的节奏清晰可见:一次策略调用,接八次物理步推进,再一次策略调用——周而复始。40 步块覆盖全身自由度的动作(机械臂、手、腰、底盘高度、导航全在一个响应里),仿真器按短 horizon 执行其中一段。块太小网络开销压不住,块太大动作预测跟不上环境变化,40 与 8 的比例是参考实现给出的工程平衡点。
换策略评测也极其干净:改一下 model path 就行,循环、转换层、编排逻辑一行不动。对比评测多个策略版本时,同一套仿真器集群轮流接不同端点,结果直接可比——这在「评测是批量作业」的设定下尤为重要:变量只有策略本身,其余全部受控。
转换层(transition layer)的适配器设计同样值得抄作业:观测进策略前的重塑、动作出策略后的分发,全部收拢在一个具名的小文件里(演示里是一个 concatenate 函数所在之处)。想换机器人、换任务,只改这一个文件,系统其余部分零感知——这是把「多变的边界」与「稳定的骨架」分离的经典工程手法。团队评测新机器人原型时,接入成本从「改遍全系统」降到「写一个适配器」,迭代速度的差距由此拉开。
Q&A 实录:GPU 利用率目标与扩展问答
问答环节最有价值的一问:GPU 和内存利用率应该定什么目标?讲者的回答很诚实:理想情况计算利用率 100%,但实际取决于工作负载——VLA 微调这类大策略训练不难吃满 GPU;可如果你跑的是传统机器学习(比如训练一个 ResNet 或 MLP)却用 B300 级别的卡,就别指望高利用率,那是负载与硬件不匹配的问题,不是你代码写得差。这个回答对团队做容量规划很有参考价值:先看负载类型,再定利用率目标,最后才谈优化——顺序反了就会陷入「为了跑满卡而优化」的本末倒置。
还有观众问大规模部署的经验模式——讲者提到共享 Q 表跨 actor 分片(按状态哈希,等价于分片参数服务器的思路)、simulators 与共享 policy server 的组合等参考模式,并承诺通过博客文章分享完整参考实现(演示正是基于该博客的参考实现构建)。这些模式对做 RL 训练的团队同样适用——评测侧验证过的架构,搬到训练侧的仿真回放、经验采集也是同一套骨架。
问答尾声还有关于失败处理与断点续跑的讨论——大评测批次跑一半集群出问题时,已完成的 rollout 结果保留,未完成的按 seed 重启,评测作业的幂等性设计让「部分完成」也可以先出统计。这类工程细节在演示里没有完全展开,但被列入参考实现的文档范围。
三条带走的结论
讲者收尾给出三条核心结论。第一,仿真不只是训练工具——它支撑策略训练、合成数据生成,以及同样关键的、可重复的评测。第二,大规模评测是一个闭环分布式系统工作流:真实物理和大型策略都需要可观算力,把所有东西塞进一个进程的增长路径必然撞墙。第三,把策略推理与仿真解耦,让两侧各自用最合适的方式扩缩——这是从单次实验走向数千并行 rollout 的架构前提。
三条结论背后是同一条主线:当机器人开发的核心循环(训练-评测-迭代)每一步都变成计算密集型,基础设施的选择就从「锦上添花」变成了「天花板」。评测吞吐上不去,迭代速度就被锁死;迭代速度被锁死,策略质量的上限也就被锁死。这不是买更多 GPU 能解决的问题——没有解耦架构,加机器只会把等待从一个环节挪到另一个环节,总吞吐还是卡在最慢的那一环。
对机器人团队而言,这套架构的可复用性极强:Ray Serve 端点换成你自己的 VLA 模型、仿真器换成你自己的环境、转换层适配器接你的机器人观测规格,N-to-M 的骨架原样保留。当评测从「跑一次看看」变成「跑一千次统计」,策略上真机的信心才有了数据地基。
演讲的适用范围也顺带划清:它讲的是评测侧的规模化,不是训练侧——训练规模化有另一套成熟方案(数据并行、FSDP 等)。但两侧在基础设施层是同一套语言:资源声明、Actor 调度、服务化推理、自动扩缩。一个团队把评测侧搭起来,训练侧的迁移成本也随之下降——这是投资分布式基础设施的复利。
最后值得强调讲者的务实态度:全程没有把 Ray 包装成银弹,而是反复指出哪些问题属于分布式架构能解的(吞吐、扩缩、资源隔离),哪些属于机器人学本身要解的(策略质量、仿真保真度、长尾场景)。把基础设施问题从科学问题里剥出来分别治理,这场演讲本身就是一次方法论示范——对任何正在规模化的机器人团队都适用。
时间线也值得一提:这是一场现场直播的 webinar,讲者在问答环节明确表示未答完的问题会通过邮件逐一回复,参考实现的博客链接会后发给所有参会者——对没能到场的人,视频加博客基本能还原全部演示细节。
原文信息
- 原视频标题:Scaling Robot Policy Evaluations to Thousands of Parallel Simulations
- 频道:Anyscale
- 讲者:Ian Judah(Anyscale 技术团队成员)
- 发布日期:2026-07-22
- 视频时长:约 56 分钟
点赞,必须点赞
内容翔实,正好需要,先收藏再看。