教一个小型 LLM 为机器人做规划——Dawei Sun
📌 One-Sentence Summary
本文介绍了通过强化学习训练一个小型 LLM(Qwen3.5-9B)来解决以信号时序逻辑表达的机器人运动规划任务,并证明在具备工具(plan_path 和 check_path)的情况下,该模型在复杂的钥匙-门迷宫问题上能够达到与更大的教师模型(DeepSeek-V4.1-Flash-1017)相媲美的性能。
📝 Summary
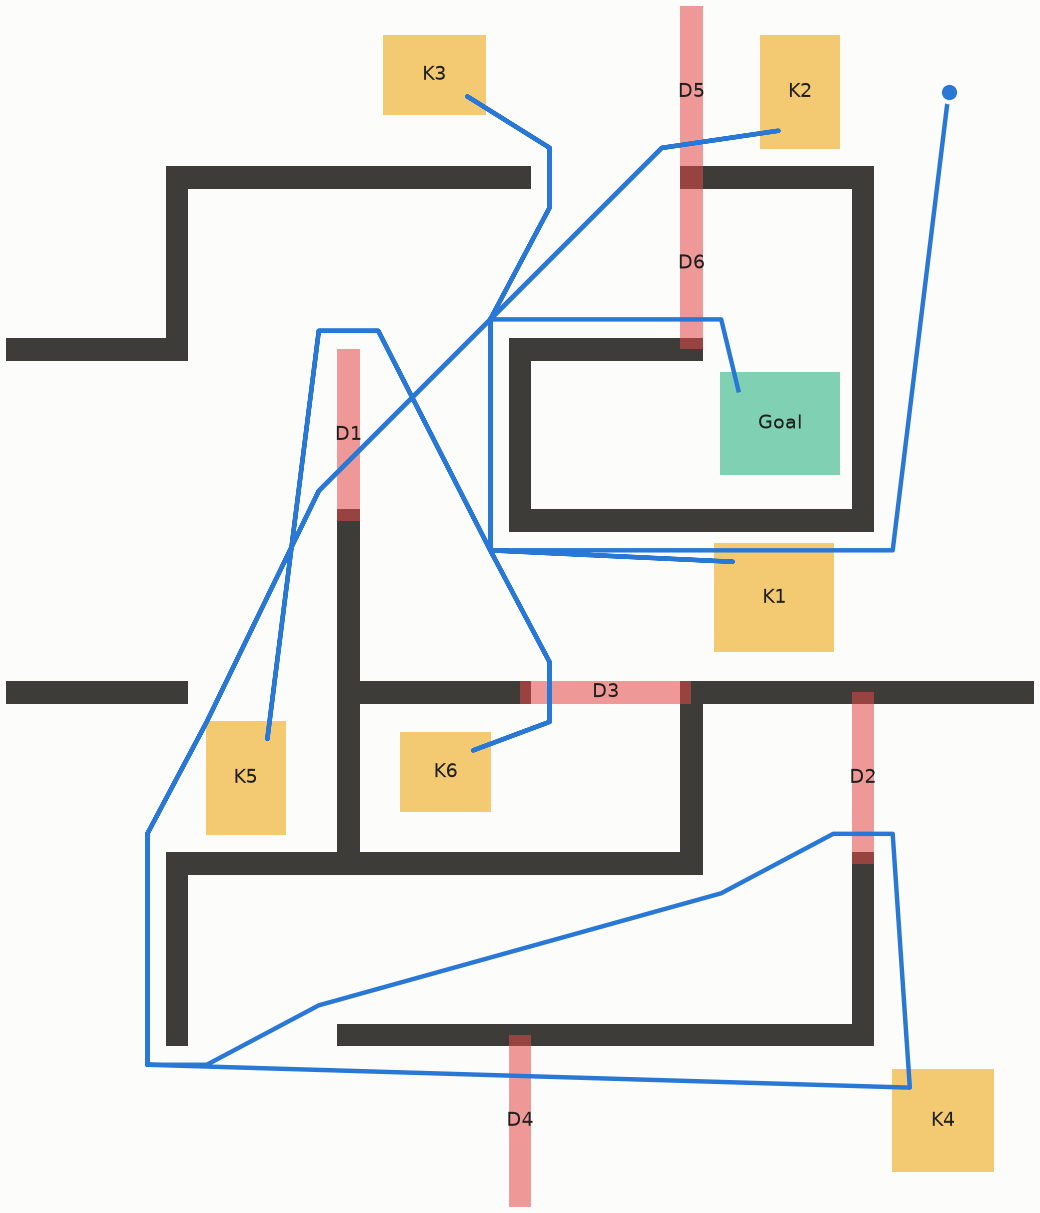
文章详细描述了一项研究,旨在训练一个小型开源语言模型(Qwen3.5-9B)作为机器人的高层运动规划器,使用信号时序逻辑(STL)规范。作者比较了两种方法:(1)纯强化学习,由模型直接计算路径,但未能有效学习;(2)为模型提供两个工具——用于计算无碰撞路径的 plan_path 和用于验证的 check_path——从而实现了成功的学习。他们将任务分为八个难度等级(L1-L8),环境复杂度递增,如钥匙-门迷宫。借助工具,基础模型达到了 0.67 的整体准确率,在最难的 L8 等级上达到 0.40。强化学习训练侧重于较难的等级(尤其是 L8,占训练任务的 50%),以避免过于简单的学习信号。这项工作表明,在 LLM 推理与专用工具之间分工,可以使小型模型在复杂规划任务中发挥有效作用。
💡 Main Points
纯强化学习在几何计算任务上失败
当模型必须直接计算距离、到达时间和无碰撞路径时,它频繁出现算术错误,导致 79% 的路径与障碍物碰撞,使得强化学习无效,因为奖励几乎总是为零。
工具使用使强化学习训练成功
提供 plan_path 和 check_path 工具后,模型可以处理几何和验证,同时专注于高层规划决策,使基础模型达到 0.67 的整体准确率,在最难的 L8 等级上达到 0.40。
训练课程侧重于困难等级
作者主要在 L3、L5、L7 和 L8 上训练(L8 占 50%),因为较简单的等级会导致所有样本都成功的分组,无法为 GRPO 提供学习信号,而较难的等级确保每个分组内既有失败的样本也有成功的样本。
思考模式降低效率
模型的「思考」模式每回合使用的 token 多约 70%,且在大多数等级上表现更差,47% 的回合没有给出答案,而不使用思考模式时为 35%,因此所有运行中都禁用了该模式。
💬 Key Quotes
我们想知道一个小型开放模型能否学会做好这件事。具体来说,目标是拿 Qwen3.5-9B,用强化学习训练它,直到它能像一个大得多的模型 DeepSeek-V4.1-Flash-1017 那样可靠地解决用时序逻辑编写的机器人规划任务,后者被我们用作参考(「教师」)。
只有 1% 的答案在规范的逻辑上失败;几乎所有的失败都是几何或时间上的计算错误。
借助工具,基础模型现在解决了 L1 的 0.98、L2 的 0.92、L3 的 0.76、L4 的 0.92、L5 的 0.62、L6 的 0.94、L7 的 0.66 和 L8 的 0.40(整体 0.67)。
分工正是失败分析所建议的:模型决定何时做什么(下一个区域、等待多久、避开什么),而工具负责几何、时间和验证。
📊 Article Meta
AI Screening: 88
Source: Hacker News - Newest: "LLM"
Author: sundw
Category: 人工智能
Language: 英文
Read Time: 23 min
Word Count: 5660
Tags:
AI 与智能应用 , 强化学习 , 具身智能 , 大语言模型 (LLM) , 阿里通义
看标题就点进来了,内容果然没让人失望。
赞同,实践出真知。
看标题就点进来了,内容果然没让人失望。
刚好最近在找这方面的资料,太及时了。
看标题就点进来了,内容果然没让人失望。
这个观点很中肯,深有同感。
路过
路过
这个比较实用,已转发给同事。
实话,说的不明不白
看标题就点进来了,内容果然没让人失望。
这篇文章分析得很透彻,收藏了!