Graph RAG 究竟在何时能产生价值?一次实操实验
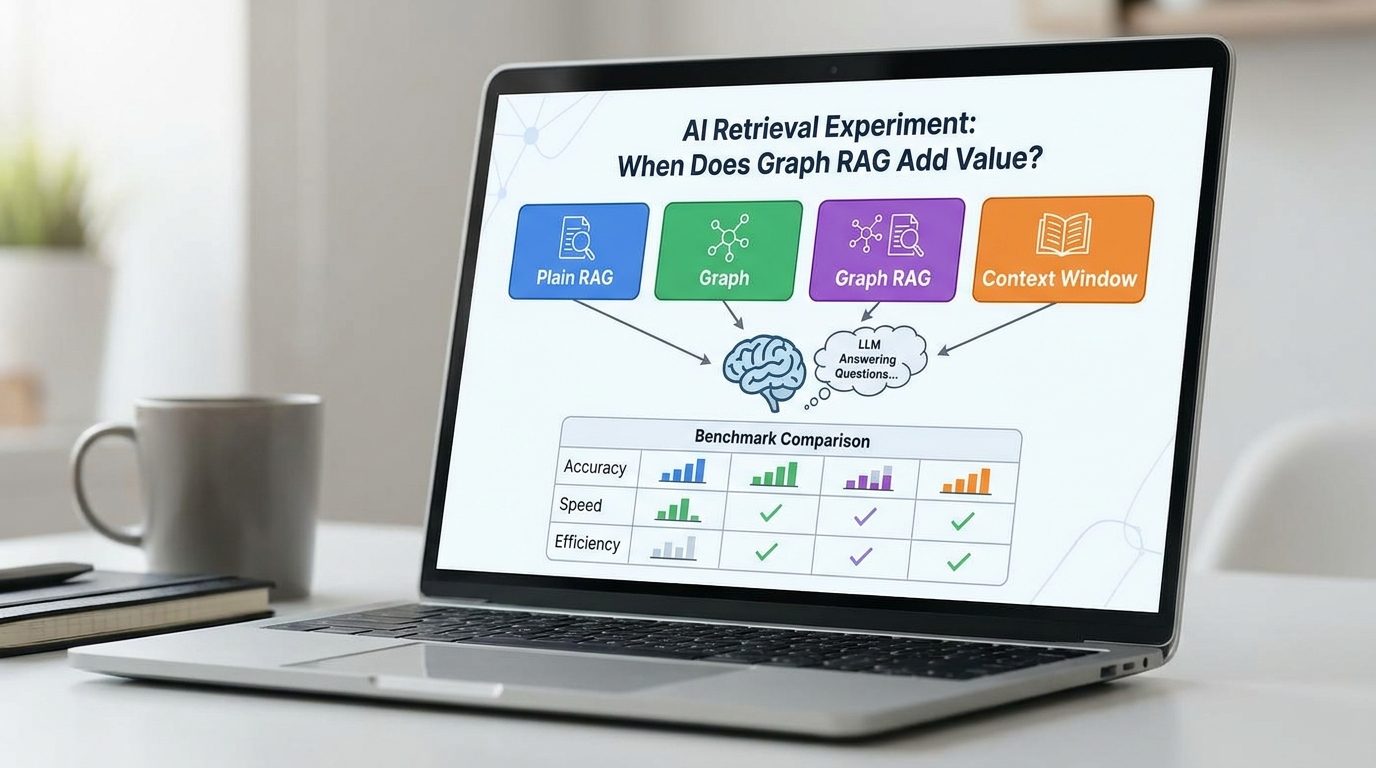
📌 One-Sentence Summary 通过在笔记本电脑上构建四种检索架构的实操实验发现,Graph RAG 在多跳推理问题上具有显著价值,但在覆盖率或溯源任务中表现一般;且当语料库能放入上下文窗口时,全上下文的前沿模型依然胜出。 📝 Summary 作者在个人笔记本电脑上构建了四种检索系统,并针对两份 Anthropic AI 安全文档和三个评估问题进行了基准测试。系统 A 是纯向量 RAG(500 字符分块,使用 all-MiniLM-L6-v2 嵌入,取前 5 个分块)。系统 B 是纯图检索(由 Phi-4 将「主体-关系-客体」三元组提取至 Neo4j,通过向量搜索锚点节点并进行两跳遍历)。系统 C 结合了上述两种管线。系统 D 则完全跳过检索,将两份文档直接传递给 Claude Haiku。Claude Haiku 根据准确性、完整性、推理能力和溯源能力对答案进行 1-10 分的评分。结果显示,前沿模型整体表现最强,但单题分析更具启发性:在将「四问题风险框架」与「SDLC 控制措施」相连接的多跳问题上,Graph RAG 明显优于纯 RAG;但在跨文档覆盖率问题上,Graph RAG 几乎没有优势,所有本地系统都未能检索到完整的共享控制措施集。在溯源问题上,纯图检索的表现几乎与前沿模型持平。作者得出结论:图结构有助于连接已检索到的概念,但无法解决检索覆盖率问题;且在语料库较小时,全上下文前沿模型仍是强力选项。 💡 Main Points Graph RAG 在需要连接跨文档概念的多跳推理问题上具有真实价值。 在问题 Q1(探讨四问题风险框架与 SDLC 安全控制措施的关系)中,纯 RAG 虽然检索到了相关分块,但无法自信地将两个来源连接起来,并承认无法确定答案。而 Graph RAG 将文本段落与提取的关系结构相结合,实现了基准系统无法完成的跨文档推理。 在挑战在于检索所有相关信息的覆盖率问题上,Graph RAG 几乎没有优势。 在问题 Q2(询问哪些控制措施同时出现在两份文档中)中,三种本地系统均未能识别出完整集合。纯图检索甚至引入了在两份文档中均未出现的控制措施。这说明局限性在于检索广度而非推理能力:由于只有部分分块、节点和关系进入了提示词,图结构失去了推理的基础。 缺乏 grounding 文本的纯图检索会导致幻觉,但在溯源问题上表现良好。 系统 B 缺乏原始文档文本,因此在 Q2 中用虚构的控制措施填补空白。但在 Q3(询问哪份文档引入了沙箱执行)中,它几乎与前沿模型持平,因为一旦定位到概念,图结构就拥有足够上下文来识别来源。 将全量语料放入上下文的前沿模型产生了最强的答案,但这仅是因为语料库足够小。 系统 D 直接将两份文档传递给 Claude Haiku,无需检索层,从而完全消除了检索误差并获得最高分。作者指出,当文档数量达到数百份时,这种方法将不再可行,届时检索架构将重新变得必要。 知识图谱的价值很大程度上取决于问题类型,而非架构本身的绝对优越性。 实验区分了「推理问题」(图结构有助于连接已检索概念)与「覆盖率问题」(检索广度和实体解析更重要)。作者建议增加检索广度或图遍历深度可以改善覆盖率结果,但这进一步证明了 Graph RAG 并不能消除检索本身的问题。 💬 Key Quotes 这凸显了推理问题与覆盖率问题之间的一个重要区别。图结构可以帮助模型连接它已经检索到的概念,但当主要挑战是确保每一条相关信息都被检索到时,它的效果较差。 Graph RAG 并不能消除检索问题。它在检索之上增加了结构和推理能力——但如果由于检索限制或相似度阈值,导致相关分块或图节点根本没有进入提示词,那么图结构就没有任何可以推理的内容。 虽然图结构可以告诉 LLM 哪些概念和关系是连接的以及如何连接,但如果没有原始文本,LLM 就缺乏准确回答所需的细节,从而用幻觉来填补空白。 更重要的观察是,在需要连接跨文档信息的问题上,Graph RAG 的表现大幅优于纯 RAG。这是实验中最清晰的例子之一,证明了图结构带来了真实价值而非仅仅是增加了复杂度。 这种方法整体表现最好,但仅是因为文档语料库足够小,能够舒适地放入可用的上下文窗口中。 📊 Article Meta AI Screening: 90 Featured: Yes Source: Towards Data Science Author: Arijit Ghoshal Category: 人工智能 Language: 英文 Read Time: 16 min Word Count: 3942 Tags: AI 与智能应用 , 知识图谱 , 上下文工程 , AI 工程 , RAG / 检索增强 Read Full Article
暂无评论,快来抢沙发~