Google Research 推出 AI 视频联合导演:4 个智能体框架实现连贯的分钟级视频生成
📌 One-Sentence Summary
Google Research 推出一套 AI 视频联合导演套件,包含 4 个智能体框架,将长视频生成视为全局优化问题,从而解决身份漂移和级联错误。
📝 Summary
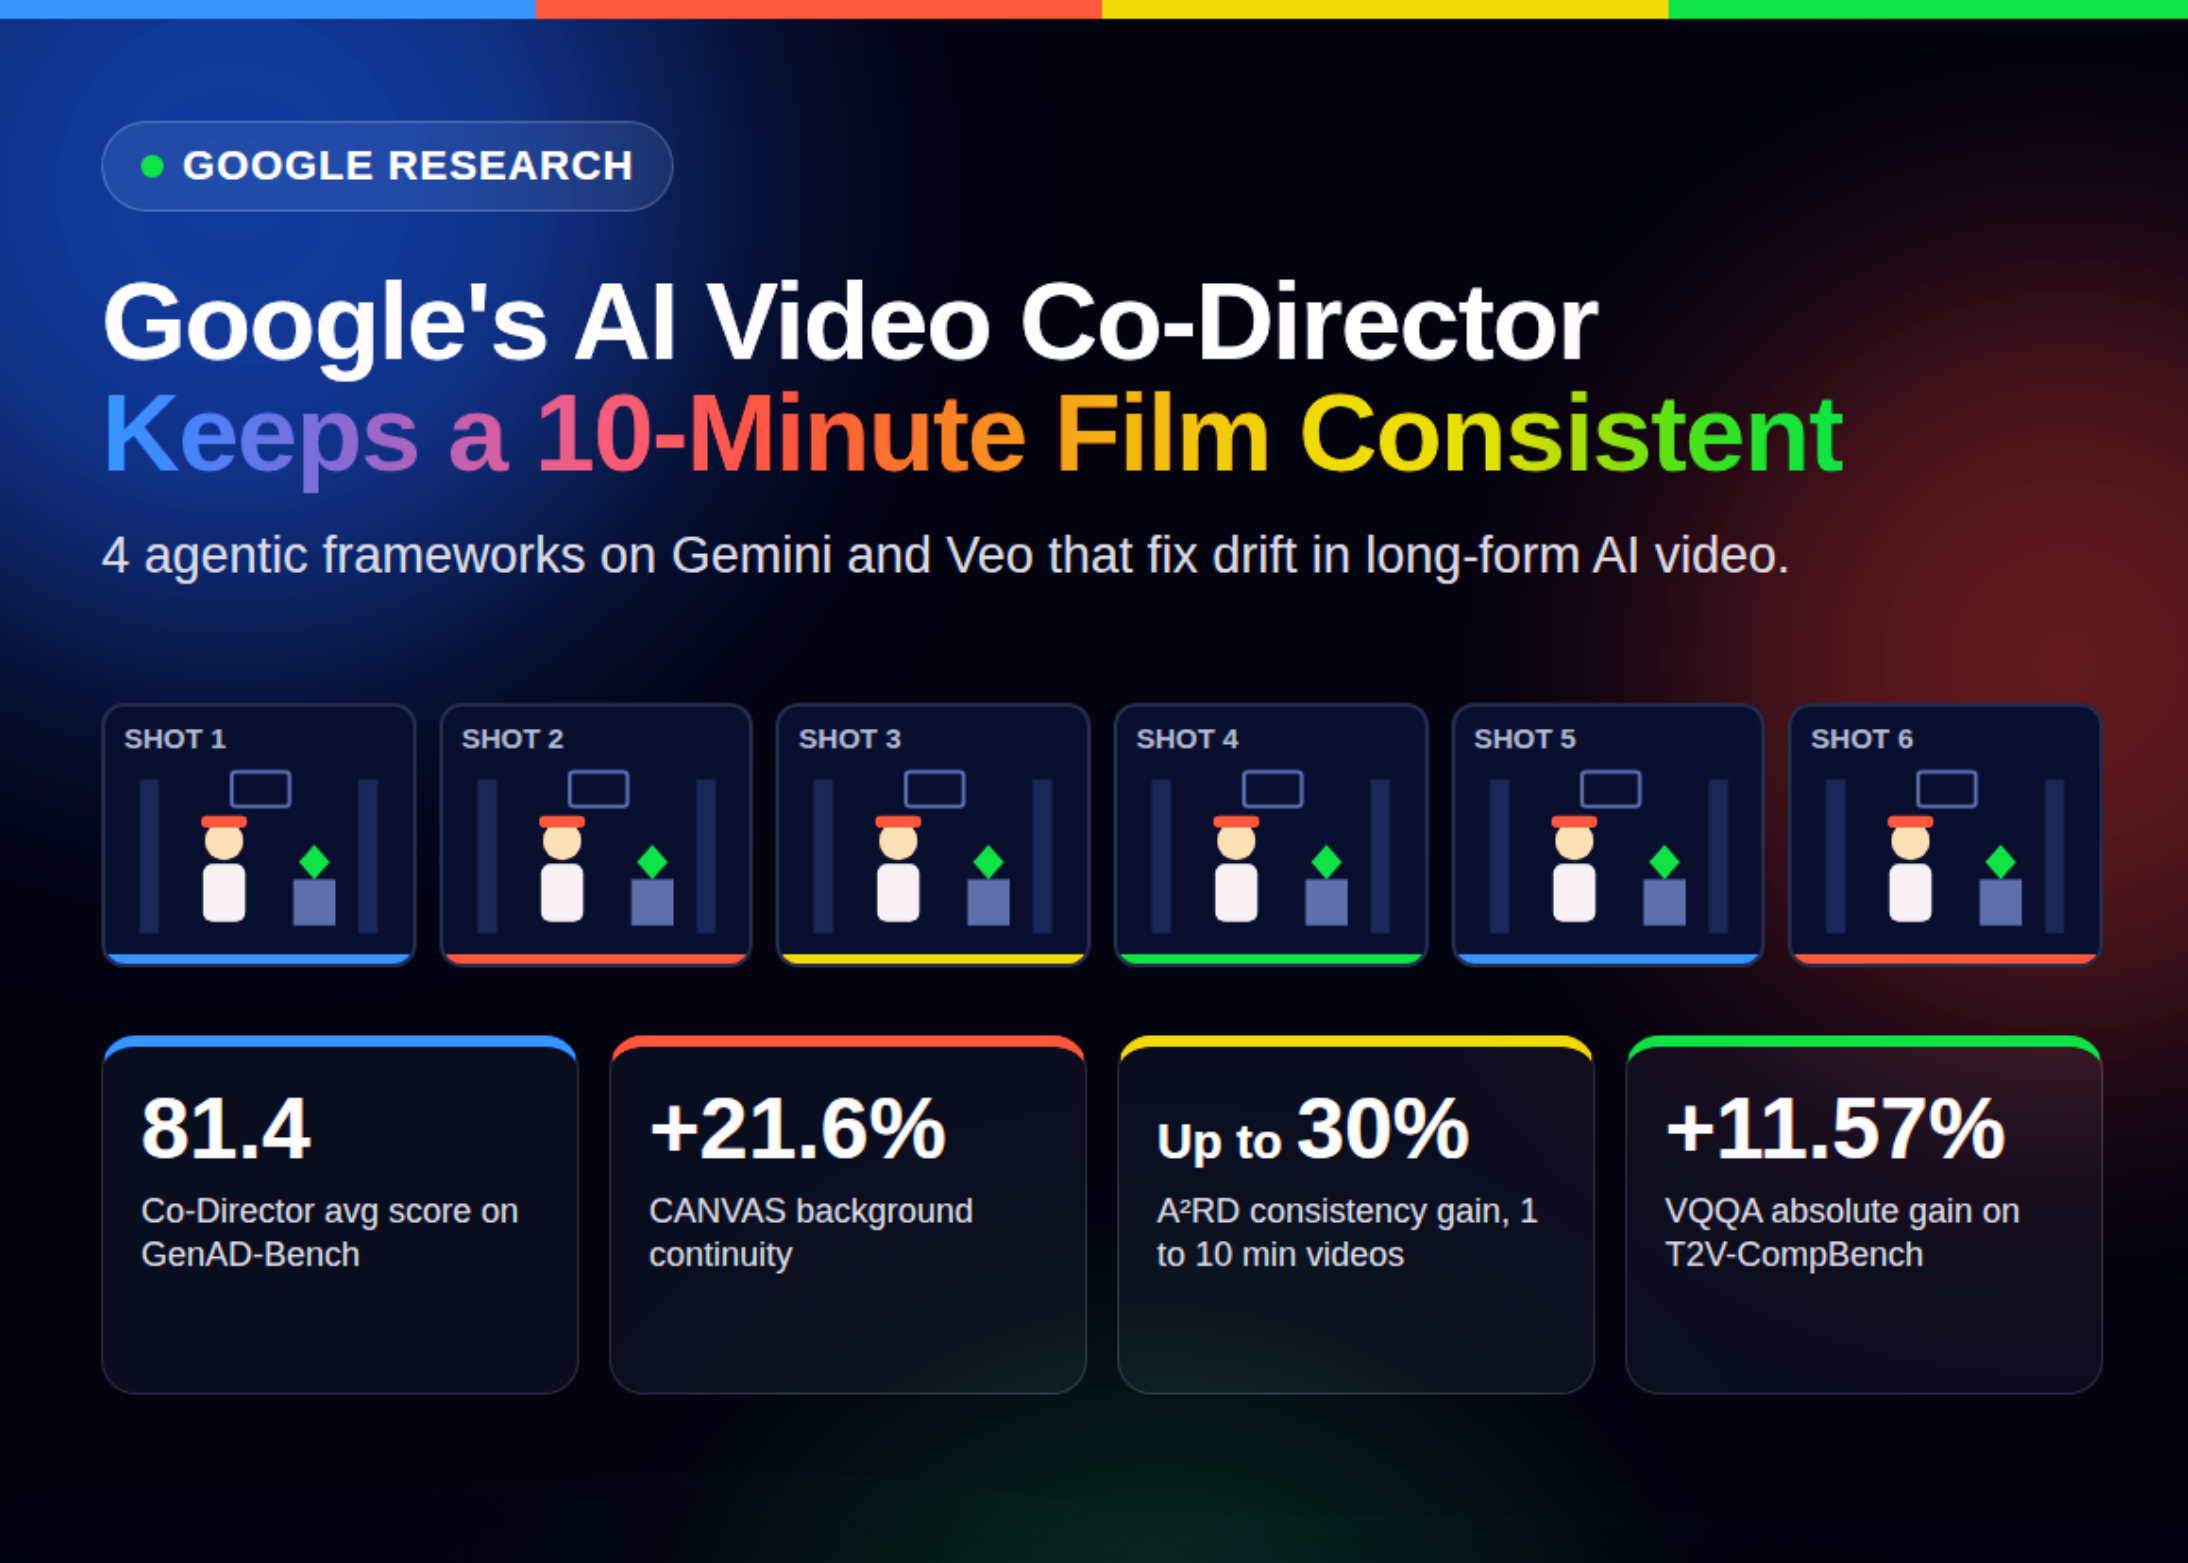
Google Research 发布了一套包含 4 个智能体框架的套件,旨在生成连贯的分钟级视频,解决当前扩散模型的局限,特别是语义漂移和级联失败。该系统作为模型无关的编排层运行在 Gemini 和 Veo 之上。它包括 Co-Director,通过多臂老虎机搜索进行创意规划;CANVAS,提供持久视觉记忆以保持角色和物体一致性;A²RD,通过多模态视频记忆进行逐段自回归扩散;以及 VQQA,利用视觉问答进行闭环提示词优化。基准测试显示,在连续性和叙事连贯性方面有显著提升,A²RD 成功生成了一部连续的 10 分钟影片。虽然部分代码已公开,但完整流程仍属研究原型,而非商业产品。
💡 Main Points
将长视频生成视为全局优化和世界状态追踪问题
Google 的方法不是将独立的提示词串联起来(这会导致语义漂移,例如服装变化)和级联错误,而是使用智能体来管理整个叙事弧线和视觉状态,确保镜头之间的一致性。
4 个专门的智能体框架覆盖制作的不同方面
Co-Director 通过老虎机搜索处理创意策略;CANVAS 为角色和道具维护持久视觉记忆;A²RD 通过外推/插值逻辑管理逐段生成;VQQA 通过视觉批评循环优化提示词。
在一致性和长度方面取得显著性能提升
GenAD-Bench 和 HardContinuityBench 等基准测试显示,与基线相比,一致性提升高达 30%,叙事连贯性提升 20%。A²RD 展示了生成具有稳定实体的连续 10 分钟影片的能力。
模型无关架构,部分开源可用
该框架构建在 Gemini 和 Veo 等现有生成器之上,但也能驱动其他生成器。Co-Director 和 A²RD 的代码已在 GitHub 上提供,而 CANVAS 尚待发布,表明这目前是研究工具而非成品。
💬 Key Quotes
它针对身份漂移和级联错误,这是当今大多数多镜头 AI 视频流程失效的 2 个原因。
Google 团队将此视为信用分配问题。一段损坏的最终视频很难追溯到导致它的提示词。
A²RD 制作了一部连续的 10 分钟影片,角色和场景保持稳定。
VLM 的批评充当「语义梯度」,重写文本提示词。
📊 Article Meta
AI Screening: 86
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 4 min
Word Count: 969
Tags:
AI 与智能应用 , 模型发布 , 多模态 AI , 世界模型 , AI Agent
暂无评论,快来抢沙发~