Google Research 开源 RRSI:可自我优化框架且不发生过度拟合的 AI 智能体
📌 One-Sentence Summary
Google Research 推出 RRSI,这是一个允许 LLM 智能体递归优化自身提示词、工具和工作流而不发生过度拟合的框架,确保性能提升能迁移至未见过的基准测试。
📝 Summary
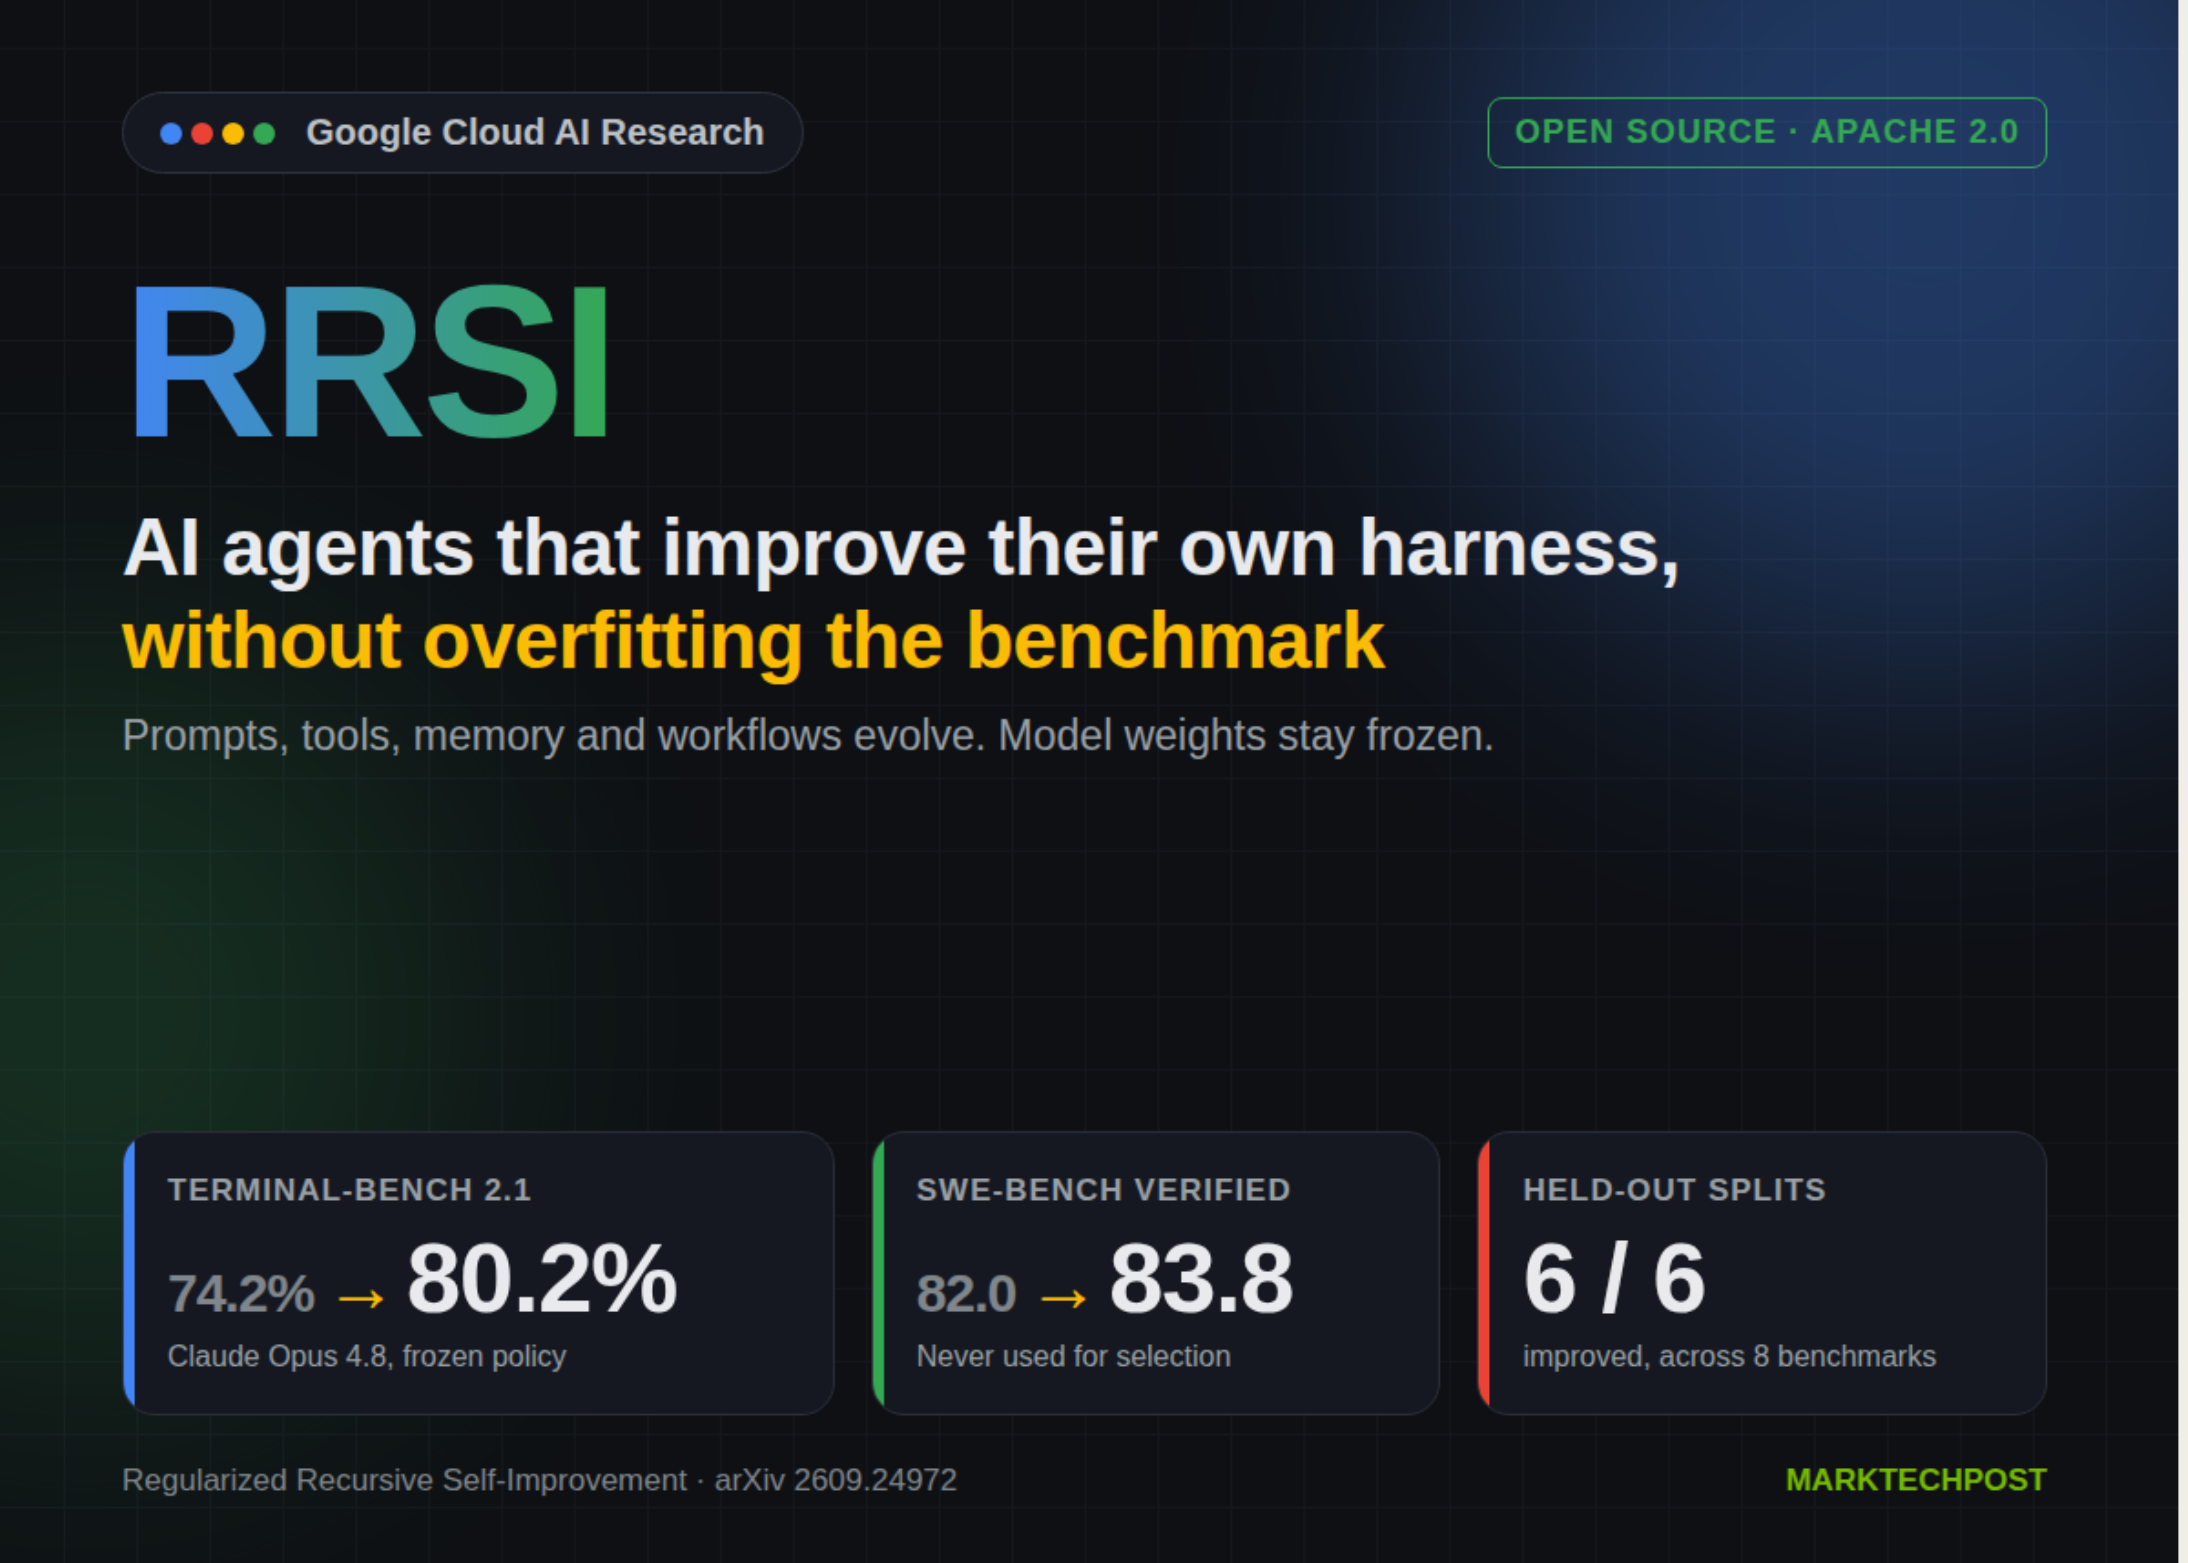
Google Research 联合多所大学开源了 RRSI(正则化递归自我改进)框架。该框架使 LLM 智能体能够在保持模型权重冻结的情况下,优化其自身的“运行环境”(Harness),包括提示词、工具、记忆和控制流。为防止常见的自我改进失败模式(如针对特定基准的过度拟合和噪声追逐),RRSI 实施了一系列正则化器:退火编辑预算、用于阻断基准特定逻辑的泄漏批评者、噪声调整后的性能下限,以及平衡 Token 使用量与收益的成本规则。在包括 SWE-bench Verified 和 Terminal-Bench 在内的八个基准测试中的实验结果表明,与其他运行环境进化方法相比,RRSI 实现了更优的分布外(OOD)泛化能力,同时将策略 Token 成本降低了约 30-36%。
💡 Main Points
解耦运行环境进化与模型权重
RRSI 专注于改进智能体的外部基础设施(提示词、工具和控制流),而非微调权重,这使得系统能够保持模型无关性,并兼容任何由 LiteLLM 支持的模型。
通过结构性正则化器缓解过度拟合
该框架采用「泄漏批评者」(Leakage Critic)以防止硬编码基准答案,采用「噪声调整下限」以确保增益具有统计显著性,并采用「成本规则」以防止低效且高 Token 消耗的改进。
通过退火编辑预算实现动态探索
RRSI 使用余弦调度,允许在早期轮次进行复杂的捆绑式编辑以发现新机制,而在后期轮次转向单一的、可归因的更改以实现精确细化。
已验证对分布外(OOD)任务的泛化能力
不同于可能在进化集上过度拟合的竞争方法,RRSI 在保留集划分以及 JobBench 和 GDPval 等 OOD 基准测试中显示出一致的性能提升,证明了其正则化方法的鲁棒性。
💬 Key Quotes
RRSI 约束的是改进循环本身,因此性能增益在智能体从未针对其进行优化的基准测试中依然有效。
研究团队将这些机制类比为经典的正则化器。编辑预算对应 L0 正则化,剪枝对应 Lasso (L1) 正则化,成本规则对应 Ridge (L2) 正则化。
RRSI 的进化增益最小,但它是唯一在 OOD 平均值上比 H0 高出 1 点以上的方法。
📊 Article Meta
AI Screening: 86
Source: MarkTechPost
Author: Asif Razzaq
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1141
Tags:
AI 与智能应用 , AI Agent , Agent编排 , 模型训练与推理 , 模型评测与基准
写得挺用心的,支持一下。