Google 发布 TPU Sync:面向 TPU 的开源 KV 缓存传输库
📌 One-Sentence Summary
Google 发布开源 C++ 库 TPU Sync,通过将 HBM、主机 DRAM、存储和网络视为统一的内存层级,大幅降低 Cloud TPU 上的 KV 缓存传输延迟。
📝 Summary
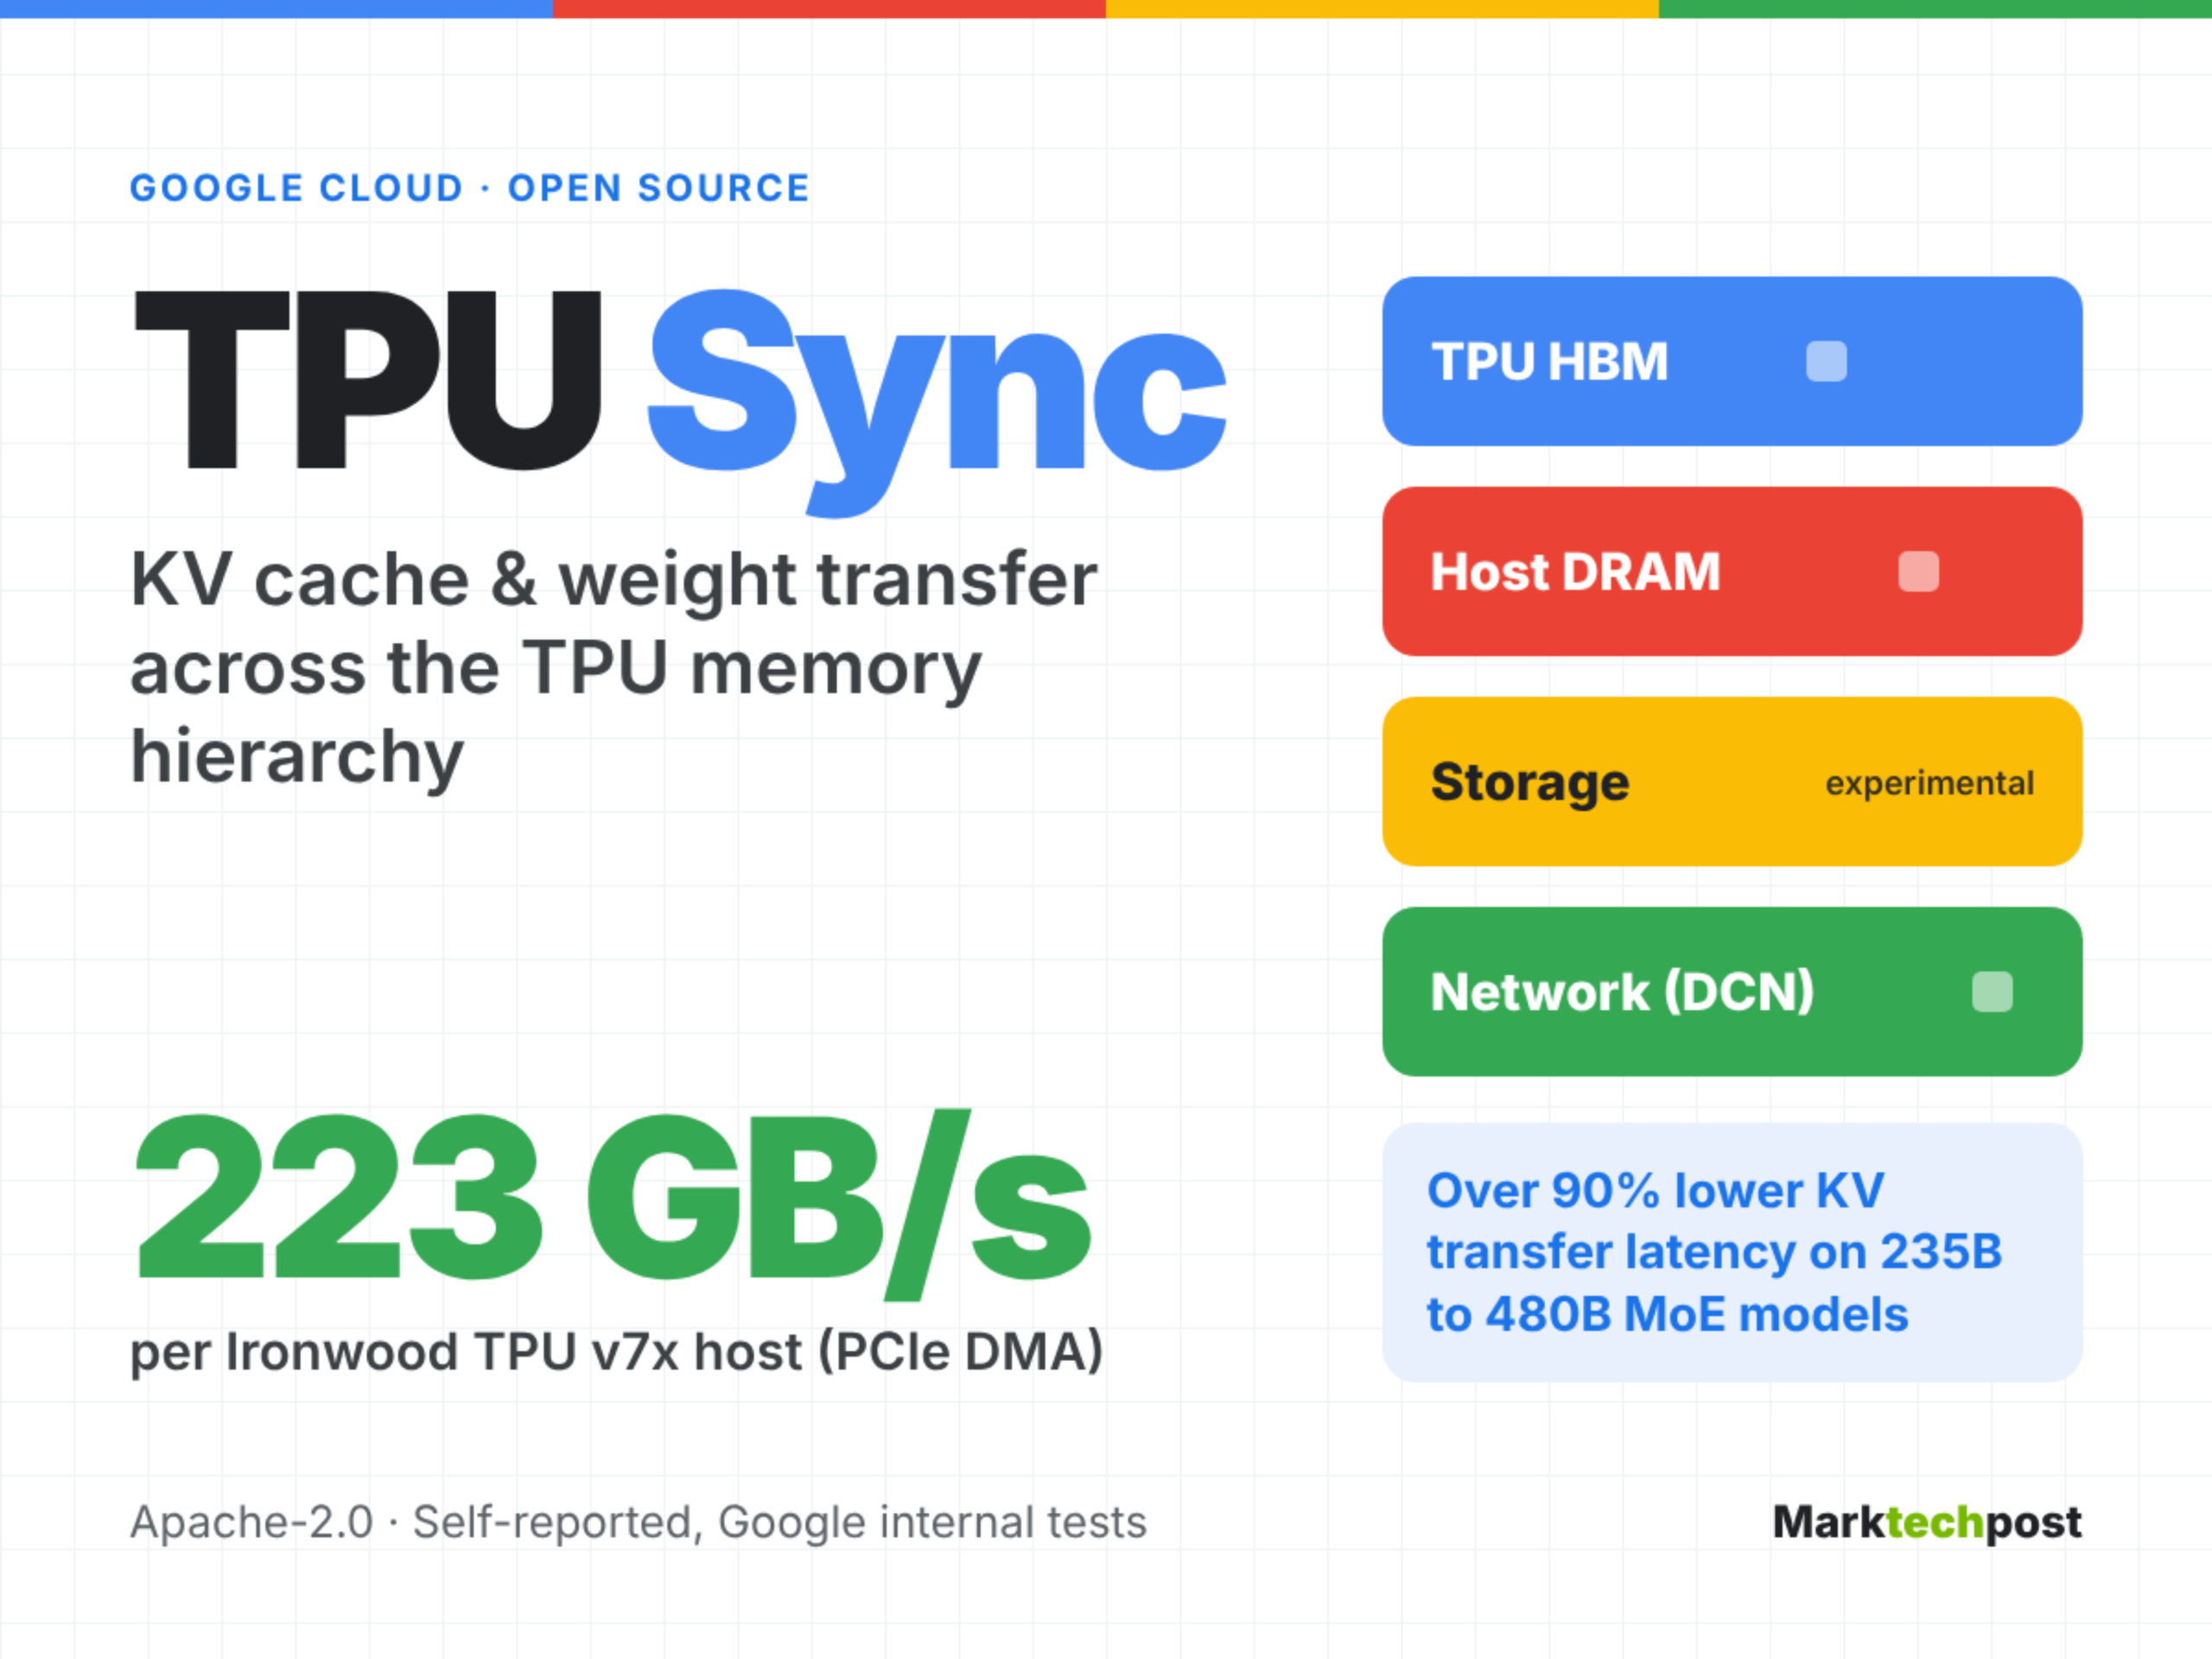
Google Cloud 发布 TPU Sync,这是一个基于 Apache-2.0 许可证的 C++ 库,旨在加速 Cloud TPU 上的 KV 缓存和模型权重传输。该库将 TPU HBM、固定页主机 DRAM、共享存储和数据中心网络视为统一的内存层级,并使用异步 DMA 传输 TPU 分块张量,无需经过 XLA 编译。TPU v7x 上的基准测试显示,对于 235B-480B MoE 模型,KV 传输延迟降低了 90% 以上;Qwen3 235B 的 KV 传输时间从数秒降至约 230 ms。它通过 TorchTPU 集成 PyTorch,并原生支持 JAX,为 vLLM-TorchTPU、SGLang-TorchTPU 和 llm-d 提供支持。该系统通过 PCIe Gen5 实现每台 Ironwood 主机最高 223 GB/s 的传输速度,通过 DCN 实现约 192 Gbps 的速度。不过,强化学习和存储分层功能仍处于实验阶段,所有性能数据均来自 Google 内部测试,且由 Google 自行报告。
💡 Main Points
TPU Sync 是用于 Cloud TPU 上 KV 缓存和权重传输的开源 C++ 库
该库基于 Apache-2.0 许可证,主要处理两项任务:推理期间传输 KV 缓存状态,以及在强化学习中将权重从训练器广播至采样器。它通过异步 DMA,在 TPU HBM、固定页主机 DRAM、POSIX 存储和 DCN 之间传输数据。
内部基准测试显示,KV 传输延迟和 TTFT 最高可降低 90%
在 TPU v7x 上,Qwen3 235B 的 KV 传输时间从数秒降至约 230 ms。在低并发情况下,235B 模型的平均 TTFT 降低 60%,480B 模型降低 90%;流量激增期间,token 吞吐量提升 30%-70%。
通过原生支持和适配器,与主流 LLM 服务框架集成
TPU Sync 通过 TorchTPU 支持 PyTorch,并原生支持 JAX。它在 vLLM-TorchTPU 中充当 KV 连接器,在 SGLang-TorchTPU 中作为 P/D 传输后端,并在 GKE 上的 llm-d 1.0 中作为前缀缓存亲和性路由器。
通过 PCIe Gen5 和 DCN 提供高带宽传输,并以 DMA 保留数据布局
每台 Ironwood 主机的传输速度最高可达 223 GB/s,达到 PCIe Gen5 的上限;单个网卡上的速度约为 192 Gbps,使用两个网卡时可达约 350 Gbps。直接 DMA 无需 Python 序列化,并能保留原生 TPU 分块布局。
💬 Key Quotes
TPU Sync 是 Google 推出的开源 C++ 库,通过异步 DMA 在不同内存层级之间传输 TPU 分块张量。
Google 报告称,在参数量为 235B 至 480B 的 MoE 模型上,KV 传输延迟降低了 90% 以上。
Qwen3 235B 的 KV 传输中位延迟从数秒降至约 230 ms。
通过直接且保留数据布局的 DMA,每台 Ironwood 主机的传输速度最高可达 223 GB/s。
📊 Article Meta
AI Screening: 85
Source: MarkTechPost
Author: Michal Sutter
Category: 人工智能
Language: 英文
Read Time: 5 min
Word Count: 1001
Tags:
AI 与智能应用 , AI 硬件与芯片 , 性能优化 , 模型训练与推理 , LLM 推理优化
这篇文章分析得很透彻,收藏了!
有没有更详细的教程,期待后续。
很有价值的分享,感谢整理。
实话,说的不明不白
支持作者,持续关注中。
思路清晰,干货满满。
很有价值的分享,感谢整理。
这个比较实用,已转发给同事。
实测过类似工具,作者说的基本属实。
支持作者,持续关注中。
这个观点很中肯,深有同感。
讲解得很细致,新手也能看懂。