Fin 对话 Linear:AI 质量不是测出来的,是看轨迹看出来的——智能体质量观测实操
一句话结论
Intercom Fin 产品团队的 Brian 与 Linear 工程师 Matias 在伦敦对谈「怎么把 AI 体验做出高质量」,核心结论反常识:智能体质量不是靠 A/B 测试和大盘指标优化出来的,而是靠精读单条执行轨迹(trace) debug 出来的——Linear 的零 bug 政策覆盖智能体错误,七天 内必须修复;Fin 的金标准是「硬解决率」(用户亲口确认问题解决),并发现给智能体加记忆功能反而让解决率掉了半个百分点。对正在做 AI 产品的团队,这 场对谈给了一套可以直接落地的质量观测工具箱:轨迹精读、智能体自报失败、三角色仿真测试、AI 自评 CX 分。
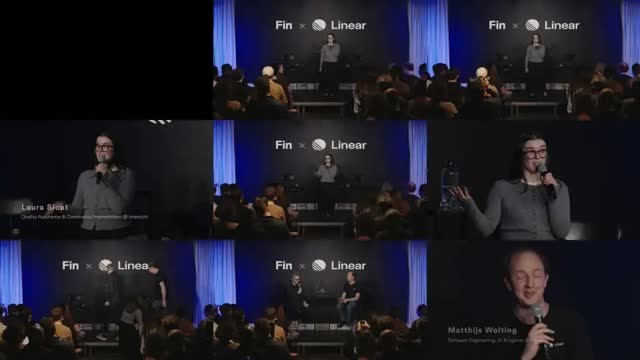
对谈背景与两位讲者
这是 Fin 在伦敦办的线下活动实录,全场约 50 分钟。主持人 Laura Secat 是 Fin 自己客服团队的质量保障与持续改进项目经理——一个专门为「AI 客服质量」设立的岗位,这个岗位本身就说明质量观测已经是独立的职能。Brian 在 Intercom 产品团队待了十二年,最近三年专注 Fin;Matias 是 Linear 的软件工程师,主要负责 Linear 智能体(Linear Agent)。两家的产品视角正好互补:Fin 是给企业客户用的 AI 客服,Linear 是给工程团队用的项目管理工具,但都面临同一个问题——智能体的输出不可预测,质量怎么管。
质量的定义:从「感觉」到「硬解决率」
Brian 开场就承认,AI 质量很大程度上是「氛围」——你把任务交给智能体,它稳定地按你预期完成,你就信它。但氛围不能管理,Fin 的做法是把质量拆成一组从硬到软的指标。
最硬的是「硬解决率」:不是系统判断对话结束了,而是终端用户亲口确认「这回答了我的问题」。这是最可靠的单项指标。往上一层是普通解决率(是否转人工),仍有一点含糊空间——用户可能默默走了。再往软的方向是 CX 分(客户体验分)和 CSAT,主观但站在终端用户视角。最上层是用大模型当裁判评幻觉率和指令遵循度——Brian 直言这类指标「超级难做准」。Fin 的规模优势在于可以拿这些指标当金基准跑 A/B 测试。
这里有个对任何 AI 产品团队都实用的警示数据:Fin 给智能体加记忆功能,第一次上线直接让解决率掉了 0.5 个百分点——按常识「智能体当然该有记忆」,但指标说不。他们的处置是:先下线,迭代后再上。「常识功能」也必须过金指标这一关,这比「功能上线即胜利」的团队强在有一票否决机制。

Linear 的反主流选择:零 A/B 测试,全靠精读轨迹
Matias 的表态会让数据驱动文化的公司意外:Linear 不是指标驱动文化,不做任何 A/B 测试。他们靠开发者直觉构建,再用「用户用得爽」确认。这个选择背后有个工程质量观:智能体的错误更像 bug 而不是指标偏差,debug 靠的是读单条轨迹,不是看聚合曲线。
Matias 描述了他的实际工作状态:有的日子花几个小时甚至半天盯着轨迹——看智能体做了什么、在 UI 里重放、改完提示词再看它怎么反应。这跟传统「看漏斗调转化」完全是两种手艺。他给了一个关键方法论:智能体犯错时,你要推理出「它为什么会这么理解」——像给智能体建心智模型。人类永远不会犯的那种错(比如把「别推荐联系客服」理解成「要推荐」)恰恰暴露了工具设计或指令的问题,修的工具而不是修模型。
Linear 把这个哲学制度化成了「零 bug 政策」:所有进入的 bug 七天内修复,这个标准同样适用于智能体错误行为。做不到的时候(模型能力不够)至少要搞清楚「我们哪里没说清楚」。给团队的直接可抄做法:把智能体错误当 bug 进缺陷跟踪系统,配 SLA,而不是当「模型波动」躺着不动。
反馈采集:让智能体自己报告做不到的事
两家在不约而同做同一件事:把内部工具外化给客户。Matias 分享了 Linear 的三个反馈通道。
第一个是选择性反馈:用户可以主动标记「这段特别好/特别糟」的对话,Linear 对隐私极敏感(默认不看用户数据),这个通道 opt-in 但信息量大。第二个信号更妙——持续使用本身就是正信号:很多人在用、没人关掉它。第三个是本轮对谈最值得抄的做法:让智能体自己报告「用户让我做但我做不到的事」。这等于把功能缺口探测自动化了——用户对智能体的期待天然超出产品边界,智能体把这些失败如实上报,产品团队就拿到了一张按真实需求排序的功能清单。
Fin 侧对应的实践是把内部评估工具给客户用:Brian 举了「程序」功能的例子——企业用程序来管理退款这类多步业务逻辑,怎么验证它工作正常?Fin 的答案是仿真测试:让一个大模型扮演指定人设的终端用户,跑完整个对话,再让另一个大模型当裁判按标准评分。三个角色(用户模拟器、被测程序、裁判)全是配置出来的 LLM,客户可以在上线前无限次回放。这套「合成对话+裁判」的测试法不依赖真实流量,任何做智能体工作流的团队都可以直接复刻。

信任的工程学:小爆炸半径与渐进放权
对谈中段两人把「信任」从口号拆成了工程参数。Matias 的框架:信任不是一个开关,而是「你信任它做什么」的渐进授权。Linear 的 triage intelligence(自动分派 bug 到正确团队、查重)先以建议模式跑,用户看到它持续给对建议,才会 opt-in 开自动化。判断依据是可靠性证据,不是厂商承诺。
Brian 从 Fin 侧补充了客户侧的信任旅程:Fin 用「参与率」(多少比例的对话开给了 Fin)做信任温度计,客户的信任是多年建立的,快慢差异极大。信任工具也是逐级加码:透明度(看见 Fin 干了什么)→ CX 分(替客户给所有对话打分)→ CX 分原因(下钻一层:这是产品问题还是支持问题还是政策问题)→ 完全自定义评分标准。Brian 透露一个组织观察:产品团队起初反对开放完全自定义(怕复杂度),但这恰恰保护了 rigor——自定义让客户用自己在意的方式评,反而比厂商单方面定的标准更能暴露问题。
对「智能体该不该有人监督」的问题,Matias 的回答很务实:监督程度是一条滑动标尺,取决于底层模型能力和你的代码库对智能体是否友好。有的客户已经完全放手,有的要求双重人工签字,都合理。趋势是监督对象从「逐行代码」变成「预览构建是否可用」——当模型写码质量稳定后,人看结果而不看过程。Brian 补了 Fin 的愿景:质量循环(发现异常→看轨迹定位→改配置→回放验证)里的每一步,未来只在少数节点需要人进来看一眼,其余全自动转。他形容这是「三到六个月内思维方式的天翻地覆」。
智能体的记忆短板与「记忆贴纸」策略
对谈里对「智能体记忆」的判断值得所有做智能体产品的人记录。Matias 的观察:智能体记忆目前非常不稳定——有时帮忙,有时因为记起无关上下文反而严重坏事。跟人类协作的差距在于:人类工程师读过你的代码库后会内化模式,智能体每次都要从零重来。
他给了一个精准的比喻:现在的做法像电影《记忆碎片》——给一个失忆的人浑身贴满便利贴,靠外部记录补偿记忆。短期内这是产品层能做的(把关键上下文写成技能、工具、文档喂给智能体),但长期希望模型层原生解决。Brian 补了另一面:Anthropic 明确说过别搭太多脚手架,因为下一代模型会把你的脚手架拆了——模型能力上来后,过度工程化的上下文注入反而挡路。两人的共识:在「贴便利贴」和「等模型进化」之间保持张力,每上一层模型就重新评估哪些脚手架该拆。这给选型者的启示:买智能体产品时问一句「你们的上下文策略是硬编码流程还是可随模型升级重配的」,后者在模型快速迭代期贬值更慢。

界面会死吗:两家给出的诚实答案
一位观众问了个尖锐的问题:我的团队三个月没人登录 Linear 了——站会录音转写、智能体建工单、Claude Code 配 MCP 跑循环匹配 PR。这对 Linear 是好事还是威胁?
Matias 的回答没有慌:必须假设智能体会成为 Linear 的一等公民用户,「为人构建的同时为智能体构建」。信息中枢仍然需要一个带界面的家(抽象层之上人还要看结果),但操作层大量转移到智能体。Brian 走得更远:Intercom 内部在自问「我们精心打磨的 UI 是不是已经成了遗产」,下一个大项目会更智能体驱动。他给了一个当下就能用的判断:基础的报告和列表界面会留存(消费结构化信息界面仍最强),但「连接东西」的配置类 UI 会被「说一句话让智能体做」大量替代。
对普通团队的落地建议:审视你产品里的界面,按「信息消费型」和「操作配置型」分成两类。前者的 UI 投资保值,后者逐步补 MCP/CLI 接口,让智能体能替用户执行——这是两家头部公司用行动投票的方向。
速度的悖论:太快反而失去信任
对谈中段出现了一个反直觉的用户心理发现,任何做对话式 AI 的人都该记下来。Brian 透露 Fin 在延迟(响应速度)上踩过的坑:按常识响应越快越好,但实测发现存在一个阈值——回答来得太快,用户反而不信任,「它怎么可能这么快就想明白了?」团队一度要认真考虑人为加一点延迟来匹配用户的心理预期,后来模型能力上来后方向又反转回来继续压速度。
这个发现的适用边界也很清楚:不同渠道对速度的容忍度完全不同。语音场景必须快,慢半拍体验就崩;聊天可以容忍稍等;邮件完全无所谓速度。给做 AI 产品的团队的启示:延迟预算要按渠道分别设定,且「快」不是无条件的 virtues——在信任尚未建立的早期交互里,过快的响应会被用户的心智模型解读为「敷衍」或「 canned response」。这与前面记忆功能的教训同构:直觉上的「显然更好」(更快、有记忆)都可能被真实的用户行为数据推翻,唯一的裁判是分渠道分层级的质量指标。

CX 分的工程化:从人工评价到 AI 评分
Brian 详细讲了一段「 CX 分」的进化史,这段内容对任何要给 AI 输出打分的团队都有直接的参考价值。起点是行业老问题:靠客户主动打 CSAT,回收率低得可怜,覆盖面远远不够。Fin 的思路是用 AI 给全量对话打分,训练素材是内部团队人工评价过的黄金数据集——注意不是终端用户的反馈,而是 Laura 这样的质检专家逐条评出的「什么是好」,再教 AI 对齐这套标准。
这条路在聊天渠道跑通之后,团队自然想复制到语音,结果撞墙:让大模型评估语音转写稿的质量,难度远超评估聊天记录,至今没有发布。Brian 用这个例子说明 AI 产品化的不可预测性——同一个方法换个模态,「有时比预期快得多,有时是一座要爬的山」。此外 Fin 还做了 CX 分的原因下钻:把差评拆成产品问题、支持问题、政策问题三类,因为责任方和修复路径完全不同。这个三级归因结构可以直接抄:任何 AI 输出质量的负反馈,先问是能力问题(模型/工具不行)、流程问题(指令/配置不对)还是业务问题(政策本身招人烦),拆开之后才能对症。
质量观测的开放问题:微改进怎么验证
观众问答里出现了一个两人都坦诚「没有好答案」的问题:智能体的微小改进怎么验证?修复影响 10 条对话的问题,统计上根本测不出来。
Fin 目前的过渡方案是回放测试:改完配置后,让模型对历史对话重跑一遍对比结果,相当于软件世界的回归测试。Laura 从质检角度补充:程序类(流程明确的)功能验证相对成功,因为预期结果清晰;开放对话则还是要人工重读。她同时给出了质检团队的实际工作量级——每天都要大量阅读被标记的对话和随机抽样的对话,被标记对话精读加随机样本巡查双轨并行,这个岗位强度说明「质量观测」在 Fin 的组织里是全职职能而不是兼职动作。
Matias 的收尾判断把整场对谈串了起来:识别智能体的行为模式更像「调查一个 bug」而不是「爬一座指标山」——聚合指标告诉你用户满不满意,但「为什么错、怎么修」永远要回到单条轨迹。他的原话是「你永远无法完全离开这个原子单元」——对话就是 Fin 的原子单元,工单就是 Linear 的原子单元,再多的自动化审查也只是把人往「最值得看的那几条」上引导。未来属于把「发现→定位→修改→验证」这个微循环自动化到极致的团队。

产品团队与 AI 团队的组织张力
对谈里藏着一个很少被公开讨论的组织问题,值得研发管理者注意。Brian 主动承认:Intercom 原本也不是指标驱动文化的公司,Fin 的 AI 团队壮大后带来了剧烈的文化冲撞——AI 组坚持「你不能凭感觉上线,必须过指标验证」,而传统产品组习惯客户驱动的直觉决策再用客户访谈验证。两家公司实际上演化出了两个并行研发组织:科学严谨派管智能体,直觉验证派管界面与体验,两套标准在同一个产品里共存。
这个张力没有标准答案,但两家的处理方式有共同点:把「必须测的」(影响用户钱的、有规模的、可回放的)交给指标文化,把「靠品味与手感」的(界面、品牌、早期探索)留给直觉文化,边界随产品成熟度移动。Matias 对应的做法是承认聚合指标的局限——智能体行为的问题「更像调查一个 bug 而不是爬一座指标山」,所以他保留了大工程量的人工精读。给正在组建 AI 团队的公司一个提醒:别急着全盘照搬任何一家的文化,先把「哪些决策错了可以回滚、哪些错了直接伤客户」分清楚,前者可以大胆用直觉,后者必须上指标与回放。

给 AI 产品团队的三条行动清单
第一,今天就给你的智能体加「失败自报」通道:用户请求了但智能体做不到的事,自动记录成结构化清单。这是成本最低、信号最真的需求发现器。
第二,把智能体错误纳入 bug 系统并配修复 SLA(Linear 是七天)。错误不再按「模型波动」豁免,按「可修复缺陷」对待,修不动时至少明确是「指令没说清」还是「模型不够强」。
第三,建立你的金指标分级:硬确认(用户亲口说解决了)> 行为指标(是否转人工)> 主观分(CX/CSAT)> LLM 裁判(幻觉率)。新功能一律过金指标再上,Fin 的记忆功能半个百分点回调就是这套纪律的价值证明。
值得记住的数字与事实
全场沉淀的可引用要点:Fin 记忆功能首次上线拉低解决率 0.5 个百分点后下线;Linear 零 bug 政策覆盖智能体错误、七天修复;Linear 不做任何 A/B 测试,工程师有时花半天精读轨迹;Fin 的三角色仿真测试(用户模拟器+被测程序+裁判)用于程序功能上线前验证;Fin 参与率作为客户信任温度计;两家都在把内部质量工具(轨迹检查、评分体系、仿真回放)产品化给客户;Fin 团队负责人要求团队在产品成熟前就想清楚岗位价值迁移方向,Linear 给用户提供的调试工具就是工程师自己日常在用的同一套。这些实践共同指向一个判断:2026 年 AI 产品的竞争力在质量观测基础设施,而不在模型调用本身。
原文信息
- 原视频标题:Fin x Linear: Delivering High Quality AI Experiences | London | March 2026
- 频道:Intercom(Fin 系列线下活动)
- 讲者:Brian(Intercom 产品团队,专注 Fin 三年)、Matias(Linear 工程师,Linear Agent 负责人);主持 Laura Secat(Fin 客服团队质量保障与持续改进项目经理)
- 发布日期:2026-04-09
- 视频时长:约 50 分 13 秒
有没有更详细的教程,期待后续。