ESMFold 药物靶点管线实战:30 个靶点从预测到贝叶斯调参的全链路追踪
一句话结论
这篇教程演示了一条单 GPU 可跑的蛋白质结构预测微调管线:ESMFold 对 30 个真实药物靶点(TP53、KRAS、CFTR、SPIKE 等)做序列到三维结构的预测与微调,全链路用 W&B 追踪——3D 分子面板、pLDDT 置信度、RMSD/TM 对比、贝叶斯超参扫描、Artifacts 版本与模型注册表。选 ESMFold 而非 AlphaFold 的理由很工程化:免 MSA、单序列即可、部署快、单卡可微调,代价是新折叠精度不及 MSA 方法——适合迭代速度优先的成熟靶点组合。
为什么是 ESMFold:速度与精度的工程取舍
蛋白质形状决定功能:KRAS 卡在「开」的状态细胞就失控分裂,CFTR 错叠就堵住囊肿性肺纤维化患者的肺。传统解析手段(X 射线晶体、冷冻电镜、NMR)贵且慢,AlphaFold 证明了深度学习可以从序列预测三维结构,但「能预测」到「可用的药物发现管线」之间还差一整套工程。
演示刻意选 ESMFold:单序列、免 MSA、跑得快、单 GPU 就能微调。代价是新折叠上精度仍落后 MSA 方法。对一组研究充分、迭代速度比极限精度更重要的药物靶点,ESMFold 是对的工具;绝对精度是硬约束时它不是替代品。
数据:30 个靶点,显式溯源
仓库用一个固定清单定义 30 个蛋白质,覆盖肿瘤、罕见病、传染病、代谢四类。每条记录有 UniProt accession(序列的权威 ID)与一句角色说明(如「GTPase」「氯离子通道」),人读机读两用。清单不是每次隐式重建——manifest 文件明确列出蛋白质、元数据与训练/评估切分,任何机器任何周跑的都是同一套定义,结果可比。
序列从 UniProt 拉取,参照 PDB 与置信度来自 AlphaFold Database API,Cα 坐标与逐残基 pLDDT 存成 .npy 供训练评估用。训练/验证切分用固定随机种子加置换,再写进 manifest.json——同样的脚本任何人重跑得到同样的切分。
第一阶段:基线推理,先记录开箱即用表现
改权重之前先记录零样本推理产出什么:PDB 文件、pLDDT 曲线、与 AlphaFold 参照对齐后的 RMSD 与 TM 分数。每次 run 记录模式、模型标识、序列长度上限与基础设施元数据(GPU 型号、集群)——这些是团队为审计和排查「这是哪个任务」时标准化的细节。
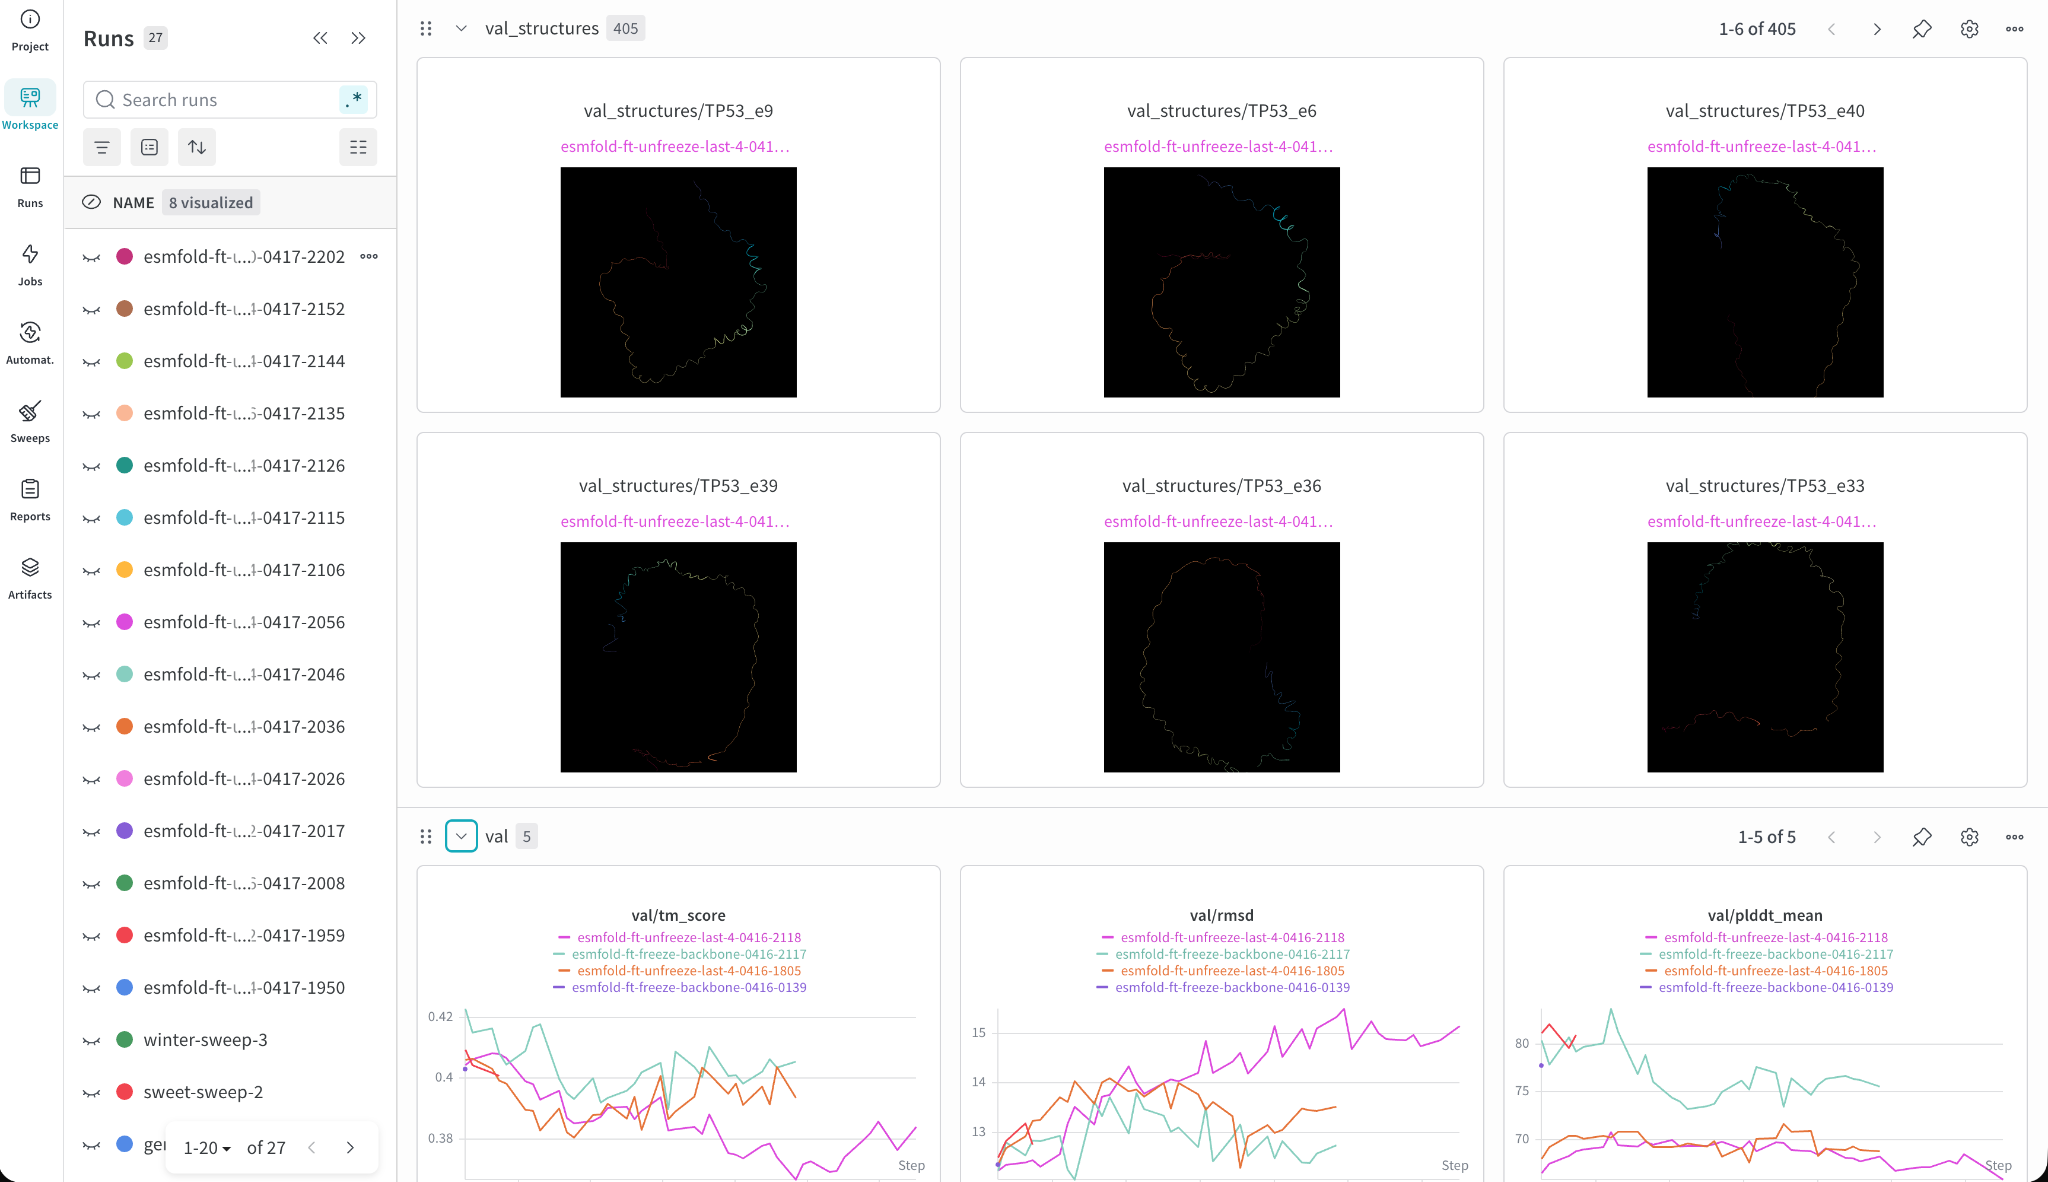
每个靶点写出一个预测 PDB,并记录交互式 3D wandb.Molecule、pLDDT 图、以及与参照的可选对比图与距离矩阵。

pLDDT 逐残基置信度图里,深蓝是高置信(>90),浅蓝中等(70-90),黄是低(<70)。
几何校验用成对 Cα 距离矩阵:ESMFold 预测与 AlphaFold 参照并排,非对角线模式吻合说明两者在长程接触上一致,而不只是局部摆对了位置。整个靶点组合还聚合成 W&B 表格:基因、治疗领域、角色、长度、置信度摘要、RMSD/TM——回答的是「整个靶点簿表现如何」,不只是一个 PDB。
第二到四阶段:冻结、部分解冻、产量旋钮
训练策略分三档推进。第二阶段保守:名字带 esm 的参数全冻,折叠主干与结构头训练、语言模型栈固定。第三阶段用 —unfreeze-backbone 开关进入部分解冻:先全冻,再放开主干相关模块与 ESM 栈最后 N 层(本配置 33 层),用 —unfreeze-layers 精确控制。
第四阶段是产量与质量的算力权衡:ESMFold 可回收中间预测,回收次数多质量常更好但更贵。代码里就是 model.config.num_recycles = args.num_recycles,回收数与学习率都上命令行,每个实验的配置都进 W&B 留档。
训练目标在 Kabsch 对齐后对齐 Cα,外加一项 distogram 损失,让优化推向全局一致的几何而不只是局部摆放。

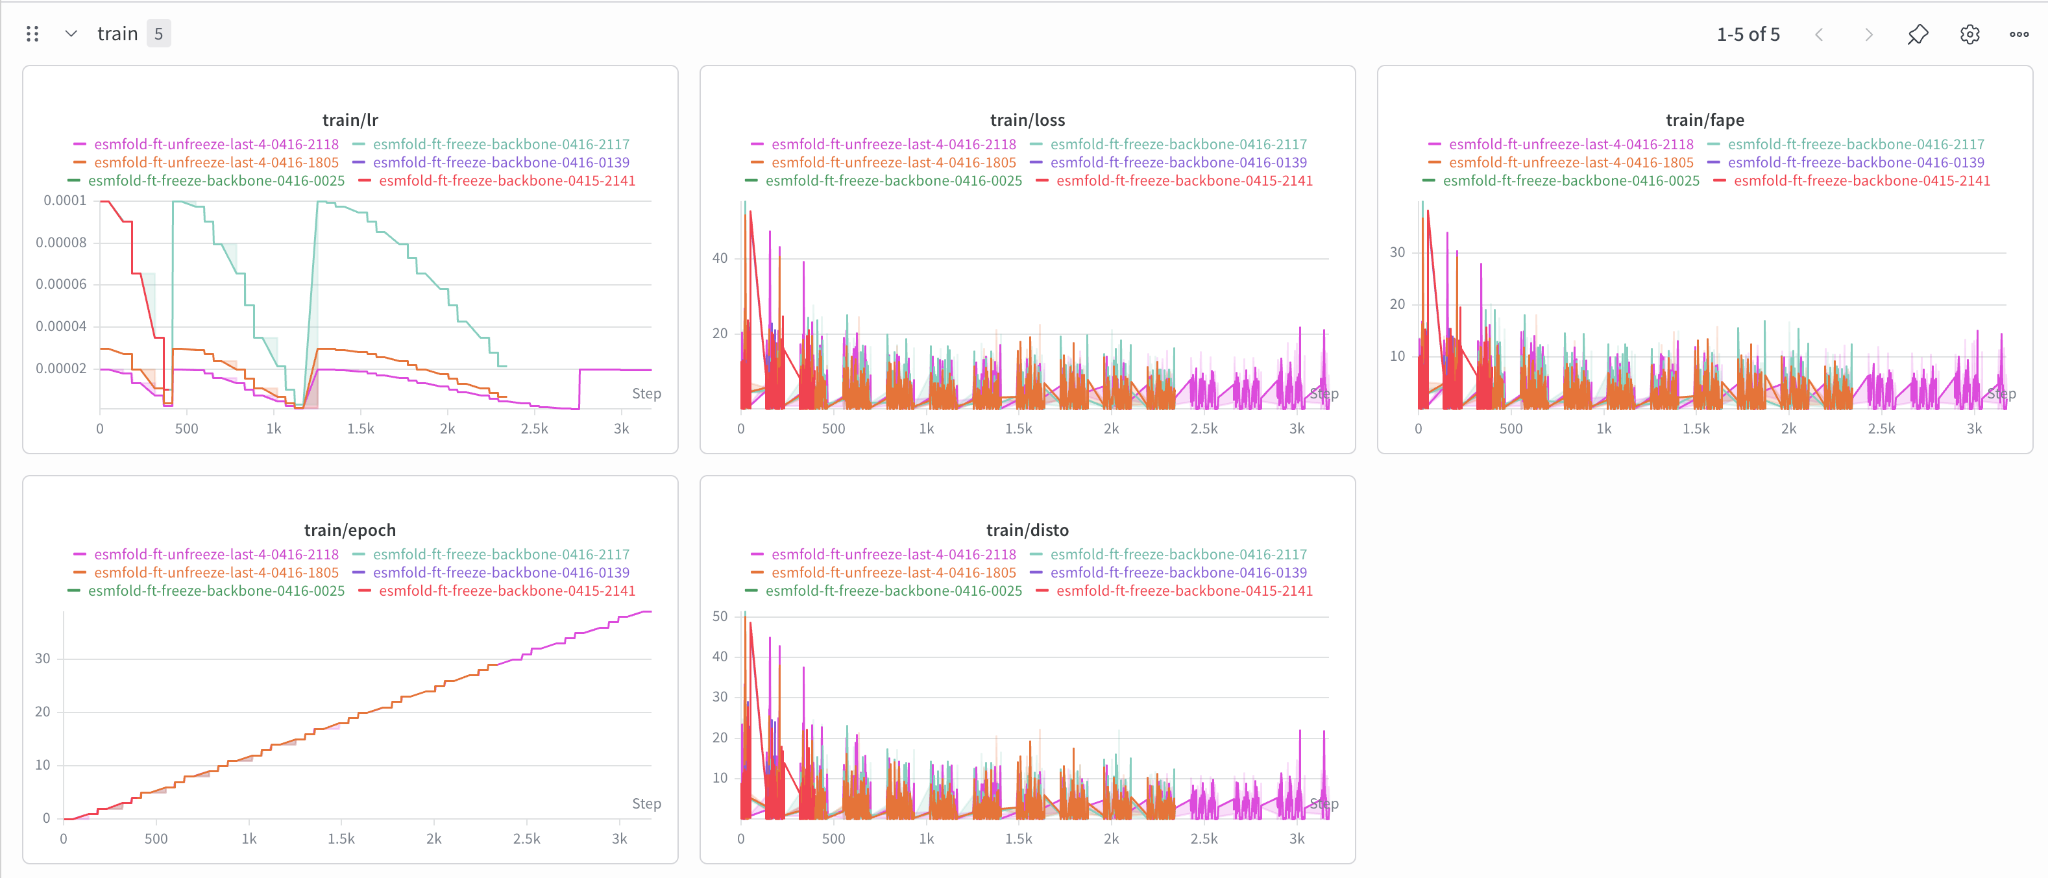
训练指标面板展示五次微调 run(冻结 vs 部分解冻策略)的逐标量曲线:学习率、fape、epoch、distogram——每个 checkpoint 背后的损失分量与调度一目了然。
贝叶斯扫描:搜索而非瞎猜
算力有限时,单独的驱动脚本定义了一个最小化 val/rmsd 的贝叶斯扫描,搜索空间覆盖学习率(对数均匀 1e-6 到 1e-3)、权重衰减、回收次数(1-4)、解冻深度(0/2/4/6 层)、裁剪长度(256/384/512),epochs 固定 6。

扫描总览的平行坐标图里每条线是一次试验、颜色代表 val/rmsd——深色线聚集穿过同一组超参格,就是下一轮扫描值得重做的组合。配套三视图:逐试验 val/rmsd 随时间、参数重要性与相关性、平行坐标,合起来回答哪些试验赢了、哪些超参驱动了胜利、胜点在搜索空间的哪里。
Artifacts 与模型注册表:从实验到可交付
验证指标改善时,训练脚本存 checkpoint 并记录带元数据(epoch、策略、验证均值)的 wandb.Artifact——实验变成可命名、可 diff、可晋升的版本化资产。注册表助手按验证 RMSD 排序完成的 run,把最优 artifact 链接进模型注册表集合,checkpoint 从文件路径变成有名字可交付的模型。
链入后别名分层叠上去:production 是要上线的版本,best 是排名第一的,staging 给候补。实现注意:公开仓库里 run_registry.py 按 tag 过滤 run,可能与训练脚本实际记录的 tag 不匹配——依赖自动晋升前,先把注册表脚本的过滤条件与训练任务实际记录的 tag 对齐,确保「最优 run」查询返回的确实是你要交付的那些。
结论
AlphaFold 重新定义了结构预测的可信度,但药物发现团队的下一层是系统:一致的数据、可比的指标、可视的证据、版本化的模型,以及从实验到「有名字、可交付」的产物的完整路径。这条管线对任何要做「多目标批量预测 + 微调 + 调参 + 交付」的 AI 团队都是可套用的骨架——把 ESMFold 换成你自己的基础模型,追踪结构原样保留。
原文信息
- 作者:Lorenzo Balderrama(Lorenzo-Team)
- 发布时间:2026 年 4 月 27 日 原文地址:
暂无评论,快来抢沙发~