堆叠能胜过你的最佳模型吗?
📌 One-Sentence Summary
只有当基础模型表现出不同的错误模式时,堆叠才能显着优于单一模型;否则,收益可以忽略不计,不值得付出计算成本。
📝 Summary
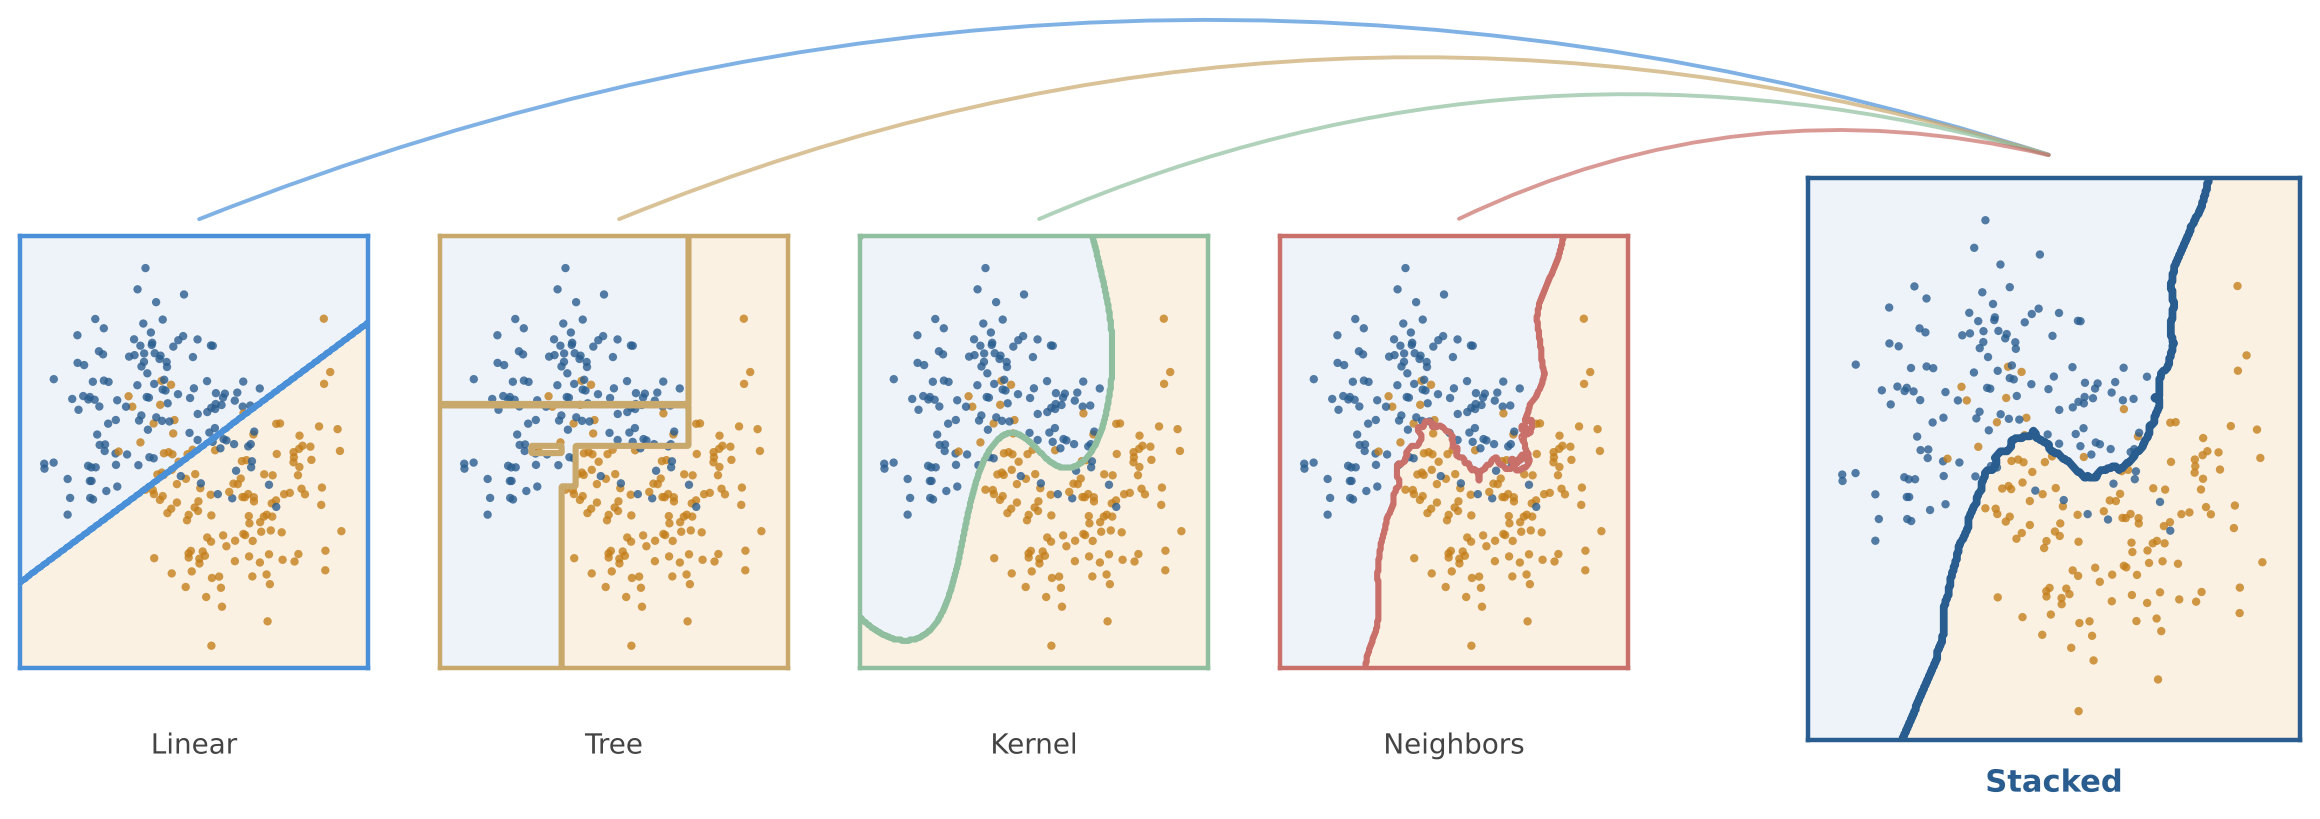
本文通过将模型堆叠与单一最佳模型和投票集成进行比较,来研究模型堆叠的有效性。它表明,当基础模型本质上不同时(例如,线性、树、SVM、KNN),堆叠会大幅提高准确率(0.830 vs 0.820);但当模型过于相似时(例如,三个基于树的变体),堆叠则无法改善性能(0.835 vs 0.834)。此外,投票集成始终表现不佳于单一最佳模型,这突出了元模型在学习组合权重时的重要性。
💡 Main Points
堆叠需要错误多样性才能有效。
在'多样化基础模型'条件下观察到的显著性能提升(0.830 vs 0.820)表明,当基础模型犯下不同类型的错误时,堆叠最有效,因为元模型可以利用它们互补的优势。在'相关基础模型'条件下,由于模型过于相似,堆叠的增益是统计学上不显著的(0.835 vs 0.834),这说明集成无法在错误模式没有足够差异的情况下超越单个最佳模型。
投票集成不如堆叠。
在两种实验条件下,投票集成(0.809 和 0.829)都一致地表现不佳于单个最佳模型(0.820 和 0.834)。这是因为投票将所有模型视为同等重要,没有考虑到单个分类器的相对质量或错误特点,而堆叠则会根据每个模型的性能学习最优权重。
堆叠的计算成本必须由其增益来平衡。
虽然堆叠可以提高准确率,但它也会带来显著的计算惩罚。在相关模型条件下,堆叠训练时间为 125.9 秒,而单个最佳模型仅需 3.6 秒。考虑到这种情况下的准确率提升可以忽略不计(仅 0.1 分),额外的计算成本是不划算的,因此,单一模型是更有效率的选择。
💬 Key Quotes
理论机制很具体,而不是模糊的:当基础模型犯下*不同*类型的错误时,它才会起作用。
在多样化的条件下,堆叠证明了自己的价值。0.830 相比单个最佳模型的 0.820——这是一个真实且有意义的差距。
在相关的条件下,堆叠的优势几乎消失了。0.835 相比 0.834——0.1 分的差异完全被任何一个数的标准差所吞没。
令人惊讶的是:在两种条件下,投票集成都表现出了低于单个最佳模型的水平。
📊 Article Meta
AI Screening: 88
Source: Towards Data Science
Author: Himanshu Sharma
Category: 人工智能
Language: 英文
Read Time: 6 min
Word Count: 1344
Tags:
AI 与智能应用 , Linear , 集成学习 , 模型堆叠 , 投票集成
暂无评论,快来抢沙发~